[Stanford CS146S #7] Automatisiertes Code-Review im großen Maßstab: AST-basierte Linter, Sicherheits-Taint-Analyse und autonome LLM-PR-Reviewer

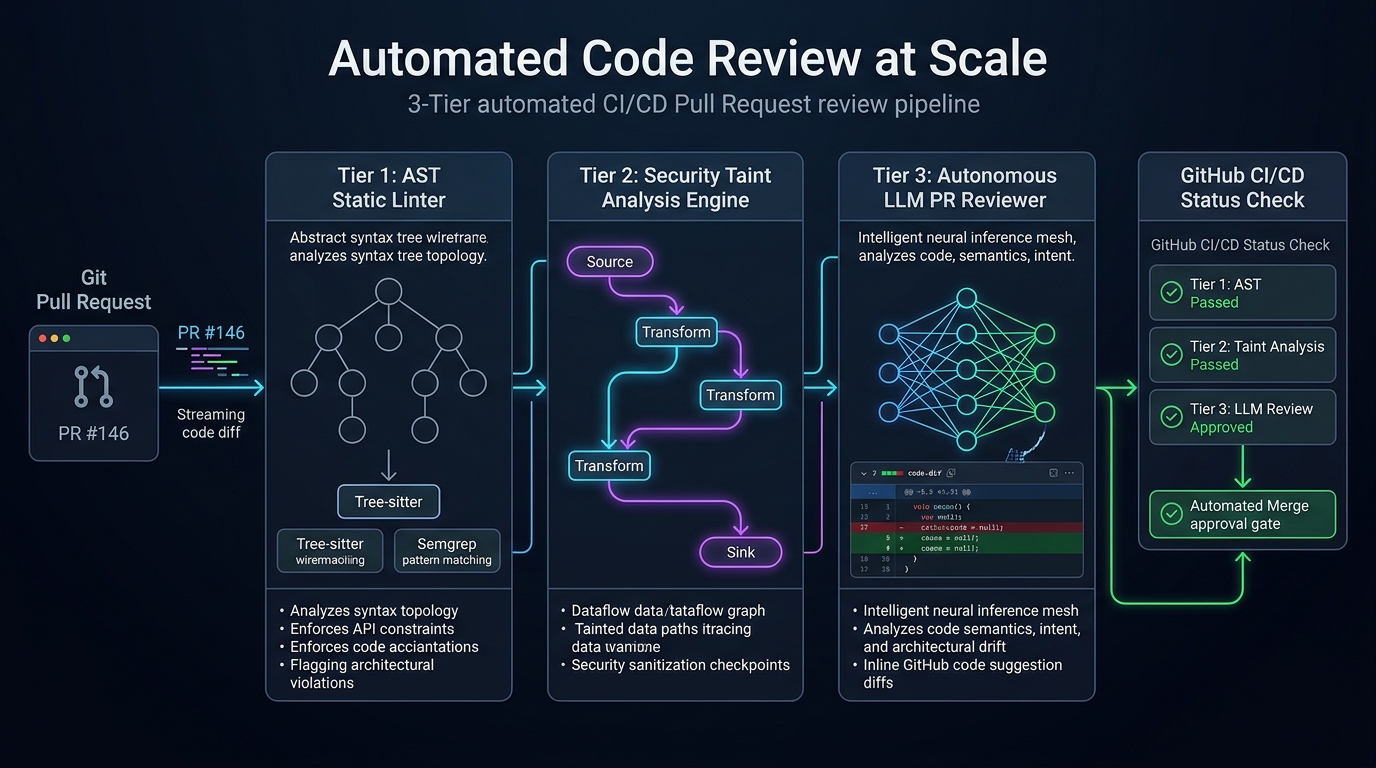
Willkommen zu Vorlesung 7 unserer technischen Analyse der Stanford-Vorlesungsreihe CS146S: The Modern Software Developer.
In der vorherigen Vorlesung behandelten wir die Behebung von Produktions-Incidents mittels eBPF und KI-SREs. Doch wie jede erfahrene technische Führungskraft weiß: Der kostengünstigste Fehler ist jener, der gar nicht erst in den Main-Branch gemergt wird.
In modernen Softwareorganisationen ist das Pull-Request-Code-Review (PR-Review) der zentrale Gatekeeper für Codequalität, architektonische Integrität und Sicherheit. Doch mit wachsenden Teams degeneriert das menschliche Code-Review oft zu einem massiven operativen Engpass. Senior Engineers verbringen 15 bis 20 Stunden pro Woche mit Diff-Inspektionen, ermüden bei stilistischen Kleinigkeiten (Bikeshedding) und übersehen bei riesigen 1.000-Zeilen-Änderungen aus Erschöpfung (Review Fatigue) kritische Concurrency-Races oder SQL-Injections.
In dieser Vorlesung präsentieren die Stanford-Dozenten den Bauplan für Automatisiertes Code-Review im großen Maßstab. Durch eine dreistufige Hierarchie aus AST-Lintern (Tree-sitter, Semgrep), statischer Taint-Analyse und autonomen LLM-PR-Reviewern lassen sich 90 % der manuellen Review-Mühen eliminieren und Sicherheitslücken zuverlässig stoppen.
1. Die Krise des manuellen Code-Reviews
Warum stößt das rein menschliche Peer-Review an Skalierungsgrenzen?
flowchart TD
    subgraph Review_Breakdown ["Die drei Kernprobleme menschlicher Reviews"]
        A1["Bikeshedding-Falle"] --> A2["Lange Diskussionen über Formatierung und Namenskonventionen"]
        A2 --> A3["Review-Latenz: PR liegt 3 Tage ungemergt wegen Formatierungs-Nitpicks"]

        B1["Kognitive Review-Ermüdung"] --> B2["10 Zeilen Diff: 10 kritische Kommentare.<br/>1.000 Zeilen Diff: 'LGTM' (Looks Good To Me)"]
        B2 --> B3["Sicherheitslücken entwischen unbemerkt in den Main-Branch"]

        C1["Kontext-Blindheit"] --> C2["Mensch prüft nur Diff-Ausschnitte, nicht den gesamten Aufrufgraphen"]
    end
2. Die dreistufige automatisierte Review-Hierarchie
Stanford schlägt eine klare Arbeitsteilung vor:
flowchart TD
    PR[Neuer Pull Request eingehend] --> Tier1["Stufe 1: AST-Linter (Tree-sitter / Semgrep)<br/>Laufzeit: < 2 Sek. | Deterministisch"]
    Tier1 -->|Syntax- oder Boundary-Fehler| Block1[PR sofort blockiert mit Inline-Fix]

    Tier1 -->|Bestanden| Tier2["Stufe 2: Inter-prozedurale Taint-Analyse<br/>Verfolgt Datenflüsse: Untrusted Input -> Sink"]
    Tier2 -->|SQLi / XSS / RCE Pfad erkannt| Block2[PR blockiert mit Taint-Graph]

    Tier2 -->|Bestanden| Tier3["Stufe 3: Autonomer LLM PR-Reviewer<br/>Semantische Absicht & Architektur-Drift"]
    Tier3 -->|Bestanden| Human[Finales menschliches Sign-Off]
- Stufe 1 (AST-Linter): Prüft Syntaxmuster und verbietet unsichere APIs deterministisch in Millisekunden.
- Stufe 2 (Taint-Analyse): Prüft, ob unvalidierte Benutzereingaben in kritische Ausführungssenken (SQL-Queries,
eval()) gelangen. - Stufe 3 (LLM PR-Reviewer): Bewertet semantische Logik, API-Vertragskonsistenz und Architekturschulden.
📌 Management Summary (3–5 Zeilen)
- Automatisierung gegen Ermüdung: Reines menschliches Code-Review scheitert bei großen Diffs an kognitiver Erschöpfung und Bikeshedding.
- Dreistufige Verteidigung: AST-Linter für Syntax, Taint-Analyse für Datensicherheit und semantische LLM-Reviewer für Architektur-Integrität.
- Drastische Latenzsenkung: 90 % der mechanischen Review-Schritte werden sofort im CI-Lauf abgearbeitet.
- Fokus auf Architektur: Menschliche Senior Engineers konzentrieren sich ausschließlich auf strategische Design- und Sicherheitsentscheidungen.
Referenzen & Kursmaterialien
- Offizielle Vorlesungs-Playlist: Stanford CS146S: The Modern Software Development (YouTube Playlist)
- Institution: Stanford University, Department of Computer Science