<?xml version="1.0" encoding="utf-8"?><?xml-stylesheet type="text/xsl" href="atom.xsl"?>
<feed xmlns="http://www.w3.org/2005/Atom">
    <id>https://globaldevlog.com/de/blog</id>
    <title>Global Dev Blog Blog</title>
    <updated>2026-11-02T00:00:00.000Z</updated>
    <generator>https://github.com/jpmonette/feed</generator>
    <link rel="alternate" href="https://globaldevlog.com/de/blog"/>
    <subtitle>Global Dev Blog Blog</subtitle>
    <icon>https://globaldevlog.com/de/img/favicon.ico</icon>
    <entry>
        <title type="html"><![CDATA[[Stanford CS329A #2] Test-Time Compute Scaling: Jenseits klassischer Skalierungsgesetze zur rechenoptimalen Inferenz]]></title>
        <id>https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws</id>
        <link href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws"/>
        <updated>2026-11-02T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Umfassende technische Analyse der Stanford CS329A Vorlesung 2: Inferenz-Rechenzeitskalierung (Inference-Time Scaling), pass@k-Wiederholungssampling (Large Language Monkeys), Snells rechenoptimale Allokation und Archon-Agenten-Pipelines.]]></summary>
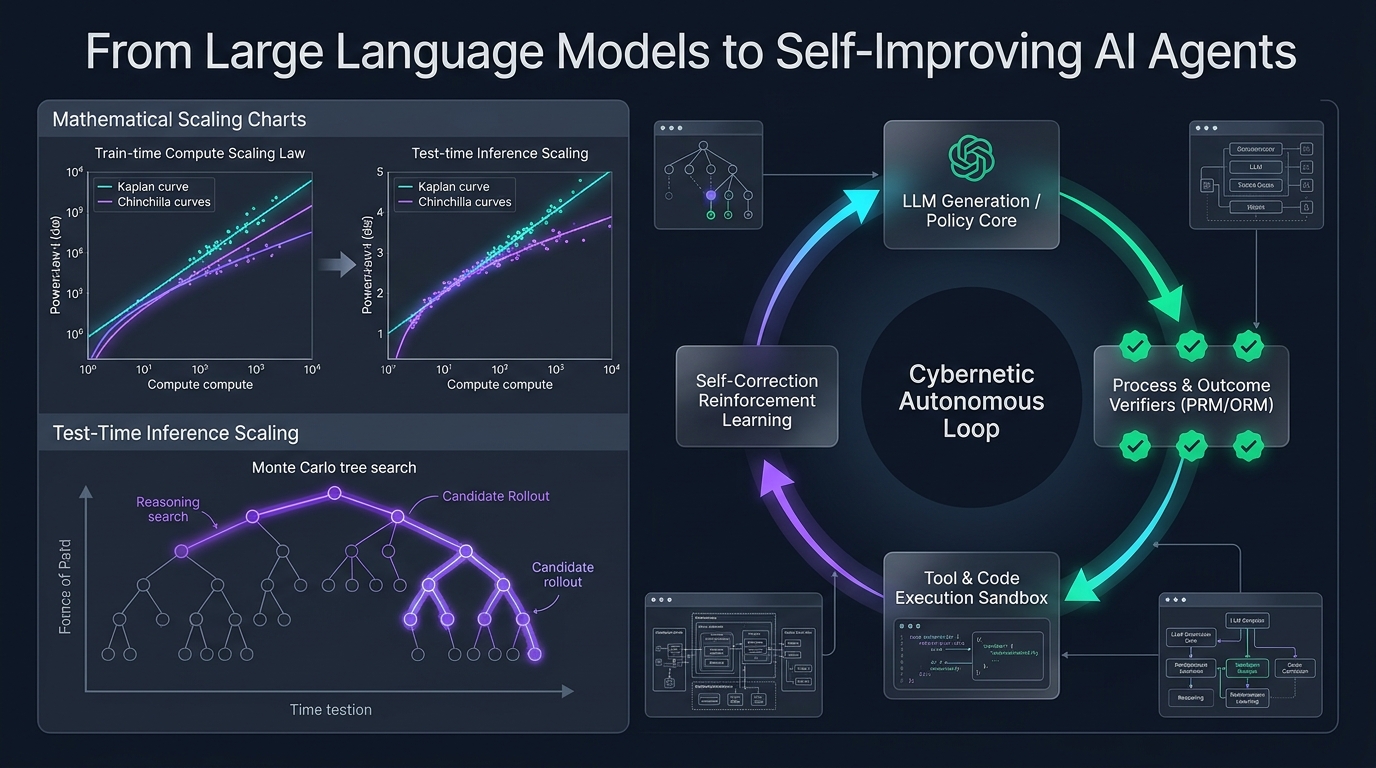
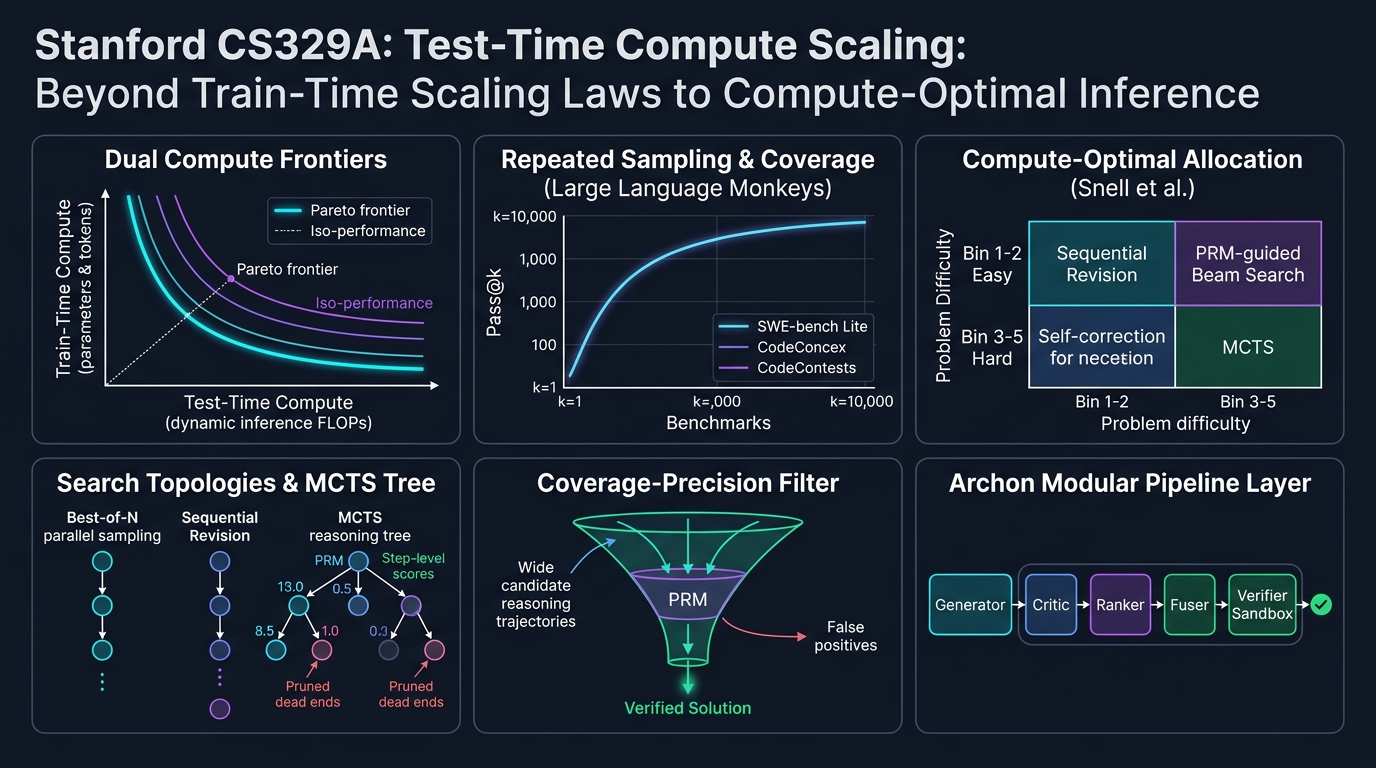
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Stanford CS329A Test-Time Compute Scaling" src="https://globaldevlog.com/de/assets/images/02_cs329a_test_time_compute_scaling-6949843569f379e704fee8bdcb8eaa09.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zum zweiten Teil unserer fundierten ingenieurwissenschaftlichen Analyse des Hauptstudiums-Kurses der <strong>Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025)</strong>.</p>
<p>In der Einführungsvorlesung haben wir den makroökonomischen Paradigmenwechsel von statischen autoregressiven Next-Token-Prädiktoren hin zu autonomen Agentenschleifen mit Umgebungs-Feedback nachgezeichnet. Heute widmen wir uns dem rechnerischen Fundament dieser Autonomie: <strong>Test-Time Compute Scaling (Skalierung der Rechenzeit während der Inferenz)</strong>.</p>
<p>Über ein halbes Jahrzehnt lang wurde die KI-Forschung von den Skalierungsgesetzen des Pre-Trainings beherrscht (Kaplan et al., Chinchilla): <em>massive GPU-Cluster aufbauen, die Modellparameter N in die Hunderte Milliarden treiben und zig Billionen Web-Tokens D verarbeiten</em>. Doch was geschieht, wenn wir uns nach dem Einfrieren der Modellgewichte θ weigern, eine hastige Greedy-Antwort innerhalb von 50 Millisekunden zu akzeptieren? Was passiert, wenn ein Agent stattdessen <strong>10 Sekunden, 1 Minute oder 10 Minuten investiert, um Argumentationsbäume zu explorieren, Zwischenschritte zu verifizieren und Hypothesen zu revidieren</strong>?</p>
<p>Anhand der bahnbrechenden empirischen Resultate von <em>Large Language Monkeys</em> (Brown et al., 2024), Snell et al.s <em>Compute-Optimal Scaling</em> (Stanford/UC Berkeley, 2024) und des modularen Archon-Architektur-Frameworks formalisieren wir mathematisch und systemtechnisch, wie der Austausch von Inferenz-FLOPs gegen Parameterkapazität die moderne KI revolutioniert.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph PreTrain ["Klassische Grenze: Skalierung der Trainingsrechenzeit"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        direction TB</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P1["Billionen Web-Tokens (D)"] --&gt; P2["Massive GPU-Cluster (C_train)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P2 --&gt; P3["Eingefrorenes dichtes Modell (θ)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3 --&gt; P4["Einmaliger Forward-Pass (O(1) fixe Inferenz)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph TestTime ["CS329A-Grenze: Skalierung der Test-Time-Rechenzeit"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        direction TB</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T1["Eingefrorene Basisgewichte (θ)"] --&gt; T2["Dynamische FLOP-Allokation während der Inferenz"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T2 --&gt; T3{"Adaptive Strategiewahl nach Schwierigkeit"}</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T3 -- "Geringe Schwierigkeit (Bin 1-2)" --&gt; T4["Sequenzielle Revision (Selbstkorrektur)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T3 -- "Hohe Schwierigkeit (Bin 3-5)" --&gt; T5["PRM-geführte Baumsuche (MCTS / Beam Search)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T4 --&gt; T6["Process Reward Model (PRM) Verifizierer"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T5 --&gt; T6</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T6 --&gt; T7["Mathematisch &amp; mechanisch verifizierte Lösung"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    PreTrain -.-&gt;|"Wendepunkt: Parametersättigung"| TestTime</span><br></div></code></pre></div></div>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-klassische-skalierung-vs-inferenzrechenzeit-der-paradigmenwechsel">1. Klassische Skalierung vs. Inferenzrechenzeit: Der Paradigmenwechsel<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#1-klassische-skalierung-vs-inferenzrechenzeit-der-paradigmenwechsel" class="hash-link" aria-label="Direkter Link zur 1. Klassische Skalierung vs. Inferenzrechenzeit: Der Paradigmenwechsel" title="Direkter Link zur 1. Klassische Skalierung vs. Inferenzrechenzeit: Der Paradigmenwechsel" translate="no">​</a></h3>
<p>Das moderne Deep Learning basiert auf der empirischen Erkenntnis, dass der Validierungsverlust als Potenzgesetz (Power Law) der Trainingsrechenzeit abnimmt:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">L(N, D) = E + A / N^α + B / D^β</span><br></div></code></pre></div></div>
<p>wobei N die Anzahl der Nicht-Embedding-Parameter und D die Größe des Datensatzes in Tokens darstellt. Diese klassische Formulierung behandelt die Inferenzrechenzeit jedoch als triviale, statische Konstante: exakt 2 FLOPs pro Parameter pro generiertem Token während des autoregressiven Decodings.</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-physikalischen-grenzen-der-trainingsskalierung">Die physikalischen Grenzen der Trainingsskalierung<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#die-physikalischen-grenzen-der-trainingsskalierung" class="hash-link" aria-label="Direkter Link zur Die physikalischen Grenzen der Trainingsskalierung" title="Direkter Link zur Die physikalischen Grenzen der Trainingsskalierung" translate="no">​</a></h4>
<p>Als die Industrie Modelle über 10^26 FLOPs (GPT-4-Klasse) hinaus skalierte, stieß das Pre-Training auf drei unüberwindbare Barrieren:</p>
<ol>
<li class=""><strong>Die Erschöpfungsgrenze menschlicher Web-Daten:</strong> Hochwertiger, von Menschen verfasster Text im Internet ist endlich (geschätzt auf ~10^14 Tokens). Das unkontrollierte Trainieren auf synthetischen Daten ohne deterministische Verifizierer führt zu Modellkollaps (Model Collapse) und Entropie-Degeneration.</li>
<li class=""><strong>Exponentiell explodierende Investitionskosten:</strong> Um die Benchmark-Genauigkeit am flachen Ende einer Potenzkurve um lediglich 1 % zu steigern, muss das 10-fache an Trainings-FLOPs investiert werden – was Hunderte Millionen Dollar an CAPEX erfordert.</li>
<li class=""><strong>Der Trugschluss des statischen Forward-Passes:</strong> Unabhängig davon, ob ein Modell 7 Milliarden oder 1 Billion Parameter besitzt, erzeugt das Standard-Decoding jeden Token t_i in einer festen Anzahl von Matrixmultiplikationen:</li>
</ol>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">t_i ~ Softmax( W_u · LayerNorm( h_L(t_{1:i-1}) ) )</span><br></div></code></pre></div></div>
<p>Komplexe NP-vollständige mathematische Beweise, Multi-File-Software-Bugs und formale Programmverifikationen lassen sich schlichtweg nicht in einem rein linearen Durchlauf ohne Backtracking, Hypothesenbildung und Zwischenprüfung lösen.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-rückkehr-des-infinite-monkey-theorems-large-language-monkeys">2. Die Rückkehr des Infinite-Monkey-Theorems: Large Language Monkeys<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#2-die-r%C3%BCckkehr-des-infinite-monkey-theorems-large-language-monkeys" class="hash-link" aria-label="Direkter Link zur 2. Die Rückkehr des Infinite-Monkey-Theorems: Large Language Monkeys" title="Direkter Link zur 2. Die Rückkehr des Infinite-Monkey-Theorems: Large Language Monkeys" translate="no">​</a></h3>
<p>In der klassischen Wahrscheinlichkeitsrechnung besagt Émile Borels <em>Infinite-Monkey-Theorem</em>, dass ein Affe, der unendlich lange zufällig auf einer Schreibmaschine tippt, mit an Sicherheit grenzender Wahrscheinlichkeit irgendwann die gesammelten Werke von William Shakespeare verfassen wird.</p>
<p>Ende 2024 untersuchten Forscher der UC Berkeley und von Google Research diese Hypothese an modernen Frontier-LLMs in ihrer Pionierarbeit: <strong>《Large Language Monkeys: Scaling Inference Compute with Repeated Sampling》</strong> (Brown et al., 2024).</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Coverage (Pass@k %)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> ▲</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">100│                                     ┌────────────── Theoretische Pass@k-Obergrenze</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 90│                                ┌────┘ (Erreicht 99 % bei MATH &amp; CodeContests)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 80│                           ┌────┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 70│                      ┌────┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 60│                 ┌────┘ ◄── SWE-bench Lite: DeepSeek-Coder-V2 (k=250 -&gt; 56.0%)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 50│            ┌────┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 40│       ┌────┘   ◄── Claude 3.5 Sonnet Einzellauf (43.0%)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 30│  ┌────┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 20│ ┌┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> 10│┌┘  ◄── Gemma-2B Pass@1 (0.02%)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  0└┴──────┬──────────┬──────────┬──────────┬──────────►</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    k=1    k=10       k=100      k=1,000    k=10,000   (Anzahl generierter Samples k)</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="mathematische-formulierung-des-unverzerrten-passk-schätzers">Mathematische Formulierung des unverzerrten pass@k-Schätzers<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#mathematische-formulierung-des-unverzerrten-passk-sch%C3%A4tzers" class="hash-link" aria-label="Direkter Link zur Mathematische Formulierung des unverzerrten pass@k-Schätzers" title="Direkter Link zur Mathematische Formulierung des unverzerrten pass@k-Schätzers" translate="no">​</a></h4>
<p>Werden N Lösungskandidaten unabhängig generiert, von denen exakt C Kandidaten eine automatisierte Test-Suite (z. B. Unittests) bestehen, ist der unverzerrte Schätzer mit minimaler Varianz (MVUE) für pass@k definiert als:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Pass@k = (1 / P) · ∑_{i=1}^P [ 1 - C(N - C_i, k) / C(N, k) ]</span><br></div></code></pre></div></div>
<p>wobei P die Gesamtanzahl der Aufgaben, C_i die Anzahl erfolgreicher Lösungen für Aufgabe i und C(n, r) den Binomialkoeffizienten bezeichnen. Um bei N = 10.000 Gleitkommaüberläufe zu verhindern, verwendet die Produktions-Pipeline folgende numerisch stabile Multiplikationsschleife:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Pass@k = 1 - ∏_{j=0}^{k-1} ( 1 - C_i / (N - j) )</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="empirische-durchbrüche-kompakte-modelle-schlagen-giganten">Empirische Durchbrüche: Kompakte Modelle schlagen Giganten<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#empirische-durchbr%C3%BCche-kompakte-modelle-schlagen-giganten" class="hash-link" aria-label="Direkter Link zur Empirische Durchbrüche: Kompakte Modelle schlagen Giganten" title="Direkter Link zur Empirische Durchbrüche: Kompakte Modelle schlagen Giganten" translate="no">​</a></h4>
<p>Die empirischen Resultate von Large Language Monkeys stellten traditionelle Evaluationsmetriken auf den Kopf:</p>
<ul>
<li class=""><strong>SWE-bench Lite (Reale GitHub Software-Engineering-Bugs):</strong>
<ul>
<li class="">Das Open-Source-Modell <code>DeepSeek-Coder-V2-Instruct</code> erzielte bei k=1 eine bescheidene Erfolgsrate von <strong>15,9 %</strong>.</li>
<li class="">Bei einer Erhöhung auf k=250 Samples katapultierte sich pass@250 auf <strong>56,0 %</strong>.</li>
<li class="">Dies übertraf das Ensemble aus GPT-4o und Claude 3.5 Sonnet (43,0 %) um <strong>überragende 13 Prozentpunkte</strong>.</li>
</ul>
</li>
<li class=""><strong>CodeContests (Komplexe Wettbewerbsprogrammierung):</strong>
<ul>
<li class="">Das leichtgewichtige Modell <code>Gemma-2B</code> wies ein pass@1 von nur <strong>0,02 %</strong> auf (praktisch null).</li>
<li class="">Bei einer Skalierung auf k=10.000 kletterte pass@10.000 auf <strong>7,1 %</strong> – eine <strong>355-fache Leistungssteigerung</strong> rein durch Inferenzrechenzeit.</li>
</ul>
</li>
<li class=""><strong>Die wirtschaftliche Umkehrung:</strong>
<ul>
<li class="">Das Erreichen von 29,62 % auf SWE-bench mit DeepSeek-Coder-V2 (k=5) kostete <strong>10,80 $</strong>.</li>
<li class="">Dagegen kostete ein Einzellauf von GPT-4o (24,0 %) <strong>39,00 $ (3,6-mal teurer)</strong>, und Claude 3.5 Sonnet (26,7 %) verbrauchte <strong>51,00 $ (4,7-mal teurer)</strong>.</li>
</ul>
</li>
</ul>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">┌───────────────────────────────┬──────────┬────────────┬─────────────┐</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ Modell &amp; Inferenzstrategie    │ SWE-bench│ Kosten ($) │ Multiplikator│</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">├───────────────────────────────┼──────────┼────────────┼─────────────┤</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ DeepSeek-Coder-V2 (k=5)       │ 29.62%   │ $10.80     │ 1.0x (Basis)│</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ GPT-4o (k=1 Greedy Einzellauf)│ 24.00%   │ $39.00     │ 3.6x Kosten │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ Claude 3.5 Sonnet (k=1)       │ 26.70%   │ $51.00     │ 4.7x Kosten │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ DeepSeek-Coder-V2 (k=250)     │ 56.00%   │ $540.00    │ Spitzenwert │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">└───────────────────────────────┴──────────┴────────────┴─────────────┘</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-coverage-precision-lücke-die-wand-des-verifizierers">Die Coverage-Precision-Lücke: Die Wand des Verifizierers<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#die-coverage-precision-l%C3%BCcke-die-wand-des-verifizierers" class="hash-link" aria-label="Direkter Link zur Die Coverage-Precision-Lücke: Die Wand des Verifizierers" title="Direkter Link zur Die Coverage-Precision-Lücke: Die Wand des Verifizierers" translate="no">​</a></h4>
<p>Wiederholtes Sampling ohne intelligente Selektion stößt jedoch unweigerlich an die <strong>Coverage-Precision-Lücke</strong>.</p>
<p>In geschlossenen, formalen Domänen mit deterministischen Orakeln (wie Compilern oder Unittests) gilt: <strong>Coverage ist gleich Erfolgsrate</strong>. Wenn 1 von 250 Trajektorien alle Unittests besteht, wird sie mechanisch isoliert.</p>
<p>In offenen oder informellen Domänen ohne externe Compiler verkehrt sich die Situation:</p>
<ul>
<li class="">Auf dem MATH-Datensatz erreichte <code>Llama-3-8B-Instruct</code> bei k=10.000 eine Coverage von <strong>98,44 %</strong> (in 98 % der Fälle war die richtige Lösung im Pool vorhanden).</li>
<li class="">Bei Anwendung von <strong>Mehrheitsabstimmung (Majority Voting)</strong> stieg die Genauigkeit jedoch nur von 40,5 % auf magere <strong>41,41 %</strong> (+0,9 %p).</li>
<li class="">Die <strong>Best-of-N-Auswahl</strong> mittels Outcome Reward Model (ORM) stagnierte bei ca. k=100 und scheiterte daran, die verbleibenden 57 % korrekter Lösungen aufgrund von Verifizierer-Rauschen und False Positives zu extrahieren.</li>
</ul>
<blockquote>
<p><strong>Ingenieur-Grundsatz:</strong> Einfach nur mehr Samples zu ziehen, ohne über einen präzisen Verifizierer zu verfügen, vergrößert lediglich den Heuhaufen. Selbst wenn die Nadel mit 99 %iger Wahrscheinlichkeit im Heuhaufen liegt, nützt dies nichts, wenn man keinen Magneten (Verifizierer) besitzt, um sie herauszuziehen.</p>
</blockquote>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-snells-rechenoptimale-skalierung-parameter-gegen-flops-tauschen">3. Snells rechenoptimale Skalierung: Parameter gegen FLOPs tauschen<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#3-snells-rechenoptimale-skalierung-parameter-gegen-flops-tauschen" class="hash-link" aria-label="Direkter Link zur 3. Snells rechenoptimale Skalierung: Parameter gegen FLOPs tauschen" title="Direkter Link zur 3. Snells rechenoptimale Skalierung: Parameter gegen FLOPs tauschen" translate="no">​</a></h3>
<p>Wie investiert ein Systementwickler ein festgelegtes Budget an Inferenz-FLOPs am effizientesten, anstatt blind 10.000-mal zu würfeln?</p>
<p>Ende 2024 veröffentlichten Charlie Snell, Jaehoon Seo, Hao Liu, Aviral Kumar und Sergey Levine (Stanford University &amp; UC Berkeley) die bahnbrechende Arbeit: <strong>《Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters》</strong>.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Snell_Framework ["Snells zwei Steuerhebel für Inferenzrechenzeit"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        direction TB</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        Knob1["1. Modifikation der Proposal-Verteilung"] --&gt; Sub1["Sequenzielle Revision (Schrittweise Selbstkorrektur)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        Knob2["2. Verifizierer-gestützte Suche"] --&gt; Sub2["Best-of-N / Beam Search / Lookahead-Baumsuche"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Allocation ["Schwierigkeitsadaptive Allokation"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        direction TB</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D1["Klassifikation der Aufgabenschwierigkeit"] --&gt;|Bin 1-2: Leicht| A1["100 % Rechenzeit in sequenzielle Revision"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D1 --&gt;|Bin 3-5: Schwer| A2["Rechenzeit auf PRM-geführte Beam Search bündeln"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Snell_Framework --&gt; Allocation</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-zwei-dimensionen-der-inferenzrechenzeit">Die zwei Dimensionen der Inferenzrechenzeit<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#die-zwei-dimensionen-der-inferenzrechenzeit" class="hash-link" aria-label="Direkter Link zur Die zwei Dimensionen der Inferenzrechenzeit" title="Direkter Link zur Die zwei Dimensionen der Inferenzrechenzeit" translate="no">​</a></h4>
<p>Snell et al. fassten alle Inferenzmethoden in zwei orthogonale Achsen zusammen:</p>
<ol>
<li class=""><strong>Modifikation der Proposal-Verteilung (Proposer):</strong> Das Modell wird konditioniert, durch sequenzielle Revision von vornherein qualitativ bessere Gedankengänge zu erzeugen:<!-- -->
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">y_{t+1} ~ P_θ( y | x, y_1, ..., y_t, Critique_t )</span><br></div></code></pre></div></div>
</li>
<li class=""><strong>Verifizierer-gestützte Zustandssuche (Verifier):</strong> Systematische Exploration von Zwischenschritten mithilfe von Process Reward Models (PRMs):<!-- -->
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Score(Node_t) = PRM_ψ( x, y_{1:t} )</span><br></div></code></pre></div></div>
</li>
</ol>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="das-umkehrprinzip-der-aufgabenadaptiven-allokation">Das Umkehrprinzip der aufgabenadaptiven Allokation<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#das-umkehrprinzip-der-aufgabenadaptiven-allokation" class="hash-link" aria-label="Direkter Link zur Das Umkehrprinzip der aufgabenadaptiven Allokation" title="Direkter Link zur Das Umkehrprinzip der aufgabenadaptiven Allokation" translate="no">​</a></h4>
<p>Die entscheidende Erkenntnis des Stanford-Berkeley-Teams war, dass <strong>die optimale Strategie je nach Schwierigkeitsgrad der Aufgabe exakt invertiert</strong>:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Schwierigkeit Bin 1-2 (Leichte Aufgaben) ───&gt;  Sequenzielle Revision dominiert</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">Schwierigkeit Bin 3-5 (Schwere Aufgaben) ───&gt;  PRM-geführte Beam Search dominiert</span><br></div></code></pre></div></div>
<ol>
<li class=""><strong>Leichte Aufgaben (Bins 1–2):</strong>
<ul>
<li class="">Bei einfachen Aufgaben liegt bereits der erste Versuch des Basismodells nahe an der korrekten Lösung.</li>
<li class="">Der Einsatz komplexer Baumsuchen fügt hier lediglich Verifizierer-Rauschen hinzu, was zu Überoptimierung (Over-optimization) und Fehlentscheidungen führt.</li>
<li class=""><strong>Optimale Strategie:</strong> Die sequenzielle Revision (Aufforderung an das Modell, Tippfehler oder Vorzeichenfehler zu beheben) erreicht maximale Genauigkeit bei minimalem Rechenaufwand.</li>
</ul>
</li>
<li class=""><strong>Schwere Aufgaben (Bins 3–5):</strong>
<ul>
<li class="">Bei extrem anspruchsvollen Mathematik-Wettbewerbsaufgaben scheitert lineare Selbstkorrektur, da der initiale Lösungsweg in eine irreversible Logikfalle geraten ist.</li>
<li class=""><strong>Optimale Strategie:</strong> Beam Search, geführt von einem schrittweisen PRM, schneidet fehlerhafte Gedankengänge frühzeitig ab.</li>
</ul>
</li>
<li class=""><strong>Die Recheneffizienz-Dividende:</strong>
<ul>
<li class="">Eine adaptive Richtlinie, die leichten Aufgaben Revision und schweren Aufgaben PRM-Beam-Search zuweist, erreicht dieselbe Genauigkeit wie Best-of-N bei einem <strong>um das 4-Fache geringeren Rechenaufwand (4x Ersparnis)</strong>.</li>
</ul>
</li>
</ol>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-14x-parameter-äquivalenz">Die 14x-Parameter-Äquivalenz<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#die-14x-parameter-%C3%A4quivalenz" class="hash-link" aria-label="Direkter Link zur Die 14x-Parameter-Äquivalenz" title="Direkter Link zur Die 14x-Parameter-Äquivalenz" translate="no">​</a></h4>
<p>Der spektakulärste Vergleich in Snells Untersuchung war das Duell: <strong>Pre-Training-Parameter um das 14-Fache vergrößern</strong> gegenüber <strong>einem kleinen Modell das 14-Fache an Inferenzrechenzeit bereitstellen</strong>:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Modell mit 14x Parametern (Greedy Decoding)   vs.   1x Basismodell + 14x Inferenzrechenzeit</span><br></div></code></pre></div></div>
<ul>
<li class="">Bei leichten bis mittelschweren Aufgaben auf MATH und GSM8K zog das kompakte Modell mit optimaler Inferenzrechenzeit mit dem 14-mal größeren dichten Riesen gleich oder übertraf diesen sogar.</li>
<li class="">Bei extremen Aufgaben (Bin 5) blieben die vortrainierten Parameter jedoch unersetzlich: Wenn dem Basismodell die elementare semantische Repräsentation zur Formulierung einer Hypothese fehlt, verkommt jede Inferenzsuche zu unbegründeter Halluzination.</li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="4-systemtechnik-modulare-multi-agenten-architektur-mit-archon">4. Systemtechnik: Modulare Multi-Agenten-Architektur mit Archon<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#4-systemtechnik-modulare-multi-agenten-architektur-mit-archon" class="hash-link" aria-label="Direkter Link zur 4. Systemtechnik: Modulare Multi-Agenten-Architektur mit Archon" title="Direkter Link zur 4. Systemtechnik: Modulare Multi-Agenten-Architektur mit Archon" translate="no">​</a></h3>
<p>Wie lassen sich diese theoretischen Inferenzgesetze in robuste Produktionssoftware überführen, ohne auf fragile Prompt-Basteleien zurückzugreifen?</p>
<p>Das <strong>Archon</strong>-Framework (arxiv:2409.15254) löst dies, indem es funktionale LLM-Bausteine in <strong>schichtweise Software-Pipelines</strong> modularisiert:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Q[Nutzer-Prompt / Aufgabenstellung] --&gt; G[Schicht 1: Generator-Ensemble]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    G --&gt;|Lösungskandidaten| C[Schicht 2: Multiperspektivischer Critic]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    C --&gt;|Kritikpunkte &amp; Schwachstellen| R[Schicht 3: Turnier-Ranker]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    R --&gt;|Top-k Spitzenkandidaten| F[Schicht 4: Fusions-Synthetisierer]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    F --&gt;|Konsolidierte Antwort| V[Schicht 5: Automatischer Verifizierer &amp; Unittest-Sandbox]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    V --&gt;|Test-Ergebnisse| Dec{Alle Tests bestanden?}</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Dec -- Ja --&gt; Final[Verifiziertes Produktionsergebnis]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Dec -- Nein (Verfeinerungsschleife) --&gt; G</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-fünf-architekturschichten-von-archon">Die fünf Architekturschichten von Archon<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#die-f%C3%BCnf-architekturschichten-von-archon" class="hash-link" aria-label="Direkter Link zur Die fünf Architekturschichten von Archon" title="Direkter Link zur Die fünf Architekturschichten von Archon" translate="no">​</a></h4>
<ol>
<li class=""><strong>Generator-Schicht:</strong> Erzeugt vielfältige Lösungskandidaten durch variierte Sampling-Temperaturen (T=0,2 bis 0,8) oder den Einsatz heterogener Modelle (z. B. Claude 3.5 Sonnet + DeepSeek-V2).</li>
<li class=""><strong>Critic-Schicht:</strong> Analysiert die erzeugten Trajektorien gezielt auf mathematische Lücken, logische Widersprüche oder Randwertprobleme.</li>
<li class=""><strong>Ranker-Schicht:</strong> Führt paarweise Turniervergleiche zwischen den Kandidaten anhand strukturierter Bewertungsrubriken durch.</li>
<li class=""><strong>Fuser-Schicht:</strong> Rekombiniert die stärksten logischen Argumente der bestplatzierten Kandidaten zu einer überlegenen Gesamtlösung (+8,9 % Benchmark-Zuwachs).</li>
<li class=""><strong>Verifier-Schicht:</strong> Lässt ein LLM 5 bis 10 Unittests für Randfälle generieren und führt den Code in einer isolierten Sandbox (Docker/gVisor) aus (+56 % Genauigkeit bei Programmieraufgaben).</li>
</ol>
<p>Mittels <strong>Bayesscher Optimierung (Bayesian Optimization)</strong> traversiert Archon einen Architektursuchraum von <strong>9.576 Pipeline-Konfigurationen</strong> und ermittelt für jedes Latenz- und Kostenbudget die Pareto-optimale Agentenarchitektur.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="5-architektur-fallstudie-demystifizierung-von-openai-o1--reasoning-modellen">5. Architektur-Fallstudie: Demystifizierung von OpenAI o1 &amp; Reasoning-Modellen<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#5-architektur-fallstudie-demystifizierung-von-openai-o1--reasoning-modellen" class="hash-link" aria-label="Direkter Link zur 5. Architektur-Fallstudie: Demystifizierung von OpenAI o1 &amp; Reasoning-Modellen" title="Direkter Link zur 5. Architektur-Fallstudie: Demystifizierung von OpenAI o1 &amp; Reasoning-Modellen" translate="no">​</a></h3>
<p>Die Vorlesung 2 der Stanford CS329A erklärt präzise die internen Abläufe moderner Reasoning-Modelle wie OpenAI o1 und DeepSeek-R1:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">┌────────────────────────────────────────────────────────────────────────┐</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│                   Hinter dem "Thinking"-Trace von o1                   │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">├────────────────────────────────────────────────────────────────────────┤</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ 1. Verborgene Deliberation (Test-Time Tokens):                         │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│    Das Modell erzeugt Tausende verdeckte Chain-of-Thought-Tokens,      │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│    bevor das erste sichtbare Zeichen ausgegeben wird.                  │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│                                                                        │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ 2. Integrierte PRM-Bewertung &amp; Backtracking:                           │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│    Trainiert mit Reinforcement Learning (RL) auf Prozessbelohnungen, um│</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│    Sackgassen selbstständig zu erkennen und zurückzuspringen.          │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│                                                                        │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│ 3. Autonome Korrekturschleife (Snell Revision):                         │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│    Formulierungen wie "Moment, das scheint falsch zu sein..." sind     │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│    Manifestationen gelernter sequenzieller Revisionsrichtlinien.       │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">└────────────────────────────────────────────────────────────────────────┘</span><br></div></code></pre></div></div>
<p>Der sichtbare Denkprozess ist keine magische Blackbox: Er ist die vollständige neuronale Implementierung der <strong>Inferenzzeit-Skalierung</strong>, die sequenzielle Revision, PRM-Verifikation und adaptive Suche in einer einzigen Modellarchitektur vereint.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="6-zusammenfassung-und-zentrale-ingenieur-lehren">6. Zusammenfassung und zentrale Ingenieur-Lehren<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#6-zusammenfassung-und-zentrale-ingenieur-lehren" class="hash-link" aria-label="Direkter Link zur 6. Zusammenfassung und zentrale Ingenieur-Lehren" title="Direkter Link zur 6. Zusammenfassung und zentrale Ingenieur-Lehren" translate="no">​</a></h3>
<ol>
<li class=""><strong>Zwei orthogonale Dimensionen:</strong> Die Skalierung von KI-Systemen hängt nicht mehr allein vom Pre-Training ab. Die Inferenzrechenzeit bietet eine unabhängige Achse, mit der kompakte Modelle selbst schwerste Industriemodelle schlagen können.</li>
<li class=""><strong>Das Coverage-Precision-Prinzip:</strong> Wiederholtes Sampling (pass@k) steigert die Lösungs-Coverage massiv (DeepSeek-Coder-V2 von 15,9 % auf 56,0 %), erfordert jedoch hochpräzise Verifizierer (PRM), um diese Erfolge auch zu bergen.</li>
<li class=""><strong>Snells Gesetz der optimalen Allokation:</strong> Adaptive Rechenzeitverteilung spart das 4-Fache an Rechenressourcen ein: Nutzen Sie sequenzielle Revision für einfache Aufgaben und PRM-Beam-Search für komplexe Problemstellungen.</li>
<li class=""><strong>Modulare Softwarearchitektur:</strong> Wie Archon beweist, ist die Software-Pipeline – das Zusammenspiel aus Generatoren, Kritikern, Rankern und Test-Sandboxes – für das Endergebnis mindestens genauso entscheidend wie die Parametergröße des Modells.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="vorschau-auf-stanford-cs329a-vorlesung-3">Vorschau auf Stanford CS329A Vorlesung 3:<a href="https://globaldevlog.com/de/blog/stanford-cs329a-2-test-time-compute-scaling-inference-laws#vorschau-auf-stanford-cs329a-vorlesung-3" class="hash-link" aria-label="Direkter Link zur Vorschau auf Stanford CS329A Vorlesung 3:" title="Direkter Link zur Vorschau auf Stanford CS329A Vorlesung 3:" translate="no">​</a></h3>
<p>In <strong>Vorlesung 3</strong> betreten wir das Herzstück autonomer Agenten: <strong>《Robust Verification: Process Reward Models (PRM), Ensembles und skalierbare Aufsicht (Scalable Oversight)》</strong>. Wir werden im Detail untersuchen, wie Verifizierer gebaut werden, die immun gegen Reward-Hacking sind und mathematische Beweise ohne menschliche Aufsicht verifizieren. Bleiben Sie dran!</p>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs329a" term="stanford-cs329a"/>
        <category label="test-time-compute" term="test-time-compute"/>
        <category label="inference-scaling" term="inference-scaling"/>
        <category label="verifier-prm" term="verifier-prm"/>
        <category label="self-improving-agents" term="self-improving-agents"/>
        <category label="ai-architecture" term="ai-architecture"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS329A #1] Kursübersicht: Von großen Sprachmodellen zu selbstverbessernden KI-Agenten]]></title>
        <id>https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents</id>
        <link href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents"/>
        <updated>2026-11-01T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Umfassender technischer Leitfaden zu Stanford CS329A Vorlesung 1: Paradigmenwechsel von statischen LLMs zu autonomen, selbstverbessernden KI-Agenten durch Inferenzzeit-Skalierung und Prozessbelohnungsverifikation.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Stanford CS329A Selbstverbessernde KI-Agenten" src="https://globaldevlog.com/de/assets/images/01_cs329a_self_improving_agents_overview-a0d9cae297e47778949b35b5f949cfb7.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zur detaillierten technischen Aufschlüsselung des Kurses <strong>CS329A der Stanford University: Self-Improving AI Agents (Selbstverbessernde KI-Agenten, Herbst 2025)</strong>.</p>
<p>In den vergangenen vier Jahren wurde die Landschaft der künstlichen Intelligenz von einem einzigen Dogma beherrscht: <em>Das Vortraining größerer Modelle auf immer gigantischeren Textkorpora führt zu kontinuierlich wachsenden kognitiven Fähigkeiten</em>. Während dieses Paradigma die moderne generative KI-Revolution entfachte – und Modelle wie GPT-4, Claude 3.5 und Gemini hervorbrachte –, hat die vorderste Front der Machine-Learning-Forschung einen entscheidenden Wendepunkt erreicht.</p>
<p>Statische Basismodelle (Static Foundation Models) weisen, ungeachtet astronomischer Parameterzahlen, fundamentale Grenzen auf: Sie sind passive, autoregressive Prädiktoren des nächsten Tokens, die in einem rückkopplungslosen Regime (Open-loop) agieren. Sobald ihre Gewichte nach dem Training eingefroren (frozen) sind, können sie schwierigen Problemen nicht dynamisch mehr Rechenleistung zuweisen, die sachliche Richtigkeit ihrer eigenen Ableitungen nicht autonom verifizieren und Fehler nicht auf Basis von Umgebungsrückmeldungen iterativ korrigieren.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Statisches_Paradigma ["Statisches Paradigma (2020-2024)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        direction TB</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1[Massiver Webkorpus] --&gt; B1[Großskalierter Pre-Training-Cluster]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B1 --&gt; C1[Überwachtes Feintuning SFT]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C1 --&gt; D1[Eingefrorenes Statisches Modell]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D1 --&gt;|Einzelner Vorwärtsdurchlauf| E1[Einmalige Textantwort]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Autonomes_Paradigma ["Stanford CS329A: Selbstverbessernde Agenten"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        direction TB</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A2[Komplexes Aufgabenziel] ==&gt; B2[Schlussfolgerungs- und Planungs-Engine]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B2 --&gt;|Aktionen / Code-Entwürfe| C2[Sandbox-Umgebung und Werkzeuge]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C2 --&gt;|Ausführungsspuren und Status| D2[Prozess-Verifizierer PRM]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D2 --&gt;|Belohnungs- und Fehlersignale| B2</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D2 ==&gt;|Inferenz- und Trainings-Updates| E2[Kontinuierliche Selbstevolution]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<p>Stanford CS329A widmet sich der Kernfrage des kommenden KI-Jahrzehnts: <strong>Wie konstruieren wir Software-Agenten, die nicht bloß Text generieren, sondern ihr eigenes Denken und ihren Code kontinuierlich überprüfen, verifizieren, planen und eigenständig verbessern?</strong></p>
<p>In dieser Einführungsvorlesung analysieren wir die evolutionäre Flugbahn von Basis-LLMs zu Agentensystemen, formalisieren die Mathematik der Skalierungsgesetze und der Inferenzzeit-Rechenallokation, untersuchen die vier kanonischen Agenten-Workflow-Muster und isolieren den kritischen Flaschenhals autonomer Intelligenz: die <strong>Generator-Verifizierer-Lücke (Generator-Verifier Gap)</strong>.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-der-evolutionäre-bogen-wie-wir-hierher-gelangten">1. Der evolutionäre Bogen: Wie wir hierher gelangten<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#1-der-evolution%C3%A4re-bogen-wie-wir-hierher-gelangten" class="hash-link" aria-label="Direkter Link zur 1. Der evolutionäre Bogen: Wie wir hierher gelangten" title="Direkter Link zur 1. Der evolutionäre Bogen: Wie wir hierher gelangten" translate="no">​</a></h3>
<p>Um die Stoßrichtung selbstverbessernder Agenten zu verstehen, müssen wir die drei historischen Phasen des modernen Foundation-Model-Engineerings betrachten:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">  Phase 1: Pre-Training (Selbstüberwachte Vorhersage des nächsten Tokens)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  [Web-Scraping / Billionen Tokens] ────&gt; Basis-LLM (Autoregressiver Text-Vervollständiger)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">                                                    │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  Phase 2: Post-Training Alignment                  ▼</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  [Kuratierte Prompt-Antwort-Paare] ────&gt; SFT (Instruktionsbefolgender Assistent)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  [Menschliche Präferenzen (RLHF/DPO)] ─&gt; Ausgerichteter Konversations-Chatbot</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">                                                    │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  Phase 3: Die CS329A-Fronte                        ▼</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  [Ausführungs-Feedback + PRM-Prüfung] ─&gt; Autonomer Selbstverbessernder Agent</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="phase-1-unüberwachtes-pre-training-unsupervised-pre-training">Phase 1: Unüberwachtes Pre-Training (Unsupervised Pre-Training)<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#phase-1-un%C3%BCberwachtes-pre-training-unsupervised-pre-training" class="hash-link" aria-label="Direkter Link zur Phase 1: Unüberwachtes Pre-Training (Unsupervised Pre-Training)" title="Direkter Link zur Phase 1: Unüberwachtes Pre-Training (Unsupervised Pre-Training)" translate="no">​</a></h4>
<p>Ein Basis-Sprachmodell wird auf Billionen von Tokens über das Maximum-Likelihood-Schätzungs-Kriterium (MLE) optimiert:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">L_MLE(θ) = - ∑ log P_θ(x_i | x_{1:i-1})</span><br></div></code></pre></div></div>
<p>Dieses Ziel zwingt das Modell, Syntax, Weltwissen und semantische Assoziationen in hunderte Milliarden Parameter zu komprimieren. Dennoch bleibt das Basismodell ein uneingeschränkter probabilistischer Nachahmer. Auf den Prompt <em>"Was ist die Hauptstadt von Frankreich?"</em> antwortet es unter Umständen nicht mit der Lösung, sondern fährt fort mit <em>"Was ist die Hauptstadt von Deutschland?"</em>, da solche Listen im Web häufig koexistieren.</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="phase-2-instruktionstuning-und-rlhf-das-chatgpt-rezept">Phase 2: Instruktionstuning und RLHF (Das "ChatGPT-Rezept")<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#phase-2-instruktionstuning-und-rlhf-das-chatgpt-rezept" class="hash-link" aria-label="Direkter Link zur Phase 2: Instruktionstuning und RLHF (Das &quot;ChatGPT-Rezept&quot;)" title="Direkter Link zur Phase 2: Instruktionstuning und RLHF (Das &quot;ChatGPT-Rezept&quot;)" translate="no">​</a></h4>
<p>Um aus einem ungebändigten Textgenerator einen nützlichen Assistenten zu formen, etablierte die Industrie eine zweistufige Post-Training-Pipeline:</p>
<ol>
<li class=""><strong>Supervised Fine-Tuning (SFT):</strong> Training auf hochwertigen Demonstrationspaaren, um dem Modell eine hilfsbereite Dialogrolle einzuprägen.</li>
<li class=""><strong>Reinforcement Learning from Human Feedback (RLHF) / DPO:</strong> Optimierung gegen ein Belohnungsmodell <code>r_ψ(x, y)</code>, welches menschliche Präferenzen abbildet:</li>
</ol>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">max_θ E_{(x, y) ~ D} [ r_ψ(x, y) ] - β · D_KL( π_θ(y | x) || π_ref(y | x) )</span><br></div></code></pre></div></div>
<p>Obwohl RLHF Konversationsgehorsam und Sicherheit herstellte, verlieh es den Modellen keine echte Autonomie bei der Problemlösung. Ein ausgerichteter Chatbot erzeugt seine Ausgabe nach wie vor in einem einzigen sequenziellen Durchlauf ohne deliberative Verifikation oder externe Werkzeugnutzung.</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="phase-3-die-cs329a-grenze--autonome-agentenschleifen">Phase 3: Die CS329A-Grenze — Autonome Agentenschleifen<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#phase-3-die-cs329a-grenze--autonome-agentenschleifen" class="hash-link" aria-label="Direkter Link zur Phase 3: Die CS329A-Grenze — Autonome Agentenschleifen" title="Direkter Link zur Phase 3: Die CS329A-Grenze — Autonome Agentenschleifen" translate="no">​</a></h4>
<p>Selbstverbessernde Agenten sprengen das Korsett des einzelnen Vorwärtsdurchlaufs. Durch die Einbettung externer Werkzeuge (Compiler, Web-Browser, Python-REPLs), strukturierter Speicherhierarchien und automatisierter Verifikationsschleifen verwandelt sich das System in einen aktiven Agenten: Es beobachtet die Umwelt, führt diskrete Handlungen aus, evaluiert Zwischenzustände und verfeinert seine internen Pläne, bis ein Ziel nachweisbar erfüllt ist.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-mathematik-der-skalierungsgesetze-trainings--vs-inferenzzeit">2. Die Mathematik der Skalierungsgesetze: Trainings- vs. Inferenzzeit<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#2-die-mathematik-der-skalierungsgesetze-trainings--vs-inferenzzeit" class="hash-link" aria-label="Direkter Link zur 2. Die Mathematik der Skalierungsgesetze: Trainings- vs. Inferenzzeit" title="Direkter Link zur 2. Die Mathematik der Skalierungsgesetze: Trainings- vs. Inferenzzeit" translate="no">​</a></h3>
<p>Das Fundament des modernen Deep Learning ist die <strong>Skalierungshypothese (Scaling Hypothesis)</strong>. 2020 zeigten Kaplan et al. (OpenAI) und 2022 Hoffmann et al. (DeepMind Chinchilla), dass der Test-Kreuzentropie-Verlust $L$ eines autoregressiven Sprachmodells bezüglich Rechenbudget C, Parameteranzahl N und Datensatzgröße D einem Potenzgesetz folgt:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">L(N, D) = E + A / N^α + B / D^β</span><br></div></code></pre></div></div>
<p>wobei E die irreduzible Entropie natürlicher Sprache darstellt, $A, B$ Skalierungskoeffizienten sind und α ≈ 0.34, β ≈ 0.28 empirische Skalierungsexponenten bezeichnen.</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Kreuzentropie-Verlust L</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> ▲</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │ ╲  10^21 FLOPs (GPT-2 Ära)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │  ╲</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   ╲  10^23 FLOPs (GPT-3 Ära)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │    ╲</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │     ╲  10^25 FLOPs (GPT-4 Ära)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │      └─── Pre-Training-Mauer (Datenerschöpfung und Leistungsgrenzen)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> └─────────────────────────────────────────────────────────────►</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">                       Rechenaufwand C (FLOPs)</span><br></div></code></pre></div></div>
<p>Dennoch stößt das reine Skalieren des Pre-Trainings an physische und ökonomische Grenzen:</p>
<ul>
<li class=""><strong>Die Datenmauer:</strong> Hochwertige, von Menschen verfasste Texte im offenen Internet werden Schätzungen zufolge noch in diesem Jahrzehnt vollständig erschöpft sein.</li>
<li class=""><strong>Kapital- und Leistungsdichte:</strong> Trainingscluster mit mehr als 10²⁶ FLOPs erfordern dedizierte Gigawatt-Umspannwerke und Infrastrukturinvestitionen von hunderten Millionen Dollar.</li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-zweite-front-skalierung-zur-inferenzzeit-inference-time-compute-scaling">Die zweite Front: Skalierung zur Inferenzzeit (Inference-Time Compute Scaling)<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#die-zweite-front-skalierung-zur-inferenzzeit-inference-time-compute-scaling" class="hash-link" aria-label="Direkter Link zur Die zweite Front: Skalierung zur Inferenzzeit (Inference-Time Compute Scaling)" title="Direkter Link zur Die zweite Front: Skalierung zur Inferenzzeit (Inference-Time Compute Scaling)" translate="no">​</a></h4>
<p>Statt zig Millionen Dollar für das Neuerlernen von Modellgewichten aufzuwenden: <strong>Können wir überlegene Intelligenz freisetzen, indem wir während der Inferenz (Test-Time) mehr Rechenleistung investieren?</strong></p>
<p>Ein menschlicher Experte formuliert bei komplexen mathematischen Beweisen oder Softwarearchitekturen nicht sofort die perfekte Lösung; er skizziert Hypothesen, prüft Zwischenlemmata, erkennt Sackgassen und vollzieht Backtracking.</p>
<p>Bei der <strong>Inferenzzeit-Skalierung</strong> verteilen wir Test-FLOPs über drei fundamentale Achsen:</p>
<ol>
<li class=""><strong>Wiederholtes Sampling (Best-of-N / Large Language Monkeys):</strong> Paralleles Erzeugen von N Lösungstrajektorien aus π_θ und Selektion der optimalen Antwort über einen Verifizierer. Die Wahrscheinlichkeit mindestens einer korrekten Lösung folgt der <code>Pass@k</code>-Metrik:</li>
</ol>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Pass@k = E[ 1 - C(n - c, k) / C(n, k) ]</span><br></div></code></pre></div></div>
<p>wobei n die Gesamtzahl der Samples und c die Anzahl korrekter Trajektorien ist.
2. <strong>Schrittweise Verifikation (PRM vs. ORM):</strong> Outcome Reward Models (ORM) bewerten nur das Endergebnis <code>r(x, y)</code>, was die Lokalisierung von Zwischenfehlern unmöglich macht. Process-supervised Reward Models (PRM) weisen jedem einzelnen Gedankenschritt eine skalare Belohnung <code>r_t = R(x, y_{1:t})</code> zu und ermöglichen so präzise Kreditzuweisung (Credit Assignment).
3. <strong>Baumsuchalgorithmen (MCTS, Beam Search):</strong> Erkundung des kombinatorischen Denkbaums mittels Monte-Carlo-Baumsuche, balanciert zwischen Ausbeutung vielversprechender Zustände (Exploitation) und Erkundung neuer Pfade (Exploration).</p>
<p>Wie Pionierarchitekturen (z. B. OpenAI o1, DeepSeek-R1) belegen, kann die Vervielfachung der Inferenzrechenzeit um den Faktor 100 bis 1.000 bei mathematischen Wettbewerben (IMO) und Programmier-Benchmarks (SWE-bench) Leistungsdimensionen eröffnen, die reines Parameterwachstum weit hinter sich lassen.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-die-vier-kanonischen-agenten-workflow-archetypen">3. Die vier kanonischen Agenten-Workflow-Archetypen<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#3-die-vier-kanonischen-agenten-workflow-archetypen" class="hash-link" aria-label="Direkter Link zur 3. Die vier kanonischen Agenten-Workflow-Archetypen" title="Direkter Link zur 3. Die vier kanonischen Agenten-Workflow-Archetypen" translate="no">​</a></h3>
<p>Beim Bau autonomer Agentensysteme scheitert naives Prompting häufig an stochastischer Drift. Stanford CS329A formalisiert modulare Entwurfsmuster in vier Kernarchitekturen:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Muster1 ["1. Prompt-Verkettung (Prompt Chaining)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P1_In[Aufgabeneingabe] --&gt; P1_M1[Modell Schritt 1]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P1_M1 --&gt;|Zwischenergebnis| P1_M2[Modell Schritt 2]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P1_M2 --&gt; P1_Out[Finales Ergebnis]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Muster2 ["2. Dynamisches Routing (Dynamic Routing)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P2_In[Benutzeranfrage] --&gt; P2_Router{Absichts-Router}</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P2_Router --&gt;|Mathematik| P2_Math[Symbolische Engine]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P2_Router --&gt;|Codebasis| P2_Code[SWE-Agent]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P2_Router --&gt;|Allgemein| P2_LLM[Standard-LLM]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Muster3 ["3. Parallelisierung (Parallelization)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3_In[Aufgabe] --&gt; P3_A[Agent 1: Konservativ]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3_In --&gt; P3_B[Agent 2: Kreativ]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3_In --&gt; P3_C[Agent 3: Adversariell]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3_A --&gt; P3_Agg[Konsens-Aggregator]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3_B --&gt; P3_Agg</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P3_C --&gt; P3_Agg</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Muster4 ["4. Orchestrator-Worker (Orchestrator-Worker)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P4_In[PRD-Spezifikation] --&gt; P4_Orch[Zentraler Orchestrator]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P4_Orch --&gt;|Teilaufgabe 1| P4_W1[Fach-Worker 1]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P4_Orch --&gt;|Teilaufgabe 2| P4_W2[Fach-Worker 2]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P4_W1 --&gt;|Statusrückmeldung| P4_Orch</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P4_W2 --&gt;|Statusrückmeldung| P4_Orch</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        P4_Orch --&gt; P4_Out[Integriertes Liefersystem]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-prompt-verkettung-prompt-chaining-sequenzielle-zerlegung">1. Prompt-Verkettung (Prompt Chaining: Sequenzielle Zerlegung)<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#1-prompt-verkettung-prompt-chaining-sequenzielle-zerlegung" class="hash-link" aria-label="Direkter Link zur 1. Prompt-Verkettung (Prompt Chaining: Sequenzielle Zerlegung)" title="Direkter Link zur 1. Prompt-Verkettung (Prompt Chaining: Sequenzielle Zerlegung)" translate="no">​</a></h4>
<p>Zerlegt eine monolithische Aufgabe in deterministische Schritte, bei denen die Ausgabe von Schritt <code>k</code> zum Eingabekontext für Schritt <code>k+1</code> wird. Durch zwischengeschaltete Validierungstore (z. B. Gliederung erstellen $\to$ Vollständigkeit prüfen $\to$ Entwurf schreiben $\to$ Korrekturlesen) wird Fehlerkaskaden vorgebeugt.</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-dynamisches-routing-dynamic-routing-spezialisierung">2. Dynamisches Routing (Dynamic Routing: Spezialisierung)<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#2-dynamisches-routing-dynamic-routing-spezialisierung" class="hash-link" aria-label="Direkter Link zur 2. Dynamisches Routing (Dynamic Routing: Spezialisierung)" title="Direkter Link zur 2. Dynamisches Routing (Dynamic Routing: Spezialisierung)" translate="no">​</a></h4>
<p>Klassifiziert eingehende Anfragen und leitet sie an spezialisierte Modelle oder Werkzeuge weiter. Mathematische Probleme wandern in eine Python-Sandbox, großflächige Code-Refactorings an einen spezialisierten SWE-Agenten.</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-parallelisierung-parallelization-aufteilung-und-abstimmung">3. Parallelisierung (Parallelization: Aufteilung und Abstimmung)<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#3-parallelisierung-parallelization-aufteilung-und-abstimmung" class="hash-link" aria-label="Direkter Link zur 3. Parallelisierung (Parallelization: Aufteilung und Abstimmung)" title="Direkter Link zur 3. Parallelisierung (Parallelization: Aufteilung und Abstimmung)" translate="no">​</a></h4>
<ul>
<li class=""><strong>Sektionierung (Sectioning):</strong> Gleichzeitiges Bearbeiten unabhängiger Teilaufgaben durch mehrere Agenteninstanzen.</li>
<li class=""><strong>Voting-Ensemble (Voting):</strong> Paralleles Erzeugen mehrerer Lösungen mit diversen Prompts oder Temperaturparametern zur Filterung stochastischer Anomalien durch Mehrheitsbeschluss.</li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="4-orchestrator-worker-hierarchische-delegation">4. Orchestrator-Worker (Hierarchische Delegation)<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#4-orchestrator-worker-hierarchische-delegation" class="hash-link" aria-label="Direkter Link zur 4. Orchestrator-Worker (Hierarchische Delegation)" title="Direkter Link zur 4. Orchestrator-Worker (Hierarchische Delegation)" translate="no">​</a></h4>
<p>Ein zentraler Planungsagent bricht ein übergeordnetes Ziel in einen gerichteten azyklischen Graphen (DAG) herunter, delegiert Teilaufgaben an spezialisierte Arbeiter-Agenten, überwacht Ausnahmen in Echtzeit und integriert die Einzelergebnisse.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="4-der-kritische-flaschenhals-die-generator-verifizierer-lücke">4. Der kritische Flaschenhals: Die Generator-Verifizierer-Lücke<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#4-der-kritische-flaschenhals-die-generator-verifizierer-l%C3%BCcke" class="hash-link" aria-label="Direkter Link zur 4. Der kritische Flaschenhals: Die Generator-Verifizierer-Lücke" title="Direkter Link zur 4. Der kritische Flaschenhals: Die Generator-Verifizierer-Lücke" translate="no">​</a></h3>
<p>Warum ist die Entwicklung selbstverbessernder Agenten so herausfordernd?
Der Kern des Problems liegt in der <strong>Asymmetrie zwischen Generierung und Verifikation</strong>:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Komplexität(Verifikation) ≪ Komplexität(Generierung)   [Geschlossene Formale Domänen]</span><br></div></code></pre></div></div>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Komplexität(Verifikation) ≈ Komplexität(Generierung)   [Offene Natürlichsprachliche Domänen]</span><br></div></code></pre></div></div>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">Verifikationsfähigkeit</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> ▲</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   Formale Domänen (Mathematik, Python-Code, Lean 4)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   ┌────────────────────────────────────────────────────────┐</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   │ Verifizierer (Compiler / Testsuite / Z3 SMT-Solver)    │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   │ Deterministisch, rechengünstig und 100% zuverlässig   │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   └────────────────────────────────────────────────────────┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   Offene Domänen (Aufsätze, Strategieberatung, Verhandlung)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   ┌────────────────────────────────────────────────────────┐</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   │ Verifizierer (LLM als Richter)                         │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   │ Rauschanfällig, anfällig für Verbosity Bias &amp; Schmeichelei │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> │   └────────────────────────────────────────────────────────┘</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"> └─────────────────────────────────────────────────────────────►</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">                     Generierungskomplexität</span><br></div></code></pre></div></div>
<p>In formalen Umgebungen wie der Softwareentwicklung ist die Verifikation deterministisch: Der Code kompiliert fehlerfrei oder scheitert; Unit-Tests bestehen oder schlagen fehl. Hier funktioniert die Selbstverbesserung direkt: Kandidaten erzeugen, Tests laufen lassen, fehlerhafte Entwürfe verwerfen und funktionierende Patches übernehmen.</p>
<p>In offenen natürlichsprachlichen Domänen erfordert die <strong>Bewertung, ob eine Antwort optimal ist, jedoch nahezu dieselbe kognitive Intelligenz wie ihre Neuerstellung</strong>. Setzen wir ein LLM als Richter über ein anderes LLM ein, geraten wir in stochastische Zirkelschlüsse: Der Beurteiler bevorzugt weitschweifige Antworten (Verbosity Bias) und teilt die Halluzinationen des Generators.</p>
<p>Das Schließen dieser Lücke durch neuro-symbolische Übersetzung in formale Einschränkungen und die Verankerung in externen Ausführungsumgebungen bildet den wissenschaftlichen Kern von CS329A.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="5-stanford-cs329a-vierstufiger-lehrplan-fahrplan">5. Stanford CS329A: Vierstufiger Lehrplan-Fahrplan<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#5-stanford-cs329a-vierstufiger-lehrplan-fahrplan" class="hash-link" aria-label="Direkter Link zur 5. Stanford CS329A: Vierstufiger Lehrplan-Fahrplan" title="Direkter Link zur 5. Stanford CS329A: Vierstufiger Lehrplan-Fahrplan" translate="no">​</a></h3>
<p>Das Curriculum von CS329A gliedert sich in vier progressive Schichten:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">┌─────────────────────────────────────────────────────────────────────────────┐</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│                    Stanford CS329A Architektur-Stack                        │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">├─────────────────────────────────────────────────────────────────────────────┤</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  Teil 4 · Fronten (L13 - L17)                                               │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Formale mathematische Beweise (AlphaProof, Lean 4)                       │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Autonome Systemzuverlässigkeit und AI-Control-Grenzen                    │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Multimodale und verkörperte Robotik-Agenten (VLA, RT-2, π0)              │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Großes Finale: Offene Zukunftsfragen und Alignment-Erosion               │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">├─────────────────────────────────────────────────────────────────────────────┤</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  Teil 3 · Agent Engineering (L10 - L12)                                     │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Software-Engineering-Agenten (SWE-bench, ASI-Schnittstelle)              │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Hierarchische Speicherarchitekturen (MemGPT, CacheBlend)                 │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Langzeittask-Evaluation und ökonomischer Nutzen (METR Time Horizons)     │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">├─────────────────────────────────────────────────────────────────────────────┤</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  Teil 2 · Training &amp; Evolution (L6 - L9)                                    │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Trainingszeit-Skalierung und RL (DeepSeekMath &amp; GRPO)                    │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Offene Selbstevolution und Architektursuche (ADAS, AlphaEvolve)          │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Autonome Deep-Research-Workflows (AlphaCode, Search-o1)                  │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Die Post-Training-Evolution: SFT -&gt; RLHF -&gt; RLVR -&gt; Agent RL             │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">├─────────────────────────────────────────────────────────────────────────────┤</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  Teil 1 · Grundlagen (L1 - L5)                                              │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Inferenzzeit-Skalierung und rechenoptimale Frontiers                     │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Prozessüberwachte Verifizierer (PRM800K)                                 │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Werkzeugintegration und Code-Feedback-Schleifen (ReAct, RLEF)            │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">│  - Mehrstufige Planung und Monte-Carlo-Baumsuche (LATS MCTS)                │</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">└─────────────────────────────────────────────────────────────────────────────┘</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="6-wichtigste-erkenntnisse-und-akademische-qa">6. Wichtigste Erkenntnisse und Akademische Q&amp;A<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#6-wichtigste-erkenntnisse-und-akademische-qa" class="hash-link" aria-label="Direkter Link zur 6. Wichtigste Erkenntnisse und Akademische Q&amp;A" title="Direkter Link zur 6. Wichtigste Erkenntnisse und Akademische Q&amp;A" translate="no">​</a></h3>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="wichtigste-erkenntnisse">Wichtigste Erkenntnisse<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#wichtigste-erkenntnisse" class="hash-link" aria-label="Direkter Link zur Wichtigste Erkenntnisse" title="Direkter Link zur Wichtigste Erkenntnisse" translate="no">​</a></h4>
<ol>
<li class=""><strong>Der Paradigmenwechsel:</strong> KI hat sich von der statischen Textgenerierung zu autonomen Rückkopplungsschleifen weiterentwickelt, in denen Ausführung, Prüfung und Reflexion kontinuierlich ineinandergreifen.</li>
<li class=""><strong>Duale Skalierungsfronten:</strong> Die Vergrößerung von Pre-Training-Parametern wird nun durch Inferenzzeit-Skalierung (Best-of-N, PRM-Verifikation, Baumsuche) ergänzt, wodurch kompakte Modelle durch überlegtes Denken Großmodelle schlagen können.</li>
<li class=""><strong>Das universelle Rückgrat:</strong> Jedes erfolgreiche Agentensystem implementiert den Dreiklang: <strong>Generieren $\to$ Verifizieren $\to$ Iterieren</strong>.</li>
<li class=""><strong>Der Verifikationsflaschenhals:</strong> Die Evolutionsrate eines Agenten wird strikt durch die Schärfe und Objektivität seines Verifikationssignals begrenzt.</li>
</ol>
<hr>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="akademische-qa">Akademische Q&amp;A<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#akademische-qa" class="hash-link" aria-label="Direkter Link zur Akademische Q&amp;A" title="Direkter Link zur Akademische Q&amp;A" translate="no">​</a></h4>
<p><strong>F. Wie unterscheidet sich Inferenzzeit-Skalierung von standardmäßigem Prompt-Engineering oder Chain-of-Thought (CoT)?</strong>
<strong>A.</strong> Standard-CoT generiert Gedankengänge in einer linearen, ungeprüften Sequenz. Unterläuft dem Modell in Schritt 2 ein Rechenfehler, pflanzt sich dieser unweigerlich fort. Inferenzzeit-Skalierung hingegen etabliert externe Suchbäume und Verifikations-Checkpoints: Jeder Schritt wird durch Prozessbelohnungsmodelle (PRM) oder Compiler bewertet. Dies erlaubt das aktive Vertiefen erfolgversprechender Pfade und das gezielte Zurückschneiden (Pruning) fehlerhafter Äste.</p>
<p><strong>F. Warum trainieren wir nicht einfach ein gigantisches LLM als universellen Prüfer für alle Aufgaben?</strong>
<strong>A.</strong> Weil probabilistische neuronale Netze ihre eigenen stochastischen Irrtümer ohne eine objektive Verankerung in der realen Umwelt (Ground-truth Anchor) nicht korrigieren können. LLM-Richter neigen zu Schmeichelei und Bevorzugung langer Antworten. Eine belastbare Verifikation entsteht erst, wenn sprachliche Aussagen in deterministische Artefakte überführt werden: Kompilierbare Unittests, SQL-Transaktionen, Lean-4-Theoreme oder Sensorsignale physischer Roboter.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="vorschau-auf-die-nächste-vorlesung">Vorschau auf die nächste Vorlesung<a href="https://globaldevlog.com/de/blog/stanford-cs329a-1-course-overview-self-improving-agents#vorschau-auf-die-n%C3%A4chste-vorlesung" class="hash-link" aria-label="Direkter Link zur Vorschau auf die nächste Vorlesung" title="Direkter Link zur Vorschau auf die nächste Vorlesung" translate="no">​</a></h3>
<p>In <strong>Vorlesung 2</strong> analysieren wir die tiefen mathematischen Mechanismen der <strong>Inferenzzeit-Rechenskalierung (Test-Time Compute Scaling)</strong>:</p>
<ul>
<li class="">Die rechenoptimalen Skalierungsgrenzen nach Snell et al.</li>
<li class="">Der Trade-off zwischen Sampling-Abdeckung und sequenzieller Suchtiefe.</li>
<li class="">Wie Architekturen wie <em>Archon</em> und <em>Large Language Monkeys</em> Rechenbudgets zwischen Generierung und Verifikation optimieren.</li>
</ul>
<p>Begleiten Sie uns bei der Entschlüsselung des Bauplans selbstverbessernder künstlicher Intelligenz!</p>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs329a" term="stanford-cs329a"/>
        <category label="self-improving-agents" term="self-improving-agents"/>
        <category label="foundation-models" term="foundation-models"/>
        <category label="test-time-compute" term="test-time-compute"/>
        <category label="agentic-workflows" term="agentic-workflows"/>
        <category label="ai-architecture" term="ai-architecture"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #10] Die Zukunft der Softwareentwicklung: Autonome Agenten-Swarms, Zero-Human Deployment-Pipelines und das Management von KI-Flotten]]></title>
        <id>https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10</id>
        <link href="https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10"/>
        <updated>2026-10-31T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Das große Finale von Stanford CS146S: Die Synthese des 10-Wochen-Curriculums zur autonomen Software-Fabrik — Zero-Human-Pipelines, KI-Flotten-Orchestrierung und die neu definierte Rolle des menschlichen Softwareingenieurs als System-Dirigent.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Die Zukunft der Softwareentwicklung und KI-Flotten" src="https://globaldevlog.com/de/assets/images/10_cs146s_future_software_engineering_ai_fleets-0b4d5f4eb24a0b6bd2bd879dc86b74db.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zum <strong>zehnten und finalen Teil</strong> unserer umfassenden technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>Über die vergangenen neun Vorlesungen haben wir die traditionelle Softwareentwicklung schrittweise dekonstruiert:</p>
<ul>
<li class=""><strong>Vorlesung 1</strong>: Der Wandel vom Tastatur-Typisten zum System-Dirigenten.</li>
<li class=""><strong>Vorlesung 2</strong>: Probabilistische Token-Mechanismen und Prompt-Engineering.</li>
<li class=""><strong>Vorlesung 3</strong>: Standardisierte Werkzeugnutzung über das Model Context Protocol (MCP).</li>
<li class=""><strong>Vorlesung 4</strong>: Spec-Driven Development (SDD) und selbstheilende Testschleifen.</li>
<li class=""><strong>Vorlesung 5</strong>: Multi-Agenten-Swarms im Architekt-Implementierer-Kritiker-Muster.</li>
<li class=""><strong>Vorlesung 6</strong>: eBPF-Kernel-Tracing und Incident-Mitigation zur Laufzeit.</li>
<li class=""><strong>Vorlesung 7</strong>: AST-Linter und Sicherheits-Taint-Analyse in CI/CD.</li>
<li class=""><strong>Vorlesung 8</strong>: KI-native modulare Architektur und Monolithen-Entkopplung.</li>
<li class=""><strong>Vorlesung 9</strong>: Mathematische Beweisführung mit Z3 SMT-Solvern und PBT.</li>
</ul>
<p>In diesem <strong>Capstone-Finale</strong> führt das Stanford-Curriculum diese Disziplinen zu einer geschlossenen Zukunftsvision zusammen: <strong>Die autonome Software-Fabrik (<em>The Autonomous Software Factory</em>)</strong>. Wir beleuchten, wie moderne High-Velocity-Organisationen Flotten hunderter paralleler Agenten steuern, berührungslose Continuous-Deployment-Pipelines etablieren und welche fundamentale Rolle der menschliche Ingenieur im Zeitalter automatisierter Intelligenz einnimmt.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-die-berührungslose-deployment-pipeline-dark-factories-für-software">1. Die berührungslose Deployment-Pipeline: „Dark Factories“ für Software<a href="https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10#1-die-ber%C3%BChrungslose-deployment-pipeline-dark-factories-f%C3%BCr-software" class="hash-link" aria-label="Direkter Link zur 1. Die berührungslose Deployment-Pipeline: „Dark Factories“ für Software" title="Direkter Link zur 1. Die berührungslose Deployment-Pipeline: „Dark Factories“ für Software" translate="no">​</a></h3>
<p>In der industriellen Fertigung bezeichnet eine <em>„Dark Factory“</em> eine vollautomatisierte Produktionsstätte, die ohne menschliche Arbeitskräfte auf dem Fabrikboden auskommt — ohne Licht und ohne Heizung.</p>
<p>In der Softwaretechnik entsteht derzeit dasselbe Phänomen: <strong>Zero-Human Continuous Deployment Highways</strong>:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Spec[1. Menschliche SPEC.md &amp; Zielvorgabe] ==&gt; Swarm[2. Autonomer Agenten-Swarm]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Swarm --&gt; Build[3. Multi-File-Code &amp; Tests]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Build --&gt; Verify[4. Formale Verifikation: Z3 &amp; PBT]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Verify --&gt; Shadow[5. Schatten-Dual-Run im Cluster]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Shadow --&gt; Deploy[6. Automatisierter Canary-Rollout 100%]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Deploy ==&gt; Telemetry[7. eBPF Echtzeit-Telemetrie]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Telemetry -.-&gt;|Latenz-Spike oder Error| Swarm</span><br></div></code></pre></div></div>
<ol>
<li class=""><strong>Spezifikations-Aufnahme</strong>: Der menschliche Chefarchitekt definiert funktionale und ethische Rahmenbedingungen.</li>
<li class=""><strong>Autonome Implementierung</strong>: Implementierer-Agenten erzeugen Code, Migrationen und Tests parallel.</li>
<li class=""><strong>Formale &amp; Deterministische Gates</strong>: Z3-Solver und Property-Tests beweisen Korrektheit vor dem Merge.</li>
<li class=""><strong>Automatisierter Canary-Rollout</strong>: Die Pipeline deployt Software stufenweise (1% $
ightarrow$ 10% $
ightarrow$ 100%) und rollt bei kleinsten Anomalien autonom zurück.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-management-von-ki-flotten-governance-und-budgetierung">2. Management von KI-Flotten: Governance und Budgetierung<a href="https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10#2-management-von-ki-flotten-governance-und-budgetierung" class="hash-link" aria-label="Direkter Link zur 2. Management von KI-Flotten: Governance und Budgetierung" title="Direkter Link zur 2. Management von KI-Flotten: Governance und Budgetierung" translate="no">​</a></h3>
<p>Werden hunderte Agenten parallel eingesetzt, müssen Ingenieure strikte Kontrollmechanismen etablieren:</p>
<table><thead><tr><th style="text-align:left">Governance-Dimension</th><th style="text-align:left">Herausforderung</th><th style="text-align:left">Lösung von Stanford CS146S</th></tr></thead><tbody><tr><td style="text-align:left"><strong>Token- &amp; Kostenkontrolle</strong></td><td style="text-align:left">Endlosschleifen verbrauchen tausende Dollar in Minuten</td><td style="text-align:left">Strikte Token-Budgets pro Task mit Hard-Cutoff</td></tr><tr><td style="text-align:left"><strong>Sicherheitsgrenzen</strong></td><td style="text-align:left">Agenten könnten gefährliche Systembefehle ausführen</td><td style="text-align:left">Sandboxing &amp; explizite menschliche Freigabe für destructive Actions</td></tr><tr><td style="text-align:left"><strong>Architektur-Drift</strong></td><td style="text-align:left">Autonome Agenten erfinden inkonsistente Sub-Frameworks</td><td style="text-align:left">Maschinell erzwungene Architektur-Guardrails im Linter</td></tr></tbody></table>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-das-unveränderliche-vermächtnis-der-menschliche-system-dirigent">3. Das unveränderliche Vermächtnis: Der menschliche System-Dirigent<a href="https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10#3-das-unver%C3%A4nderliche-verm%C3%A4chtnis-der-menschliche-system-dirigent" class="hash-link" aria-label="Direkter Link zur 3. Das unveränderliche Vermächtnis: Der menschliche System-Dirigent" title="Direkter Link zur 3. Das unveränderliche Vermächtnis: Der menschliche System-Dirigent" translate="no">​</a></h3>
<p>Die Vorlesung schließt mit einem eindringlichen Fazit über die Zukunft des Softwareingenieurs:</p>
<blockquote>
<p><strong>„KI ersetzt keine Softwareingenieure. Aber Ingenieure, die autonome KI-Agenten dirigieren, ersetzen jene, die weiterhin Zeile für Zeile von Hand tippen.“</strong></p>
</blockquote>
<p>Der menschliche Entwickler ist befreit von monotoner Tipparbeit und steigt auf in seine eigentliche Bestimmung: <strong>System-Architekt, ethischer Wächter und Dirigent intelligenter Rechensysteme</strong>.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Die autonome Software-Fabrik</strong>: Die Kombination aus Spezifikationen, Agenten-Swarms, Z3-Beweisen und eBPF ermöglicht berührungslose Zero-Human-Deployments.</li>
<li class=""><strong>KI-Flottenmanagement</strong>: Der Betrieb hunderter Agenten erfordert strikte Token-Budgets, Sandbox-Sicherheit und automatisierte Architektur-Schutzplanken.</li>
<li class=""><strong>Vom Typisten zum Dirigenten</strong>: Die Wertschöpfung verschiebt sich vollständig von manueller Syntax-Erzeugung hin zu strategischem Systemdesign und Verifikation.</li>
<li class=""><strong>Informatik-Renaissance</strong>: Fundierte Grundlagenkenntnisse in verteilten Systemen, Betriebssystemen und Logik sind wichtiger denn je.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/2026-10-31-stanford-cs146s-10#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="autonomous-engineering" term="autonomous-engineering"/>
        <category label="zero-human-deployments" term="zero-human-deployments"/>
        <category label="ai-fleets" term="ai-fleets"/>
        <category label="software-future" term="software-future"/>
        <category label="agent-swarms" term="agent-swarms"/>
        <category label="system-governance" term="system-governance"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #9] Autonomes TDD & Formale Verifikation: Z3 SMT-Solver, Property-basierte Invarianten und mathematische Beweise für KI-generierten Code]]></title>
        <id>https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9</id>
        <link href="https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9"/>
        <updated>2026-10-30T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 9: Jenseits empirischer Unittests — Wie autonome KI-Agenten mittels Property-Based Testing (PBT), symbolischer Ausführung und dem Z3 SMT-Solver mathematisch beweisbare Korrektheit für sicherheitskritischen Code garantieren.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Autonomes TDD und Formale Verifikation mit Z3 SMT Solver" src="https://globaldevlog.com/de/assets/images/09_cs146s_autonomous_tdd_formal_verification-16bf63996d87930e9381d8ab68a835fa.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zum neunten Teil unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In den vorherigen Vorlesungen haben wir uns mit Prompting, MCP, Multi-Agenten-Swarms, eBPF und KI-nativer Architektur befasst. In <strong>Vorlesung 9</strong> widmet sich der Stanford-Lehrplan dem ultimativen Dilemma moderner Softwareentwicklung: <strong>Wie können Teams probabilistischen, nicht-deterministischen Sprachmodellen vertrauen, wenn es um sicherheitskritischen, fehlerfreien Code in Finanzsystemen, Luft- und Raumfahrt, Kryptographie und verteilten Systemen geht?</strong></p>
<p>Wie Edsger Dijkstra vor über 50 Jahren treffend formulierte: <em>„Program testing can be used to show the presence of bugs, but never to show their absence!“</em> In dieser Vorlesung zeigen Stanford-Forscher den Übergang von beispielbasierten Unittests zu <strong>autonomem Property-Based Testing (PBT)</strong>, <strong>symbolischer Ausführung</strong> und <strong>formaler Verifikation mit dem Z3 SMT-Solver</strong>.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-die-grenzen-beispielbasierter-unittests-bei-ki-code">1. Die Grenzen beispielbasierter Unittests bei KI-Code<a href="https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9#1-die-grenzen-beispielbasierter-unittests-bei-ki-code" class="hash-link" aria-label="Direkter Link zur 1. Die Grenzen beispielbasierter Unittests bei KI-Code" title="Direkter Link zur 1. Die Grenzen beispielbasierter Unittests bei KI-Code" translate="no">​</a></h3>
<p>Bei traditionellen Unittests prüfen Entwickler wenige Einzelbeispiele:</p>
<div class="language-python codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-python codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token keyword" style="color:#00009f">def</span><span class="token plain"> </span><span class="token function" style="color:#d73a49">test_calculate_fee</span><span class="token punctuation" style="color:#393A34">(</span><span class="token punctuation" style="color:#393A34">)</span><span class="token punctuation" style="color:#393A34">:</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><span class="token keyword" style="color:#00009f">assert</span><span class="token plain"> calculate_fee</span><span class="token punctuation" style="color:#393A34">(</span><span class="token number" style="color:#36acaa">100</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"> </span><span class="token operator" style="color:#393A34">==</span><span class="token plain"> </span><span class="token number" style="color:#36acaa">5</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><span class="token keyword" style="color:#00009f">assert</span><span class="token plain"> calculate_fee</span><span class="token punctuation" style="color:#393A34">(</span><span class="token number" style="color:#36acaa">0</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"> </span><span class="token operator" style="color:#393A34">==</span><span class="token plain"> </span><span class="token number" style="color:#36acaa">0</span><br></div></code></pre></div></div>
<p>Wenn ein KI-Programmieragent Code schreibt, um diese Tests zu bestehen, entsteht häufig <strong>Test Overfitting</strong>:</p>
<ul>
<li class="">Der Agent implementiert eine Logik, die exakt diese 2 Fälle besteht, aber bei negativen Zahlen, Integer-Überläufen oder extremen Werten unbemerkt versagt.</li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-property-based-testing-pbt-mit-hypothesis">2. Property-Based Testing (PBT) mit Hypothesis<a href="https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9#2-property-based-testing-pbt-mit-hypothesis" class="hash-link" aria-label="Direkter Link zur 2. Property-Based Testing (PBT) mit Hypothesis" title="Direkter Link zur 2. Property-Based Testing (PBT) mit Hypothesis" translate="no">​</a></h3>
<p>Statt einzelner Werte definiert der Entwickler universelle mathematische <strong>Invarianten</strong>:</p>
<p><code>orall x \in 	ext{Inputs}, \quad 	ext{Property}(f(x)) = 	ext{True}</code></p>
<div class="language-python codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-python codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token keyword" style="color:#00009f">from</span><span class="token plain"> hypothesis </span><span class="token keyword" style="color:#00009f">import</span><span class="token plain"> given</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"> strategies </span><span class="token keyword" style="color:#00009f">as</span><span class="token plain"> st</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token decorator annotation punctuation" style="color:#393A34">@given</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">st</span><span class="token punctuation" style="color:#393A34">.</span><span class="token plain">integers</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">min_value</span><span class="token operator" style="color:#393A34">=</span><span class="token number" style="color:#36acaa">0</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"> max_value</span><span class="token operator" style="color:#393A34">=</span><span class="token number" style="color:#36acaa">1_000_000</span><span class="token punctuation" style="color:#393A34">)</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token keyword" style="color:#00009f">def</span><span class="token plain"> </span><span class="token function" style="color:#d73a49">test_fee_always_less_than_amount</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">amount</span><span class="token punctuation" style="color:#393A34">)</span><span class="token punctuation" style="color:#393A34">:</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    fee </span><span class="token operator" style="color:#393A34">=</span><span class="token plain"> calculate_fee</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">amount</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><span class="token keyword" style="color:#00009f">assert</span><span class="token plain"> </span><span class="token number" style="color:#36acaa">0</span><span class="token plain"> </span><span class="token operator" style="color:#393A34">&lt;=</span><span class="token plain"> fee </span><span class="token operator" style="color:#393A34">&lt;=</span><span class="token plain"> amount</span><br></div></code></pre></div></div>
<p>Das Test-Framework generiert tausende stochastische Randfälle, findet minimale Gegenbeispiele (<em>Shrinking</em>) und zwingt den KI-Agenten, die vollständige mathematische Logik korrekt zu implementieren.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-formale-verifikation-mit-dem-z3-smt-solver">3. Formale Verifikation mit dem Z3 SMT-Solver<a href="https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9#3-formale-verifikation-mit-dem-z3-smt-solver" class="hash-link" aria-label="Direkter Link zur 3. Formale Verifikation mit dem Z3 SMT-Solver" title="Direkter Link zur 3. Formale Verifikation mit dem Z3 SMT-Solver" translate="no">​</a></h3>
<p>Die höchste Stufe der Verifikation ist die mathematische Beweisführung mittels SMT-Solver (Satisfiability Modulo Theories):</p>
<div class="language-python codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-python codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token keyword" style="color:#00009f">from</span><span class="token plain"> z3 </span><span class="token keyword" style="color:#00009f">import</span><span class="token plain"> Int</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"> Solver</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"> sat</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"> unsat</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token comment" style="color:#999988;font-style:italic"># Formale Invarianten-Prüfung</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">balance </span><span class="token operator" style="color:#393A34">=</span><span class="token plain"> Int</span><span class="token punctuation" style="color:#393A34">(</span><span class="token string" style="color:#e3116c">'balance'</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">withdrawal </span><span class="token operator" style="color:#393A34">=</span><span class="token plain"> Int</span><span class="token punctuation" style="color:#393A34">(</span><span class="token string" style="color:#e3116c">'withdrawal'</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">s </span><span class="token operator" style="color:#393A34">=</span><span class="token plain"> Solver</span><span class="token punctuation" style="color:#393A34">(</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token comment" style="color:#999988;font-style:italic"># Postcondition: Kontostand darf niemals negativ werden</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">new_balance </span><span class="token operator" style="color:#393A34">=</span><span class="token plain"> balance </span><span class="token operator" style="color:#393A34">-</span><span class="token plain"> withdrawal</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">s</span><span class="token punctuation" style="color:#393A34">.</span><span class="token plain">add</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">balance </span><span class="token operator" style="color:#393A34">&gt;=</span><span class="token plain"> </span><span class="token number" style="color:#36acaa">0</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">s</span><span class="token punctuation" style="color:#393A34">.</span><span class="token plain">add</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">withdrawal </span><span class="token operator" style="color:#393A34">&gt;</span><span class="token plain"> </span><span class="token number" style="color:#36acaa">0</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">s</span><span class="token punctuation" style="color:#393A34">.</span><span class="token plain">add</span><span class="token punctuation" style="color:#393A34">(</span><span class="token plain">new_balance </span><span class="token operator" style="color:#393A34">&lt;</span><span class="token plain"> </span><span class="token number" style="color:#36acaa">0</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"> </span><span class="token comment" style="color:#999988;font-style:italic"># Gegenbeispiel suchen</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token keyword" style="color:#00009f">if</span><span class="token plain"> s</span><span class="token punctuation" style="color:#393A34">.</span><span class="token plain">check</span><span class="token punctuation" style="color:#393A34">(</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"> </span><span class="token operator" style="color:#393A34">==</span><span class="token plain"> unsat</span><span class="token punctuation" style="color:#393A34">:</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><span class="token keyword" style="color:#00009f">print</span><span class="token punctuation" style="color:#393A34">(</span><span class="token string" style="color:#e3116c">"Mathematisch bewiesen: Invariante hält für alle Eingaben!"</span><span class="token punctuation" style="color:#393A34">)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token keyword" style="color:#00009f">else</span><span class="token punctuation" style="color:#393A34">:</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><span class="token keyword" style="color:#00009f">print</span><span class="token punctuation" style="color:#393A34">(</span><span class="token string" style="color:#e3116c">"Gegenbeispiel gefunden:"</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"> s</span><span class="token punctuation" style="color:#393A34">.</span><span class="token plain">model</span><span class="token punctuation" style="color:#393A34">(</span><span class="token punctuation" style="color:#393A34">)</span><span class="token punctuation" style="color:#393A34">)</span><br></div></code></pre></div></div>
<p>Gibt Z3 <code>unsat</code> zurück, ist mathematisch bewiesen, dass unter den definierten Vorbedingungen <strong>niemals</strong> ein ungültiger Systemzustand eintreten kann — unabhängig davon, wie viele Millionen Transaktionen ausgeführt werden.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Grenzen von Beispiel-Tests</strong>: Beispielbasierte Unittests verleiten KI-Agenten zu Test-Overfitting und übersehen gefährliche Randfälle.</li>
<li class=""><strong>Property-Based Invarianten</strong>: PBT prüft universelle Systeminvarianten über tausende automatisch generierte Extremwerte.</li>
<li class=""><strong>Mathematische Beweise mit Z3</strong>: SMT-Solver beweisen die logische Korrektheit von Algorithmen formell und lückenlos.</li>
<li class=""><strong>CEGAR-Feedbackschleife</strong>: Solver-Gegenbeispiele fließen direkt als deterministisches Feedback zurück in den Agenten zur fehlerfreien Selbstheilung.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/2026-10-30-stanford-cs146s-9#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="autonomous-tdd" term="autonomous-tdd"/>
        <category label="formal-verification" term="formal-verification"/>
        <category label="z3-smt-solver" term="z3-smt-solver"/>
        <category label="property-based-testing" term="property-based-testing"/>
        <category label="software-correctness" term="software-correctness"/>
        <category label="symbolic-execution" term="symbolic-execution"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #8] KI-Native Softwarearchitektur & Refactoring: Monolithen entkoppeln, semantische Schulden abbauen und autonome Großmigrationen]]></title>
        <id>https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8</id>
        <link href="https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8"/>
        <updated>2026-10-29T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 8: Wie Architekturen für autonome KI-Agenten gestaltet werden — Abbau semantischer Schulden, Zerlegung von Legacy-Monolithen via AST-Graphen und Zero-Downtime-Code-Migrationen.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="KI-Native Softwarearchitektur und Großskaliges Refactoring" src="https://globaldevlog.com/de/assets/images/08_cs146s_ai_native_architecture_refactoring-1025ee49e0c33afaa980cb57cc384f9c.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zum achten Teil unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In den vorherigen Sitzungen haben wir Prompt-Engineering (Vorlesung 2), MCP-Werkzeuge (Vorlesung 3), selbstheilende Test-Harnesses (Vorlesung 4), Multi-Agenten-Swarms (Vorlesung 5), eBPF-Kernel-Tracing (Vorlesung 6) und automatisierte PR-Reviews (Vorlesung 7) untersucht.</p>
<p>In <strong>Vorlesung 8</strong> widmet sich der Lehrplan den systemischen Langzeitfolgen autonomer KI-Agenten: <strong>Wie entwerfen wir Softwarearchitekturen, die KI-Agenten navigieren, verstehen und modifizieren können, ohne unter explodierender Komplexität zusammenzubrechen? Und wie nutzen wir KI-Agenten, um gewachsene Legacy-Monolithen sicher zu zerlegen?</strong></p>
<p>Traditionelle Softwarearchitekturen — geprägt von globalem veränderlichem Zustand, zyklischen Abhängigkeiten und 100.000-Zeilen-Monolithen — überfordern das logische Denkvermögen von Sprachmodellen. In dieser Vorlesung formalisieren Stanford-Informatiker das Konzept der <strong>semantischen Schulden (<em>Semantic Debt</em>)</strong>, definieren die Prinzipien <strong>KI-nativer Architektur</strong> und liefern eine praxiserprobte Anleitung zur <strong>AST-gestützten Monolithen-Entkopplung</strong>.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-das-geschwindigkeitsparadoxon-technische-schulden-vs-semantische-schulden">1. Das Geschwindigkeitsparadoxon: Technische Schulden vs. Semantische Schulden<a href="https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8#1-das-geschwindigkeitsparadoxon-technische-schulden-vs-semantische-schulden" class="hash-link" aria-label="Direkter Link zur 1. Das Geschwindigkeitsparadoxon: Technische Schulden vs. Semantische Schulden" title="Direkter Link zur 1. Das Geschwindigkeitsparadoxon: Technische Schulden vs. Semantische Schulden" translate="no">​</a></h3>
<p>Klassische Softwaremetriken messen <strong>technische Schulden</strong>: veraltete Bibliotheken, unoptimierte Queries, fehlende Testabdeckung. Compiler und statische Linter erkennen diese deterministisch.</p>
<p>Wenn autonome KI-Agenten Code mit enormer Geschwindigkeit generieren, entsteht jedoch eine weitaus gefährlichere Fehlerquelle: <strong>semantische Schulden (<em>Semantic Debt</em>)</strong>.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Technical_Debt ["Traditionelle technische Schulden"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T1["Compiler-Warnungen &amp; Syntax-Fehler"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T2["Veraltete Abhängigkeiten"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T3["Linter-Verstöße &amp; Style-Issues"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        T4["Messbar durch deterministische Tools"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Semantic_Debt ["Semantische Schulden (KI-Zeitalter)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S1["Versteckte Annahmen &amp; impliziter Zustand"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S2["Subtile Schnittstellen-Inkonsistenzen"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S3["Kontext-Fragmentierung über Repositories"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S4["Syntaktisch valider Code, aber unklares Domänenmodell"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<p>Semantische Schulden entstehen, wenn Code zwar syntaktisch fehlerfrei kompiliert und alle Unittests besteht, aber die konzeptionelle Absicht so fragmentiert ist, dass kein KI-Modell mehr den gesamten Systemzusammenhang erfassen kann.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-prinzipien-ki-nativer-softwarearchitektur">2. Prinzipien KI-nativer Softwarearchitektur<a href="https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8#2-prinzipien-ki-nativer-softwarearchitektur" class="hash-link" aria-label="Direkter Link zur 2. Prinzipien KI-nativer Softwarearchitektur" title="Direkter Link zur 2. Prinzipien KI-nativer Softwarearchitektur" translate="no">​</a></h3>
<p>Um Systeme für autonome Agenten handhabbar zu halten, formuliert Stanford vier Architektur-Gebote:</p>
<ol>
<li class=""><strong>Strikte Hexagonale Architektur (Ports &amp; Adapters)</strong>: Die Geschäftslogik muss vollständig von Frameworks, Datenbanken und externen APIs entkoppelt sein. Ein Agent muss Kernlogik testen können, ohne eine Datenbank hochzufahren.</li>
<li class=""><strong>Explizite Kontextbudgets</strong>: Module dürfen maximal so groß sein, dass ihre vollständige Schnittstelle und Typdefinition in ein Viertel des aktuellen LLM-Kontextfensters passen.</li>
<li class=""><strong>Deterministische Schnittstellenverträge</strong>: Keine generischen <code>dict</code>- oder <code>JSON</code>-Objekte als Übergabeparameter. Jede Schnittstelle muss durch statische Schemata (Pydantic, Zod, Protobuf) abgesichert sein.</li>
<li class=""><strong>Zyklusfreie Abhängigkeitsgraphen</strong>: Zyklische Abhängigkeiten führen bei Agenten zu endlosen Refactoring-Schleifen.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-vorgehensmodell-ast-gestützte-monolithen-zerlegung">3. Vorgehensmodell: AST-gestützte Monolithen-Zerlegung<a href="https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8#3-vorgehensmodell-ast-gest%C3%BCtzte-monolithen-zerlegung" class="hash-link" aria-label="Direkter Link zur 3. Vorgehensmodell: AST-gestützte Monolithen-Zerlegung" title="Direkter Link zur 3. Vorgehensmodell: AST-gestützte Monolithen-Zerlegung" translate="no">​</a></h3>
<p>Die sichere Migration eines Monolithen in modulare Services erfolgt in vier Phasen:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">stateDiagram-v2</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    [*] --&gt; AST_Analysis: 1. Statische Abhängigkeitsanalyse via AST</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    AST_Analysis --&gt; Cluster_Detection: 2. Erkennung schwach gekoppelter Domänen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Cluster_Detection --&gt; Interface_Synthesis: 3. Agent generiert typsichere Fassaden</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Interface_Synthesis --&gt; Shadow_Execution: 4. Paralleler Schattenbetrieb zur Validierung</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Shadow_Execution --&gt; Cutover: Verifizierte Migration ohne Downtime</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Cutover --&gt; [*]</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Semantische Schulden erkennen</strong>: Nicht kompilierbare Syntax ist das Problem von gestern; die größte Gefahr heute ist syntaktisch korrekter Code mit fragmentierter semantischer Logik.</li>
<li class=""><strong>KI-Native Architektur</strong>: Strikte Modularität, zyklenfreie Graphen und typsichere Schnittstellenverträge sind die Voraussetzung für erfolgreiche Agenten-Entwicklung.</li>
<li class=""><strong>AST-gestützte Zerlegung</strong>: Mittels AST-Aufrufgraphen identifizieren Agenten Modulgrenzen objektiv und generieren Entkopplungsfassaden.</li>
<li class=""><strong>Schattenbetrieb schützt Produktion</strong>: Vor dem endgültigen Schnitt stellt die parallele Schattenausführung die vollständige Verhaltensgleichheit sicher.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/2026-10-29-stanford-cs146s-8#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="ai-native-architecture" term="ai-native-architecture"/>
        <category label="software-refactoring" term="software-refactoring"/>
        <category label="semantic-debt" term="semantic-debt"/>
        <category label="monolith-decoupling" term="monolith-decoupling"/>
        <category label="autonomous-migration" term="autonomous-migration"/>
        <category label="code-modernization" term="code-modernization"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #7] Automatisiertes Code-Review im großen Maßstab: AST-basierte Linter, Sicherheits-Taint-Analyse und autonome LLM-PR-Reviewer]]></title>
        <id>https://globaldevlog.com/de/blog/2026-10-28-stanford-cs146s-7</id>
        <link href="https://globaldevlog.com/de/blog/2026-10-28-stanford-cs146s-7"/>
        <updated>2026-10-28T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 7: Wie Ingenieurteams Code-Reviews skalieren — Kombination aus Abstract Syntax Tree (AST) Lintern, statischer Taint-Analyse und semantischen LLM-PR-Reviewern gegen Stil-Diskussionen und Sicherheitslücken.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Automatisiertes Code-Review im großen Maßstab Architektur" src="https://globaldevlog.com/de/assets/images/07_cs146s_code_review_at_scale-1414c40be07447ba6b3624c85038381e.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zu Vorlesung 7 unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In der vorherigen Vorlesung behandelten wir die Behebung von Produktions-Incidents mittels eBPF und KI-SREs. Doch wie jede erfahrene technische Führungskraft weiß: Der kostengünstigste Fehler ist jener, der <strong>gar nicht erst in den Main-Branch gemergt wird</strong>.</p>
<p>In modernen Softwareorganisationen ist das Pull-Request-Code-Review (PR-Review) der zentrale Gatekeeper für Codequalität, architektonische Integrität und Sicherheit. Doch mit wachsenden Teams degeneriert das menschliche Code-Review oft zu einem massiven operativen Engpass. Senior Engineers verbringen 15 bis 20 Stunden pro Woche mit Diff-Inspektionen, ermüden bei stilistischen Kleinigkeiten (<em>Bikeshedding</em>) und übersehen bei riesigen 1.000-Zeilen-Änderungen aus Erschöpfung (<em>Review Fatigue</em>) kritische Concurrency-Races oder SQL-Injections.</p>
<p>In dieser Vorlesung präsentieren die Stanford-Dozenten den Bauplan für <strong>Automatisiertes Code-Review im großen Maßstab</strong>. Durch eine dreistufige Hierarchie aus <strong>AST-Lintern (Tree-sitter, Semgrep)</strong>, <strong>statischer Taint-Analyse</strong> und <strong>autonomen LLM-PR-Reviewern</strong> lassen sich 90 % der manuellen Review-Mühen eliminieren und Sicherheitslücken zuverlässig stoppen.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-die-krise-des-manuellen-code-reviews">1. Die Krise des manuellen Code-Reviews<a href="https://globaldevlog.com/de/blog/2026-10-28-stanford-cs146s-7#1-die-krise-des-manuellen-code-reviews" class="hash-link" aria-label="Direkter Link zur 1. Die Krise des manuellen Code-Reviews" title="Direkter Link zur 1. Die Krise des manuellen Code-Reviews" translate="no">​</a></h3>
<p>Warum stößt das rein menschliche Peer-Review an Skalierungsgrenzen?</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Review_Breakdown ["Die drei Kernprobleme menschlicher Reviews"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1["Bikeshedding-Falle"] --&gt; A2["Lange Diskussionen über Formatierung und Namenskonventionen"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A2 --&gt; A3["Review-Latenz: PR liegt 3 Tage ungemergt wegen Formatierungs-Nitpicks"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B1["Kognitive Review-Ermüdung"] --&gt; B2["10 Zeilen Diff: 10 kritische Kommentare.&lt;br/&gt;1.000 Zeilen Diff: 'LGTM' (Looks Good To Me)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B2 --&gt; B3["Sicherheitslücken entwischen unbemerkt in den Main-Branch"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C1["Kontext-Blindheit"] --&gt; C2["Mensch prüft nur Diff-Ausschnitte, nicht den gesamten Aufrufgraphen"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-dreistufige-automatisierte-review-hierarchie">2. Die dreistufige automatisierte Review-Hierarchie<a href="https://globaldevlog.com/de/blog/2026-10-28-stanford-cs146s-7#2-die-dreistufige-automatisierte-review-hierarchie" class="hash-link" aria-label="Direkter Link zur 2. Die dreistufige automatisierte Review-Hierarchie" title="Direkter Link zur 2. Die dreistufige automatisierte Review-Hierarchie" translate="no">​</a></h3>
<p>Stanford schlägt eine klare Arbeitsteilung vor:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    PR[Neuer Pull Request eingehend] --&gt; Tier1["Stufe 1: AST-Linter (Tree-sitter / Semgrep)&lt;br/&gt;Laufzeit: &lt; 2 Sek. | Deterministisch"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Tier1 --&gt;|Syntax- oder Boundary-Fehler| Block1[PR sofort blockiert mit Inline-Fix]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Tier1 --&gt;|Bestanden| Tier2["Stufe 2: Inter-prozedurale Taint-Analyse&lt;br/&gt;Verfolgt Datenflüsse: Untrusted Input -&gt; Sink"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Tier2 --&gt;|SQLi / XSS / RCE Pfad erkannt| Block2[PR blockiert mit Taint-Graph]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Tier2 --&gt;|Bestanden| Tier3["Stufe 3: Autonomer LLM PR-Reviewer&lt;br/&gt;Semantische Absicht &amp; Architektur-Drift"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Tier3 --&gt;|Bestanden| Human[Finales menschliches Sign-Off]</span><br></div></code></pre></div></div>
<ol>
<li class=""><strong>Stufe 1 (AST-Linter)</strong>: Prüft Syntaxmuster und verbietet unsichere APIs deterministisch in Millisekunden.</li>
<li class=""><strong>Stufe 2 (Taint-Analyse)</strong>: Prüft, ob unvalidierte Benutzereingaben in kritische Ausführungssenken (SQL-Queries, <code>eval()</code>) gelangen.</li>
<li class=""><strong>Stufe 3 (LLM PR-Reviewer)</strong>: Bewertet semantische Logik, API-Vertragskonsistenz und Architekturschulden.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-10-28-stanford-cs146s-7#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Automatisierung gegen Ermüdung</strong>: Reines menschliches Code-Review scheitert bei großen Diffs an kognitiver Erschöpfung und Bikeshedding.</li>
<li class=""><strong>Dreistufige Verteidigung</strong>: AST-Linter für Syntax, Taint-Analyse für Datensicherheit und semantische LLM-Reviewer für Architektur-Integrität.</li>
<li class=""><strong>Drastische Latenzsenkung</strong>: 90 % der mechanischen Review-Schritte werden sofort im CI-Lauf abgearbeitet.</li>
<li class=""><strong>Fokus auf Architektur</strong>: Menschliche Senior Engineers konzentrieren sich ausschließlich auf strategische Design- und Sicherheitsentscheidungen.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/2026-10-28-stanford-cs146s-7#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford" term="stanford"/>
        <category label="cs146s" term="cs146s"/>
        <category label="code-review" term="code-review"/>
        <category label="static-analysis" term="static-analysis"/>
        <category label="ast" term="ast"/>
        <category label="taint-analysis" term="taint-analysis"/>
        <category label="llm-pr-review" term="llm-pr-review"/>
        <category label="devops" term="devops"/>
        <category label="security" term="security"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #6] KI-gestütztes Debugging & Laufzeit-Profiling: eBPF, dynamisches Tracing und LLMs zur automatisierten Incident-Behebung]]></title>
        <id>https://globaldevlog.com/de/blog/2026-10-27-stanford-cs146s-6</id>
        <link href="https://globaldevlog.com/de/blog/2026-10-27-stanford-cs146s-6"/>
        <updated>2026-10-27T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 6: Wie die Kombination aus extended Berkeley Packet Filters (eBPF) und LLM-Diagnoseagenten das Laufzeit-Debugging revolutioniert — von non-intrusivem Kernel-Tracing bis zum automatisierten Hotpatch.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="KI-gestütztes Debugging und eBPF Dynamisches Tracing Architektur" src="https://globaldevlog.com/de/assets/images/06_cs146s_ai_debugging_ebpf-7fab4ae8c85f4f2cad0eecf08d4031fd.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zu Vorlesung 6 unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In der vorherigen Vorlesung behandelten wir die Multi-Agenten-Swarm-Orchestrierung zur Erstellung modularer Codebasen. Doch selbst die am sorgfältigsten getestete Software trifft früher oder später auf die unberechenbare Realität der Produktionsumgebung.</p>
<p>Um 3:00 Uhr morgens, wenn ein obskurer Concurrency-Deadlock einen verteilten Zahlungscluster blockiert oder ein unindexierter Datenbank-Query die Tail-Latenz auf 12 Sekunden ansteigen lässt, versagen traditionelle Debugging-Methoden. Statische Analysen können dynamische Race Conditions nicht vorhersehen, invasives <code>printf</code>-Logging verändert das Timing und maskiert den Fehler (<em>Heisenbug-Effekt</em>), und verteilte Logging-Systeme überfluten Site Reliability Engineers (SREs) mit Gigabytes unstrukturierter Log-Daten.</p>
<p>In dieser Vorlesung stellen Stanford-Dozenten die nächste Stufe softwaretechnischer Resilienz vor: <strong>KI-gestütztes Debugging &amp; Laufzeit-Profiling</strong>. Durch die Verknüpfung von <strong>extended Berkeley Packet Filters (eBPF)</strong> mit spezialisierten <strong>LLM-SRE-Diagnoseagenten</strong> können Entwickler Kernel-Zustände ohne messbaren Overhead in Echtzeit erfassen, Ursachen automatisiert identifizieren und Hotfixes in Minuten statt Stunden bereitstellen.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-das-dilemma-traditionellen-produktions-debuggings">1. Das Dilemma traditionellen Produktions-Debuggings<a href="https://globaldevlog.com/de/blog/2026-10-27-stanford-cs146s-6#1-das-dilemma-traditionellen-produktions-debuggings" class="hash-link" aria-label="Direkter Link zur 1. Das Dilemma traditionellen Produktions-Debuggings" title="Direkter Link zur 1. Das Dilemma traditionellen Produktions-Debuggings" translate="no">​</a></h3>
<p>Beim Ausfall von Hochdurchsatz-Microservices stehen Softwareingenieure vor drei bekannten Paradoxien:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Traditional_Failure ["Schwachstellen traditionellen Produktions-Triages"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1["Invasives Logging / Debug-Hooks"] --&gt; A2["Heisenbug-Effekt: Timing verändert sich, Fehler verschwindet unter Beobachtung"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B1["Verteiltes APM &amp; Log-Aggregation"] --&gt; B2["Log-Blindheit: Millionen JSON-Zeilen/Sek. überdecken den Root-Cause"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B2 --&gt; B3["Kontextüberflutung: Menschen können pod-übergreifende Thread-Zustände nicht korrelieren"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C1["Post-Mortem Core Dumps"] --&gt; C2["Hohe Downtime: Service muss abstürzen, um Speicherzustand zu erfassen"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-lösung-ebpf-kernel-observability--ki-diagnostiker">2. Die Lösung: eBPF-Kernel-Observability + KI-Diagnostiker<a href="https://globaldevlog.com/de/blog/2026-10-27-stanford-cs146s-6#2-die-l%C3%B6sung-ebpf-kernel-observability--ki-diagnostiker" class="hash-link" aria-label="Direkter Link zur 2. Die Lösung: eBPF-Kernel-Observability + KI-Diagnostiker" title="Direkter Link zur 2. Die Lösung: eBPF-Kernel-Observability + KI-Diagnostiker" translate="no">​</a></h3>
<p>eBPF ermöglicht es, sichere Bytecode-Programme direkt im Linux-Kernel auszuführen, ohne den Kernel neu zu kompilieren oder Module zu laden. Dadurch werden Netzwerk-Sockets, Syscalls und Kprobes mit nahezu 0 % Overhead überwacht.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">sequenceDiagram</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    autonumber</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant K as Linux-Kernel (eBPF Probes)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant RB as Lockless Ring Buffer</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant D as AI SRE Agent (LLM Diagnostiker)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant GH as GitHub CI / Hotpatch Pipeline</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    K-&gt;&gt;RB: Erfasse Syscall-Latenz &amp; Socket-Locking in Echtzeit</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    RB--&gt;&gt;D: Stream telemetrischer Events (Flamegraph &amp; Latenz-Spikes)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    D-&gt;&gt;D: LLM analysiert Kernel-Trace &amp; korreliert mit Quellcode</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    D--&gt;&gt;D: Root Cause identifiziert: Mutex-Contention in worker_pool.rs:142</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    D-&gt;&gt;GH: Generiere Hotpatch-Pull-Request mit atomarem Fix</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-10-27-stanford-cs146s-6#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Grenzen traditionellen Debuggings</strong>: Invasives Logging verändert Race-Condition-Timings (Heisenbugs) und APM-Tools überfluten Ingenieure mit Log-Rauschen.</li>
<li class=""><strong>eBPF-Präzision</strong>: Kernel-Level-Tracing fängt Systemaufrufe und Latenz-Spikes ohne Overhead und ohne Code-Modifikationen ab.</li>
<li class=""><strong>Automatisierte Ursachenanalyse</strong>: LLM-SRE-Agenten analysieren Ring-Buffer-Telemetrie und lokalisieren Concurrency-Engpässe im Quellcode präzise.</li>
<li class=""><strong>Minutenschnelle Mitigation</strong>: Vom automatisierten Trace-Parsing bis zur Synthese eines verifizierten Hotpatches wird die Incident-Dauer drastisch reduziert.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/2026-10-27-stanford-cs146s-6#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford" term="stanford"/>
        <category label="cs146s" term="cs146s"/>
        <category label="ebpf" term="ebpf"/>
        <category label="dynamic-tracing" term="dynamic-tracing"/>
        <category label="ai-debugging" term="ai-debugging"/>
        <category label="incident-response" term="incident-response"/>
        <category label="site-reliability-engineering" term="site-reliability-engineering"/>
        <category label="linux-kernel" term="linux-kernel"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #5] Multi-Agenten-Systeme & Swarm-Orchestrierung: Koordination von Architekt-, Implementierer- und Kritiker-LLMs]]></title>
        <id>https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5</id>
        <link href="https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5"/>
        <updated>2026-10-26T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 5: Warum monolithische Single-Context-LLMs bei großen Repositories scheitern und wie spezialisierte Architekt-, Implementierer- und Kritiker-Agenten in asynchronen DAG-Workflows koordiniert werden.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Multi-Agenten Swarm Orchestrierungsarchitektur" src="https://globaldevlog.com/de/assets/images/05_cs146s_multi_agent_swarm-167b4e5a9c0071597a8747735c93dae7.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zu Vorlesung 5 unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In den bisherigen Vorlesungen haben wir Prompt Engineering, Transformer-Mechanismen, das Model Context Protocol (MCP) und selbstheilende Test-Harnesses analysiert. All diese Paradigmen basierten auf einer gemeinsamen Annahme: einer <strong>einzelnen primären LLM-Sitzung</strong>, die mit einem Entwickler oder Workspace interagiert.</p>
<p>Sobald ein Softwareprojekt jedoch über einige tausend Zeilen Code und verteilte Microservices hinauswächst, bricht dieser monolithische Ansatz zusammen. Single-Agenten leiden unter <strong>Kontextüberlastung, Aufmerksamkeitsverwässerung (<em>Attention Dilution</em>) und kognitiver Blockade</strong>.</p>
<p>In dieser Vorlesung präsentieren die Stanford-Dozenten die Zukunft des AI-Native Engineerings: <strong>Multi-Agenten-Systeme (MAS) und Swarm-Orchestrierung</strong>. Wir untersuchen, wie die klare Aufgabenteilung in spezialisierte <strong>Architekten, Implementierer und Kritiker</strong> über strukturierte Message-Busses und Directed Acyclic Graphs (DAGs) Genauigkeit und Skalierbarkeit um ein Vielfaches steigert.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-die-skalierungsgrenzen-monolithischer-single-agenten">1. Die Skalierungsgrenzen monolithischer Single-Agenten<a href="https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5#1-die-skalierungsgrenzen-monolithischer-single-agenten" class="hash-link" aria-label="Direkter Link zur 1. Die Skalierungsgrenzen monolithischer Single-Agenten" title="Direkter Link zur 1. Die Skalierungsgrenzen monolithischer Single-Agenten" translate="no">​</a></h3>
<p>Warum können wir nicht einfach ein 500.000 Zeilen umfassendes Enterprise-Repository in ein 1-Millionen-Token-Kontextfenster laden und das Modell bitten, „die gesamte Abrechnungspipeline zu refaktorisieren“?</p>
<p>Stanford-Forscher identifizieren drei fundamentale Flaschenhälse:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Monolithic_Failure ["Flaschenhälse monolithischer Single-Agenten"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1["Massiver Kontext (500k+ Tokens)"] --&gt; A2["Attention Dilution &amp; Needle-in-a-Haystack-Verfall"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A2 --&gt; A3["Instruction Drift: Modell vergisst frühe Vorgaben beim Lesen späterer Dateien"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B1["Rollenkollusion im Einzelagenten"] --&gt; B2["Self-Confirmation Bias: Generator hält fehlerhaften Code für richtig"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B2 --&gt; B3["Halluzinations-Falle: Fehlende objektive Gegenprüfung"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C1["Sequenzielle Ausführung"] --&gt; C2["Hohe Latenz: Ein einzelner Thread bearbeitet Aufgaben seriell"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-das-architekt-implementierer-kritiker-muster-aic">2. Das Architekt-Implementierer-Kritiker-Muster (AIC)<a href="https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5#2-das-architekt-implementierer-kritiker-muster-aic" class="hash-link" aria-label="Direkter Link zur 2. Das Architekt-Implementierer-Kritiker-Muster (AIC)" title="Direkter Link zur 2. Das Architekt-Implementierer-Kritiker-Muster (AIC)" translate="no">​</a></h3>
<p>Die Lösung von Stanford CS146S ist die funktionale Entkopplung in drei spezialisierte Agenten-Rollen:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    User[Menschlicher Architekt / PRD] --&gt; Arch[1. Lead Architect Agent]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Arch --&gt;|Aufteilung in Teilaufgaben &amp; API-Schemata| Impl1[2a. Implementierer Modul A]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Arch --&gt;|Parallelisierung| Impl2[2b. Implementierer Modul B]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Impl1 --&gt; Critic[3. Critic &amp; Verifier Agent]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Impl2 --&gt; Critic</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Critic --&gt;|Feedback bei Mängeln| Impl1</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Critic --&gt;|Testsuite 100% grün &amp; Security-Audit bestanden| Output[Zusammengeführter Codebestand]</span><br></div></code></pre></div></div>
<ol>
<li class=""><strong>Lead Architect Agent</strong>: Analysiert das PRD, zerlegt das Gesamtproblem in einen gerichteten azyklischen Aufgabengraphen (DAG) und definiert strikte Schnittstellenverträge.</li>
<li class=""><strong>Implementer Agents</strong>: Mehrere spezialisierte Instanzen, die parallel und unabhängig voneinander einzelne Module implementieren.</li>
<li class=""><strong>Critic &amp; Verifier Agent</strong>: Führt deterministische Sicherheitsprüfungen, Linter und Integrations-Tests durch. Da der Kritiker den Code nicht selbst geschrieben hat, ist er frei vom <em>Self-Confirmation Bias</em>.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-asynchrone-dag-orchestrierung--shared-memory">3. Asynchrone DAG-Orchestrierung &amp; Shared Memory<a href="https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5#3-asynchrone-dag-orchestrierung--shared-memory" class="hash-link" aria-label="Direkter Link zur 3. Asynchrone DAG-Orchestrierung &amp; Shared Memory" title="Direkter Link zur 3. Asynchrone DAG-Orchestrierung &amp; Shared Memory" translate="no">​</a></h3>
<p>Damit Agenten ohne gegenseitiges Blockieren zusammenarbeiten können, setzt das System auf strukturierte JSON-Nachrichten und ein gemeinsames Shared Blackboard (Context Memory).</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Grenzen monolithischer Modelle</strong>: Single-Context-Agenten leiden bei großen Repositories unter Attention Dilution und Self-Confirmation Bias.</li>
<li class=""><strong>Architekt-Implementierer-Kritiker</strong>: Funktionale Trennung ermöglicht parallele Entwicklung und unabhängige Qualitätskontrolle.</li>
<li class=""><strong>DAG-Workflows</strong>: Asynchrone Aufgabengraphen verhindern Blockaden und skalieren die Entwicklungsgeschwindigkeit massiv.</li>
<li class=""><strong>Strukturierte Schnittstellen</strong>: Strikte JSON-Schemata zwischen Agenten garantieren Konsistenz und deterministische Ergebnisse.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/2026-10-26-stanford-cs146s-5#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford" term="stanford"/>
        <category label="cs146s" term="cs146s"/>
        <category label="multi-agent-systems" term="multi-agent-systems"/>
        <category label="swarm-orchestration" term="swarm-orchestration"/>
        <category label="llm-agents" term="llm-agents"/>
        <category label="software-engineering" term="software-engineering"/>
        <category label="distributed-systems" term="distributed-systems"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #4] Spezifikationsgestützte Codegenerierung & Test-Harnesses: Selbstheilende Regressionsschleifen mit Claude Code & Cursor]]></title>
        <id>https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses</id>
        <link href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses"/>
        <updated>2026-10-25T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 4: Wie Ingenieure der 'Vibe Coding'-Falle entkommen — Aufbau geschlossener Test-Harnesses und selbstheilender Red-Green-Refactor-Zyklen mit Claude Code und Cursor.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Spezifikationsgestützte Codegenerierung und selbstheilendes Test-Harness" src="https://globaldevlog.com/de/assets/images/04_cs146s_spec_driven_test_harness-52902930f8015057180303c53d047e57.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zum vierten Teil unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In Vorlesung 1 analysierten wir den Wandel zum Dirigenten, in Vorlesung 2 die Funktionsweise von Coding-LLMs und in Vorlesung 3 das Model Context Protocol (MCP). In <strong>Vorlesung 4 (Woche 3)</strong> widmet sich das Curriculum der drängendsten praktischen Herausforderung von Softwareteams: <strong>Wie bauen wir komplexe, vieltausendzeilige Softwaresysteme zuverlässig, wenn LLMs unvermeidlich halluzinieren, schleichende Regressionen einführen und von Produktanforderungen abweichen?</strong></p>
<p>Die naive Vorgehensweise — in sozialen Medien oft als „Vibe Coding“ oder dialogisches Prompt-and-Pray bezeichnet — versagt in produktionskritischen Umgebungen vollständig. Basierend auf Stanfords Software-Engineering-Laborexperimenten stellt diese Vorlesung das <strong>Spec-Driven Development (SDD)</strong> vor und zeigt, wie mit modernen Werkzeugen wie Claude Code und Cursor ein automatisiertes <strong>Test-Harness</strong> mit <strong>selbstheilenden Feedback-Schleifen</strong> implementiert wird.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-der-trugschluss-des-vibe-coding-warum-prompting-ohne-spezifikation-verfällt">1. Der Trugschluss des „Vibe Coding“: Warum Prompting ohne Spezifikation verfällt<a href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses#1-der-trugschluss-des-vibe-coding-warum-prompting-ohne-spezifikation-verf%C3%A4llt" class="hash-link" aria-label="Direkter Link zur 1. Der Trugschluss des „Vibe Coding“: Warum Prompting ohne Spezifikation verfällt" title="Direkter Link zur 1. Der Trugschluss des „Vibe Coding“: Warum Prompting ohne Spezifikation verfällt" translate="no">​</a></h3>
<p>Wenn Entwickler rein dialogisch mit KI-Agenten interagieren, steigt die Systementropie mit jedem Konversationsschritt kontinuierlich an:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Vibe_Coding_Entropy ["Das Anti-Pattern: Conversational Vibe Coding"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        V1["Vager Prompt: 'Füge Zahlungs-Checkout hinzu'"] --&gt; V2["LLM generiert 300 Zeilen Code"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        V2 --&gt; V3["Entwickler überfliegt den Code (Sieht plausibel aus)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        V3 --&gt; V4["Merge in den Main-Branch"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        V4 --&gt; V5["Nächster Prompt: 'Füge Rabattgutscheine hinzu'"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        V5 --&gt; V6["LLM überschreibt stillschweigend Zahlungsstatus-Logik"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        V6 --&gt; V7["Katastrophale Regression in der Produktion"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Spec_Driven_Determinism ["Stanford CS146S: Spec-Driven Development (SDD)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S1["Formale Spezifikation (PRD &amp; Schnittstellenvertrag)"] --&gt; S2["Deterministische Testsuite (Harness)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S2 --&gt; S3["KI-Codegenerierung (Claude Code / Cursor)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S3 --&gt; S4["Automatisierte Testausführung (pytest / vitest)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S4 --&gt;|Tests rot| S5["Selbstkorrekturschleife mit Fehlertraces"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S5 --&gt; S3</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        S4 --&gt;|Alle Tests grün| S6["Verifizierter Merge ohne Regressionen"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<p>„Vibe Coding“ scheitert, weil das Sprachmodell im Chatverlauf frühere Randbedingungen vergisst (<em>Attention Dilution</em>) und keine objektive Instanz existiert, die das Ergebnis prüft.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-das-geschlossene-test-harness-der-red-green-refactor-loop-für-agenten">2. Das geschlossene Test-Harness: Der Red-Green-Refactor-Loop für Agenten<a href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses#2-das-geschlossene-test-harness-der-red-green-refactor-loop-f%C3%BCr-agenten" class="hash-link" aria-label="Direkter Link zur 2. Das geschlossene Test-Harness: Der Red-Green-Refactor-Loop für Agenten" title="Direkter Link zur 2. Das geschlossene Test-Harness: Der Red-Green-Refactor-Loop für Agenten" translate="no">​</a></h3>
<p>Im Spec-Driven Development fungiert das Test-Harness als deterministische Leitplanke:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">stateDiagram-v2</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    [*] --&gt; SpecDefinition: Entwickler definiert Invarianten in SPEC.md</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    SpecDefinition --&gt; TestGeneration: Generiere Unit- &amp; Property-Tests (RED)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    TestGeneration --&gt; AgentCoding: KI-Agent implementiert den Code</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    state Self_Healing_Loop {</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        [*] --&gt; RunHarness</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        RunHarness --&gt; AnalyzeTrace: Test schlägt fehl (Assertion Error)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        AnalyzeTrace --&gt; SynthesizePatch: Agent repariert isolierte Zeilen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        SynthesizePatch --&gt; RunHarness: Erneuter Testlauf</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    }</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    AgentCoding --&gt; Self_Healing_Loop</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Self_Healing_Loop --&gt; AllGreen: Alle Tests erfolgreich (GREEN)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    AllGreen --&gt; Refactor: Code-Bereinigung &amp; Typprüfung</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Refactor --&gt; Done: Produktionsreifer Pull Request</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Done --&gt; [*]</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-drei-goldenen-regeln-des-harness-engineerings">Die drei goldenen Regeln des Harness-Engineerings:<a href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses#die-drei-goldenen-regeln-des-harness-engineerings" class="hash-link" aria-label="Direkter Link zur Die drei goldenen Regeln des Harness-Engineerings:" title="Direkter Link zur Die drei goldenen Regeln des Harness-Engineerings:" translate="no">​</a></h4>
<ol>
<li class=""><strong>Tests zuerst schreiben</strong>: Die Akzeptanzkriterien müssen definiert sein, bevor der Agent Implementierungszeilen erzeugt.</li>
<li class=""><strong>Unveränderliche Testdateien</strong>: Der Agent darf während der Selbstkorrektur nur die Implementierungsdateien anpassen — niemals die Testdateien selbst (<em>Test-Tampering Prevention</em>).</li>
<li class=""><strong>Deterministisches Feedback</strong>: Der Agent erhält standardisierte CLI-Exit-Codes (0 = Erfolg, ungleich 0 = Fehler mit exaktem Zeilentrace).</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-praxis-workflows-mit-claude-code--cursor">3. Praxis-Workflows mit Claude Code &amp; Cursor<a href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses#3-praxis-workflows-mit-claude-code--cursor" class="hash-link" aria-label="Direkter Link zur 3. Praxis-Workflows mit Claude Code &amp; Cursor" title="Direkter Link zur 3. Praxis-Workflows mit Claude Code &amp; Cursor" translate="no">​</a></h3>
<p>In der Stanford-Praxisübung implementierten Studierende einen Microservice mit Claude Code unter strikter SDD-Führung:</p>
<ul>
<li class=""><strong>Konfigurationsdatei <code>CLAUDE.md</code></strong>: Definiert Build-Befehle, Testbefehle und Architektur-Regeln.</li>
<li class=""><strong>Subprozess-Ausführung</strong>: Claude Code führt <code>pytest tests/test_payment.py</code> lokal im Terminal aus.</li>
<li class=""><strong>Iterative Reparatur</strong>: Bei einem Fehlschlag liest Claude Code die Fehlermeldung selbstständig aus und passt die Datei gezielt an.</li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Ende des Vibe Coding</strong>: Unstrukturierte Chat-Prompts führen unweigerlich zu Systementropie und schleichenden Regressionen.</li>
<li class=""><strong>Spec-Driven Development (SDD)</strong>: Formale Spezifikationen und Akzeptanztests bilden die unverrückbare Grundlage erfolgreicher KI-Entwicklung.</li>
<li class=""><strong>Selbstheilende Schleifen</strong>: Durch geschlossene Feedbackzyklen (Testlauf $
ightarrow$ Fehleranalyse $
ightarrow$ atomarer Patch) reparieren Agenten Code autonom.</li>
<li class=""><strong>Schutz vor Test-Manipulation</strong>: Testdateien müssen strikt vor unberechtigten Änderungen durch das LLM geschützt werden.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/stanford-cs146s-4-spec-driven-code-generation-test-harnesses#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="spec-driven-development" term="spec-driven-development"/>
        <category label="test-harness" term="test-harness"/>
        <category label="self-healing-code" term="self-healing-code"/>
        <category label="claude-code" term="claude-code"/>
        <category label="cursor" term="cursor"/>
        <category label="software-engineering" term="software-engineering"/>
        <category label="regression-testing" term="regression-testing"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #3] Model Context Protocol (MCP) & Autonome Tool-Nutzung: Die universelle Language-Server-Architektur für KI-Agenten]]></title>
        <id>https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture</id>
        <link href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture"/>
        <updated>2026-10-24T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 3: Vertiefung in das Model Context Protocol (MCP) als 'LSP für KI', Client-Server-Topologie, Stdio vs HTTP/SSE-Transports und der Aufbau sicherer Tool-Calling-Loops.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Model Context Protocol Architektur" src="https://globaldevlog.com/de/assets/images/03_cs146s_mcp_architecture-85609175a46c634ab4d63741122eb9c5.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zum dritten Teil unserer technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In Vorlesung 1 behandelten wir den Wandel zum Dirigenten autonomer Agenten, in Vorlesung 2 das defensive Verifikations-Harness. In <strong>Vorlesung 3 (Woche 2)</strong> adressiert der Lehrplan den größten architektonischen Flaschenhals moderner KI-Systeme: <strong>Wie können isolierte Basismodelle sicher, modular und standardisiert mit der Außenwelt interagieren?</strong></p>
<p>Vor 2024 erforderte die Anbindung eines LLMs an Datenbanken, Terminals oder GitHub-APIs maßgeschneiderten, fragilen Integrationscode. Aufbauend auf Anthropics offenem Standard und Stanfords Analyse verteilter Systeme analysiert diese Vorlesung das <strong>Model Context Protocol (MCP)</strong> — das universelle Bindeglied, das für KI-Agenten dieselbe revolutionäre Standardisierung leistet wie das <strong>Language Server Protocol (LSP)</strong> für moderne Code-Editoren.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-die-fragmentierungskrise-warum-wir-ein-lsp-für-ki-brauchten">1. Die Fragmentierungskrise: Warum wir ein „LSP für KI“ brauchten<a href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture#1-die-fragmentierungskrise-warum-wir-ein-lsp-f%C3%BCr-ki-brauchten" class="hash-link" aria-label="Direkter Link zur 1. Die Fragmentierungskrise: Warum wir ein „LSP für KI“ brauchten" title="Direkter Link zur 1. Die Fragmentierungskrise: Warum wir ein „LSP für KI“ brauchten" translate="no">​</a></h3>
<p>In der Anfangszeit der KI-Tools (Cursor, Claude Code, GitHub Copilot, Devin) versuchte jede Plattform auf proprietäre Weise, identische Unternehmensressourcen anzubinden: Git-Repositories, PostgreSQL-Cluster, Slack-Channels und Cloud-APIs.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Legacy_N_Times_M ["Das alte N x M Spaghetti-Problem"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1[KI-Host: Claude Code] -.-&gt;|Eigene API-Logik| R1[(PostgreSQL)]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1 -.-&gt;|Eigener Shell-Wrapper| R2[Git-Dateisystem]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A2[KI-Host: Cursor] -.-&gt;|Doppelte Integration| R1</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A2 -.-&gt;|Eigener Tool-Hook| R3[Figma API]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A3[KI-Host: Claude Desktop] -.-&gt;|Dritter Treiber| R1</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Modern_MCP_Standard ["Stanford CS146S: Der saubere MCP-Standard"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        H1[Beliebiger MCP-Host&lt;br/&gt;Claude Code / Cursor] ==&gt;|Standard JSON-RPC 2.0| C[Universeller MCP-Client]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C &lt;==&gt;|Stdio / SSE Transport| S1[PostgreSQL MCP-Server]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C &lt;==&gt;|Stdio / SSE Transport| S2[Git Worktree MCP-Server]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C &lt;==&gt;|Stdio / SSE Transport| S3[Figma REST MCP-Server]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<p>Die Parallele zum Language Server Protocol (LSP) von Microsoft ist offensichtlich: Vor LSP benötigte jede IDE für jede Sprache ein eigenes Plugin ($N 	imes M$). LSP reduzierte die Komplexität auf $N + M$. <strong>MCP tut exakt dasselbe für KI-Agenten und Entwicklungswerkzeuge.</strong></p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-3-schichten-architektur-von-mcp">2. Die 3-Schichten-Architektur von MCP<a href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture#2-die-3-schichten-architektur-von-mcp" class="hash-link" aria-label="Direkter Link zur 2. Die 3-Schichten-Architektur von MCP" title="Direkter Link zur 2. Die 3-Schichten-Architektur von MCP" translate="no">​</a></h3>
<p>Das Model Context Protocol definiert drei klare Systemrollen:</p>
<ol>
<li class=""><strong>MCP Host</strong>: Die Anwendung, die den KI-Workflow koordiniert (z. B. Claude Code, Cursor, Claude Desktop).</li>
<li class=""><strong>MCP Client</strong>: Die interne Protokollschicht im Host, die Verbindungen zu MCP-Servern aufbaut, Tool-Fähigkeiten aushandelt und JSON-RPC-Nachrichten serialisiert.</li>
<li class=""><strong>MCP Server</strong>: Ein leichtgewichtiger Prozess, der spezifische Ressourcen oder Aktionen über standardisierte Schnittstellen bereitstellt (z. B. Dateisystem-Server, Git-Server, SQL-Server).</li>
</ol>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">sequenceDiagram</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    autonumber</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant Host as MCP Host (Claude Code)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant Client as MCP Client</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant Server as PostgreSQL MCP Server</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant DB as Live Database</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Host-&gt;&gt;Client: Initialisiere Verbindung</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Client-&gt;&gt;Server: JSON-RPC: initialize (Capabilities negotiation)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Server--&gt;&gt;Client: Capabilities: {tools: ["query_sql", "describe_table"]}</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Client--&gt;&gt;Host: Bereite Tools für LLM vor</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Host-&gt;&gt;Client: Tool-Aufruf: query_sql("SELECT COUNT(*) FROM users")</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Client-&gt;&gt;Server: JSON-RPC: tools/call</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Server-&gt;&gt;DB: Führe Abfrage mit Read-Only-Rechten aus</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    DB--&gt;&gt;Server: Resultat: 42.150 Zeilen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Server--&gt;&gt;Client: JSON-RPC: tool_result</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Client--&gt;&gt;Host: Ergebnis an Kontext übergeben</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-transportmechanismen-stdio-vs-streamable-httpsse">3. Transportmechanismen: Stdio vs. Streamable HTTP/SSE<a href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture#3-transportmechanismen-stdio-vs-streamable-httpsse" class="hash-link" aria-label="Direkter Link zur 3. Transportmechanismen: Stdio vs. Streamable HTTP/SSE" title="Direkter Link zur 3. Transportmechanismen: Stdio vs. Streamable HTTP/SSE" translate="no">​</a></h3>
<p>MCP unterstützt zwei grundlegende Transportprotokolle:</p>
<table><thead><tr><th style="text-align:left">Transport</th><th style="text-align:left">Funktionsweise</th><th style="text-align:left">Typischer Einsatzbereich</th><th style="text-align:left">Sicherheitscharakteristik</th></tr></thead><tbody><tr><td style="text-align:left"><strong>Stdio (Standard Input/Output)</strong></td><td style="text-align:left">Lokaler Subprozess; Kommunikation über stdin/stdout</td><td style="text-align:left">Lokale Dateisysteme, lokale Git-Workspaces, CLI-Tools</td><td style="text-align:left">Prozess-Isolation auf OS-Ebene; kein Netzwerk-Angriffsvektor</td></tr><tr><td style="text-align:left"><strong>Streamable HTTP / SSE</strong></td><td style="text-align:left">Server-Sent Events über HTTP/HTTPS</td><td style="text-align:left">Cloud-Datenbanken, Remote-Dev-Cluster, externe SaaS-APIs</td><td style="text-align:left">Authentifizierung via OAuth2 / Bearer Token; TLS-Verschlüsselung</td></tr></tbody></table>
<p>Für lokale Entwicklungsagenten wie Claude Code ist <strong>Stdio</strong> der bevorzugte Standard: Es entstehen keine offenen Ports, keine Latenz durch Netzwerkhops und der Lebenszyklus des Servers ist direkt an den Host-Prozess gekoppelt.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="4-best-practices-für-sichere-tool-nutzung">4. Best Practices für sichere Tool-Nutzung<a href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture#4-best-practices-f%C3%BCr-sichere-tool-nutzung" class="hash-link" aria-label="Direkter Link zur 4. Best Practices für sichere Tool-Nutzung" title="Direkter Link zur 4. Best Practices für sichere Tool-Nutzung" translate="no">​</a></h3>
<ol>
<li class=""><strong>Read-Only-Prinzip als Standard</strong>: Externe Datenbank-MCP-Server sollten standardmäßig mit Lese-Rechten (<code>SELECT</code>) konfiguriert werden. Mutierende Abfragen (<code>UPDATE</code>, <code>DELETE</code>) erfordern explizite menschliche Bestätigung.</li>
<li class=""><strong>Schema-Reduktion</strong>: Übertragen Sie dem Modell nicht tausende irrelevante Tabellen, sondern nutzen Sie zielgerichtete Ressourcen-Filter (<code>resources/list</code>).</li>
<li class=""><strong>Sandboxing für Dateizugriffe</strong>: Dateisystem-Server müssen strikt auf das Projektverzeichnis begrenzt sein (Path-Traversal-Schutz gegen <code>../../etc/passwd</code>).</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>LSP für KI-Agenten</strong>: Das Model Context Protocol (MCP) löst das $N 	imes M$-Fragmentierungsproblem zwischen KI-Modellen und Entwicklerwerkzeugen durch einen offenen JSON-RPC 2.0-Standard.</li>
<li class=""><strong>3-Schichten-Topologie</strong>: Die Entkopplung von MCP Host, MCP Client und MCP Server sorgt für modulare Erweiterbarkeit und strikte Trennung von Verantwortlichkeiten.</li>
<li class=""><strong>Transportprotokolle</strong>: Stdio bietet maximale Sicherheit und Performance für lokale CLI-Tools, während HTTP/SSE Cloud-Ressourcen nahtlos integriert.</li>
<li class=""><strong>Sicherheit im Fokus</strong>: Das Least-Privilege-Prinzip (Read-Only-Default, Dateipfad-Sandboxing) schützt sensible Infrastruktur vor unkontrollierten Agenten-Aktionen.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/stanford-cs146s-3-mcp-tool-use-architecture#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="mcp" term="mcp"/>
        <category label="model-context-protocol" term="model-context-protocol"/>
        <category label="tool-use" term="tool-use"/>
        <category label="claude-code" term="claude-code"/>
        <category label="json-rpc" term="json-rpc"/>
        <category label="software-architecture" term="software-architecture"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #2] Im Inneren von Coding-LLMs & Prompt Engineering: Pre-training, RLHF und das 'Trust but Verify' Schweizer-Käse-Modell]]></title>
        <id>https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering</id>
        <link href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering"/>
        <updated>2026-10-23T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 2: Die interne Funktionsweise von Programmier-LLMs von Pre-training und RLHF bis hin zu Chain-of-Thought-Prompting und der Absicherung gegen das Schweizer-Käse-Modell bei KI-generiertem Code.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Im Inneren von Coding-LLMs &amp;amp; Prompt Engineering" src="https://globaldevlog.com/de/assets/images/02_cs146s_coding_llms_swiss_cheese-9131c0ba0d80b39529748741901e16f3.png" width="1376" height="768" class="img_ev3q"></p>
<p>Willkommen zurück zur technischen Analyse der Stanford-Vorlesungsreihe <strong>CS146S: The Modern Software Developer</strong>.</p>
<p>In Vorlesung 1 haben wir den übergeordneten Paradigmenwechsel vom Tastatur-Typisten zum System-Dirigenten etabliert. In <strong>Vorlesung 2 (Woche 1)</strong> widmet sich das Curriculum dem rechnerischen Fundament dieser Revolution: <strong>großen Sprachmodellen für Code (Coding-LLMs)</strong> und der Disziplin des <strong>Prompt Engineerings</strong>.</p>
<p>Basierend auf Pionierarbeiten von Andrej Karpathy (<em>Deep Dive into LLMs</em>), OpenAI (<em>How OpenAI Uses Codex</em>) sowie aktuellen Prompt-Engineering-Forschungen beleuchtet diese Vorlesung, wie neuronale Netze Programmierfähigkeiten erlernen, warum sie statistische Simulatoren und keine bewussten Wesen bleiben und wie Softwareingenieure das Prinzip <strong>„Trust but Verify“</strong> etablieren müssen, um das trügerische <strong>Schweizer-Käse-Modell</strong> KI-generierten Codes abzusichern.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-die-anatomie-eines-llms-die-dreistufige-trainingspipeline">1. Die Anatomie eines LLMs: Die dreistufige Trainingspipeline<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#1-die-anatomie-eines-llms-die-dreistufige-trainingspipeline" class="hash-link" aria-label="Direkter Link zur 1. Die Anatomie eines LLMs: Die dreistufige Trainingspipeline" title="Direkter Link zur 1. Die Anatomie eines LLMs: Die dreistufige Trainingspipeline" translate="no">​</a></h3>
<p>Um einen KI-Programmierassistenten effektiv zu steuern und zu debuggen, muss ein Ingenieur verstehen, wie dessen Modellgewichte entstanden sind. Wie Andrej Karpathy darlegt, sind moderne LLMs keine statischen Regelsysteme, sondern das Ergebnis einer <strong>dreistufigen Trainingspipeline</strong>:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Stage1 ["Stufe 1: Pre-training (Unüberwacht)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D1[Billionen Tokens aus Web &amp; GitHub] --&gt; N1[Transformer-Basismodell&lt;br/&gt;Next-Token-Wahrscheinlichkeit P(w_t | Context)]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Stage2 ["Stufe 2: Supervised Fine-Tuning (SFT)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        N1 --&gt; D2[Hochwertige Instruktionspaare&lt;br/&gt;Prompt &amp; Gold-Standard-Antwort]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D2 --&gt; N2[Instruktionsoptimierter Assistent&lt;br/&gt;Konversationsprotokoll]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Stage3 ["Stufe 3: RLHF &amp; Alignment"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        N2 --&gt; D3[Menschliches Präferenz-Ranking&lt;br/&gt;Reward-Modell-Scoring]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D3 --&gt; N3[Produktionsreifes Coding-LLM&lt;br/&gt;Sicher, zielgerichtet &amp; deterministisch]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="phase-1-pre-training-das-wissensfundament">Phase 1: Pre-training (Das Wissensfundament)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#phase-1-pre-training-das-wissensfundament" class="hash-link" aria-label="Direkter Link zur Phase 1: Pre-training (Das Wissensfundament)" title="Direkter Link zur Phase 1: Pre-training (Das Wissensfundament)" translate="no">​</a></h4>
<ul>
<li class=""><strong>Ziel</strong>: Nächstes Token vorhersagen (<code>P(w_t | w_&lt;t)</code>) über Billionen von Codezeilen (Python, C++, Rust, JavaScript, Dokumentationen).</li>
<li class=""><strong>Rechenaufwand</strong>: Tausende GPUs über Monate hinweg.</li>
<li class=""><strong>Ergebnis</strong>: Ein gigantischer statistischer Code-Vervollständiger. Ein Basismodell versteht jedoch noch keine dialogischen Arbeitsanweisungen.</li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="phase-2-supervised-fine-tuning-sft">Phase 2: Supervised Fine-Tuning (SFT)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#phase-2-supervised-fine-tuning-sft" class="hash-link" aria-label="Direkter Link zur Phase 2: Supervised Fine-Tuning (SFT)" title="Direkter Link zur Phase 2: Supervised Fine-Tuning (SFT)" translate="no">​</a></h4>
<ul>
<li class=""><strong>Ziel</strong>: Dem Modell beibringen, wie ein professioneller Software-Assistent zu antworten.</li>
<li class=""><strong>Daten</strong>: Hunderttausende manuell kuratierte Frage-Antwort-Paare (z. B. „Schreibe einen Thread-Pool in C++“ $
ightarrow$ sauberer, fehlerfreier Code mit Erläuterung).</li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="phase-3-reinforcement-learning-from-human-feedback-rlhf">Phase 3: Reinforcement Learning from Human Feedback (RLHF)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#phase-3-reinforcement-learning-from-human-feedback-rlhf" class="hash-link" aria-label="Direkter Link zur Phase 3: Reinforcement Learning from Human Feedback (RLHF)" title="Direkter Link zur Phase 3: Reinforcement Learning from Human Feedback (RLHF)" translate="no">​</a></h4>
<ul>
<li class=""><strong>Ziel</strong>: Das Modell belohnen, wenn es Hilfsbereitschaft, Korrektheit und Sicherheitsrichtlinien einhält.</li>
<li class=""><strong>Mechanismus</strong>: Ein separates Reward-Modell bewertet Modellantworten, woraufhin die Parameter mittels PPO (Proximal Policy Optimization) feinjustiert werden.</li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-prompt-engineering-chain-of-thought-cot--systemkontexte">2. Prompt Engineering: Chain-of-Thought (CoT) &amp; Systemkontexte<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#2-prompt-engineering-chain-of-thought-cot--systemkontexte" class="hash-link" aria-label="Direkter Link zur 2. Prompt Engineering: Chain-of-Thought (CoT) &amp; Systemkontexte" title="Direkter Link zur 2. Prompt Engineering: Chain-of-Thought (CoT) &amp; Systemkontexte" translate="no">​</a></h3>
<p>Ein häufiger Fehler bei Entwicklern ist es, LLMs wie Suchmaschinen mit einzelnen Schlagworten zu füttern. LLMs sind <strong>autoregressive Transformer</strong>: Jedes generierte Token wird sofort Teil des nächsten Kontexts. Wenn Sie das Modell zwingen, sofort Code auszugeben, fehlt ihm der Rechenraum zum logischen Nachdenken.</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="chain-of-thought-cot-prompting">Chain-of-Thought (CoT) Prompting<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#chain-of-thought-cot-prompting" class="hash-link" aria-label="Direkter Link zur Chain-of-Thought (CoT) Prompting" title="Direkter Link zur Chain-of-Thought (CoT) Prompting" translate="no">​</a></h4>
<p>Indem Sie das Modell anweisen, schrittweise vorzugehen (<em>„Think step-by-step before writing code“</em>), reservieren Sie Tokens für logische Zwischenschritte im Inferenzpfad:</p>
<div class="language-markdown codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-markdown codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token title important punctuation" style="color:#393A34">###</span><span class="token title important"> Empfohlenes CoT-Prompt-Muster</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">1.</span><span class="token plain"> </span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token bold content">Rolle &amp; Mandat</span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token plain">: Du bist ein Senior Distributed Systems Engineer.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">2.</span><span class="token plain"> </span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token bold content">Architektur-Analyse</span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token plain">: Analysiere potenzielle Race Conditions bei nebenläufigen Schreibzugriffen.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">3.</span><span class="token plain"> </span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token bold content">Schrittweiser Entwurf</span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token plain">:</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">   </span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Schritt 1: Definiere das Speichermodell und atomare Primitiven.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">   </span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Schritt 2: Formuliere das Invarianten-Protokoll.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">   </span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Schritt 3: Implementiere die C++20-Klasse mit std::atomic und std::memory_order.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">4.</span><span class="token plain"> </span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token bold content">Fehlerbehandlung</span><span class="token bold punctuation" style="color:#393A34">**</span><span class="token plain">: Führe alle Randfälle explizit auf.</span><br></div></code></pre></div></div>
<p>Durch das explizite Generieren dieser Denk-Tokens erhöht sich die Wahrscheinlichkeit, dass die finale Code-Generierung mathematisch und semantisch korrekt ist, dramatisch.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-das-schweizer-käse-modell-der-ki-code-sicherheit">3. Das Schweizer-Käse-Modell der KI-Code-Sicherheit<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#3-das-schweizer-k%C3%A4se-modell-der-ki-code-sicherheit" class="hash-link" aria-label="Direkter Link zur 3. Das Schweizer-Käse-Modell der KI-Code-Sicherheit" title="Direkter Link zur 3. Das Schweizer-Käse-Modell der KI-Code-Sicherheit" translate="no">​</a></h3>
<p>Ein Höhepunkt der Vorlesung 2 ist die Übertragung des <strong>Schweizer-Käse-Modells</strong> (bekannt aus der Luftfahrt und Medizin) auf die KI-gestützte Softwareentwicklung:</p>
<p><img decoding="async" loading="lazy" alt="Schweizer Käse Modell" src="https://globaldevlog.com/de/assets/images/02_cs146s_coding_llms_swiss_cheese-9131c0ba0d80b39529748741901e16f3.png" width="1376" height="768" class="img_ev3q"></p>
<p>Keine einzelne Verifikationsschicht kann 100 % aller KI-Fehler abfangen:</p>
<ul>
<li class="">Das <strong>LLM</strong> hat blinde Flecken (Käselöcher: Halluzinationen, subtile Off-by-One-Fehler).</li>
<li class="">Der <strong>Linter</strong> erkennt Syntax, aber keine logischen Architektur-Fehler.</li>
<li class=""><strong>Unit-Tests</strong> decken bekannte Testfälle ab, aber übersehen unbekannte Randbedingungen.</li>
<li class="">Der <strong>Code-Reviewer</strong> ermüdet bei der Inspektion von hunderten Zeilen KI-Code.</li>
</ul>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Bug[Potenzieller KI-generierter Bug] --&gt; Layer1["Schicht 1: Statische Typprüfung (TypeScript / Rust / mypy)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Layer1 --&gt;|Entwischt durch Typ-Loch| Layer2["Schicht 2: Deterministische Testsuite (Unit &amp; Integration)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Layer2 --&gt;|Entwischt durch Test-Loch| Layer3["Schicht 3: Property-Based &amp; Fuzz-Testing (Hypothesis)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Layer3 --&gt;|Entwischt durch Fuzz-Loch| Layer4["Schicht 4: Sicherheits-Taint-Analyse &amp; AST-Linters"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Layer4 --&gt;|Entwischt durch AST-Loch| Layer5["Schicht 5: Menschliches Architektur- &amp; Sicherheits-Review"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Layer5 --&gt; Blocked[Fehler sicher gestoppt vor Produktion!]</span><br></div></code></pre></div></div>
<blockquote>
<p><strong>Leitprinzip von Stanford</strong>: Ein kritischer Bug gelangt nur dann in die Produktion, wenn die Löcher aller Scheiben exakt in einer Flucht liegen. Je robuster und automatisierter die Schichten sind, desto unwahrscheinlicher wird ein Systemausfall.</p>
</blockquote>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="4-best-practices-trust-but-verify">4. Best Practices: „Trust but Verify“<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#4-best-practices-trust-but-verify" class="hash-link" aria-label="Direkter Link zur 4. Best Practices: „Trust but Verify“" title="Direkter Link zur 4. Best Practices: „Trust but Verify“" translate="no">​</a></h3>
<ol>
<li class=""><strong>Kein ungeprüfter Code in den Main-Branch</strong>: Jeder KI-generierte Code muss standardisierte CI-Pipelines durchlaufen.</li>
<li class=""><strong>Fokus auf Randfälle</strong>: Fordern Sie das LLM gezielt auf, destructive Unit-Tests gegen seinen eigenen Code zu schreiben.</li>
<li class=""><strong>Deterministische Linter vor LLM-Review</strong>: Verschwenden Sie keine teuren Reasoning-Tokens für Dinge, die ein lokaler Linter in 5 Millisekunden präziser prüfen kann.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Drei Stufen des Modelltrainings</strong>: Pre-training vermittelt rohes Sprachwissen, SFT lehrt Instruktionsbefolgung, und RLHF sorgt für Ausrichtung und Sicherheit.</li>
<li class=""><strong>Chain-of-Thought (CoT)</strong>: Schrittweises Denken ermöglicht es dem Transformer, vor der Code-Generierung Rechenkapazität für logische Zwischenschritte aufzuwenden.</li>
<li class=""><strong>Schweizer-Käse-Modell</strong>: Da KI-Code unvorhersehbare Schwachstellen aufweist, ist eine mehrstufige Verteidigungslinie (Typen $
ightarrow$ Unit-Tests $
ightarrow$ Fuzzing $
ightarrow$ Human Review) zwingend erforderlich.</li>
<li class=""><strong>„Trust but Verify“</strong>: KI-Geschwindigkeit entfaltet erst dann ihren vollen Wert, wenn deterministische Leitplanken Qualität und Robustheit garantieren.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/stanford-cs146s-2-coding-llms-prompt-engineering#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="coding-llms" term="coding-llms"/>
        <category label="prompt-engineering" term="prompt-engineering"/>
        <category label="rlhf" term="rlhf"/>
        <category label="chain-of-thought" term="chain-of-thought"/>
        <category label="swiss-cheese-model" term="swiss-cheese-model"/>
        <category label="software-architecture" term="software-architecture"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Stanford CS146S #1] Kursübersicht: Der moderne Softwareentwickler — Der Wandel vom Tastatur-Typisten zum System-Dirigenten im Zeitalter autonomer KI-Agenten]]></title>
        <id>https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer</id>
        <link href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer"/>
        <updated>2026-10-22T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Stanford CS146S Vorlesung 1: Die fundamentale Neudefinition der modernen Softwareentwicklung — vom manuellen Syntax-Tippen hin zur Orchestrierung autonomer KI-Agenten-Workflows mittels Spec-Driven Development und Loop Engineering.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Stanford CS146S Moderner Softwareentwickler" src="https://globaldevlog.com/de/assets/images/01_cs146s_human_agent_orchestration-ff1d028d7549c84680ec6bd668c01c3c.png" width="1200" height="630" class="img_ev3q"></p>
<p>Willkommen zur umfassenden technischen Analyse der Vorlesungsreihe <strong>CS146S: The Modern Software Developer der Stanford University</strong>.</p>
<p>In den vergangenen fünf Jahrzehnten bildete die Informatikausbildung Entwickler primär dazu aus, akribische Syntax-Schreiber zu sein: das Auswendiglernen von Sprachstrukturen, das manuelle Schreiben von Algorithmen und das Erstellen tausender Zeilen Boilerplate-Code. Heute erlebt die Softwareindustrie die radikalste Transformation seit der Erfindung des Compilers: den Übergang vom <strong>manuellen Programmieren</strong> zum <strong>Human-Agent Engineering</strong>.</p>
<p>In dieser grundlegenden ersten Vorlesung analysieren wir, wie führende Technologieunternehmen (Google, Meta, OpenAI) die Entwicklerproduktivität neu definieren, warum der Programmierer vom Code-Typisten zum Orchesterdirigenten wird und wie <strong>Spec-Driven Development (SDD)</strong>, <strong>Agentic Workflows</strong> und das <strong>Model Context Protocol (MCP)</strong> das unverzichtbare Toolkit für moderne Ingenieure bilden.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-der-paradigmenwechsel-vom-syntax-typisten-zum-system-dirigenten">1. Der Paradigmenwechsel: Vom Syntax-Typisten zum System-Dirigenten<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#1-der-paradigmenwechsel-vom-syntax-typisten-zum-system-dirigenten" class="hash-link" aria-label="Direkter Link zur 1. Der Paradigmenwechsel: Vom Syntax-Typisten zum System-Dirigenten" title="Direkter Link zur 1. Der Paradigmenwechsel: Vom Syntax-Typisten zum System-Dirigenten" translate="no">​</a></h3>
<p>In traditionellen Software-Entwicklungsworkflows bestand der Hauptengpass stets im menschlichen Tastaturdurchsatz und im kognitiven Abrufen von Syntaxregeln. Ein Entwickler entwirft eine Architektur, übersetzt diese in konkrete Sprach-Tokens (Java, TypeScript, Python) und verbringt 70 % seiner Arbeitszeit mit repetitiven Aufgaben: Schnittstellendefinitionen, REST-Controllern, CRUD-Tests und Syntaxfehlern.</p>
<p>Mit dem Aufkommen von Reasoning-Modellen und autonomen Programmieragenten (Claude Code, Cursor, GitHub Copilot Workspace) sind die Grenzkosten für die Erzeugung syntaktisch korrekten Codes nahezu auf null gesunken.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Traditional_Workflow ["Traditionelles Paradigma: Entwickler als Typist"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A1[Menschliche Architekturidee] --&gt;|Manuelles Tippen 70% Zeit| B1[Boilerplate-Syntax &amp; Schnittstellen]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B1 --&gt;|Manuelles Schreiben von Tests| C1[Lokale Kompilierung &amp; Debugging]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C1 --&gt;|Langsame lineare Geschwindigkeit| D1[Bereitstellung einzelner Features]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    subgraph Modern_Agentic_Workflow ["Stanford CS146S Paradigma: Entwickler als Dirigent"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        A2[Menschlicher Architekt: Spezifikation &amp; Invarianten] ==&gt;|Präzise SPEC.md| B2[Autonomes KI-Agenten-Team]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        B2 --&gt;|Multi-File-Bearbeitung via MCP| C2[Automatisiertes Loop Engineering: Test &amp; Self-Heal]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C2 --&gt;|Kontinuierliches Feedback| B2</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        C2 ==&gt;|Verifizierter Codebestand| D2[Menschliches Architektur- &amp; Security-Review]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        D2 ==&gt;|10-fache Skalierungsgeschwindigkeit| E2[Produktions-Deployment]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div></code></pre></div></div>
<p>Moderne Entwickler werden nicht mehr daran gemessen, wie viele Zeilen Code (Lines of Code, LOC) sie pro Tag schreiben. Sie agieren vielmehr als <strong>Engineering Manager, die ein Team autonomer KI-Agenten leiten</strong>. Wenn ein technischer Leiter Aufgaben an Nachwuchsentwickler delegiert, diktiert er nicht jeden Tastenanschlag, sondern formuliert unmissverständliche Spezifikationen, definiert Systemgrenzen und legt deterministische Abnahmekriterien fest.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-spec-driven-development-sdd-was-vor-wie">2. Spec-Driven Development (SDD): „Was“ vor „Wie“<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#2-spec-driven-development-sdd-was-vor-wie" class="hash-link" aria-label="Direkter Link zur 2. Spec-Driven Development (SDD): „Was“ vor „Wie“" title="Direkter Link zur 2. Spec-Driven Development (SDD): „Was“ vor „Wie“" translate="no">​</a></h3>
<p>Die von Stanford CS146S propagierte Kernmethodik ist das <strong>Spec-Driven Development (SDD)</strong>. Bei naiver KI-Unterstützung interagieren Entwickler oft über vage Chat-Prompts wie: <em>„Kannst du ein Benutzer-Login-System erstellen?“</em></p>
<p>Dieser Ansatz führt unweigerlich zu architektonischen Abweichungen, Code-Halluzinationen und fehlender Randfall-Behandlung. Im SDD ist das primäre Arbeitsergebnis nicht der rohe Quellcode, sondern ein formales, maschinell verarbeitbares <strong>Spezifikationsdokument (<code>SPEC.md</code>)</strong>.</p>
<div class="language-markdown codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-markdown codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token title important punctuation" style="color:#393A34">#</span><span class="token title important"> Engineering-Spezifikationsvorlage (SPEC.md)</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token title important punctuation" style="color:#393A34">##</span><span class="token title important"> 1. Kontext &amp; Geschäftsdomäne</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Implementierung idempotenter Zahlungs-Webhook-Verarbeitung für Stripe API v2024-06.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Datenbank: PostgreSQL 16 mit aktivierter Row-Level Security (RLS).</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token title important punctuation" style="color:#393A34">##</span><span class="token title important"> 2. Invarianten &amp; Nicht verhandelbare Vorgaben</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Alle Datenbankmutationen MÜSSEN innerhalb einer expliziten Transaktion stattfinden.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Die Webhook-Signaturvalidierung (HMAC-SHA256) MUSS vor jedem Payload-Parsing fehlschlagen (Fail-Closed).</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Latenzgrenzwert: P99-Antwortzeit &lt; 80 ms.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token title important punctuation" style="color:#393A34">##</span><span class="token title important"> 3. Schnittstellen &amp; Schemata</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Input: </span><span class="token code-snippet code keyword" style="color:#00009f">`POST /api/v1/payments/webhook`</span><span class="token plain"> mit unverändertem Request-Body-Buffer.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Behandelte Ereignistypen: </span><span class="token code-snippet code keyword" style="color:#00009f">`payment_intent.succeeded`</span><span class="token plain">, </span><span class="token code-snippet code keyword" style="color:#00009f">`payment_intent.payment_failed`</span><span class="token plain">.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token title important punctuation" style="color:#393A34">##</span><span class="token title important"> 4. Verifizierungs- &amp; Testanforderungen</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Unit-Test-Abdeckung &gt; 95 % für Transaktions-Rollbacks bei doppelten Event-IDs.</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token list punctuation" style="color:#393A34">-</span><span class="token plain"> Nebenläufigkeitstest: 50 zeitgleiche Duplikat-Webhooks dürfen exakt 1 Datenbankeintrag erzeugen.</span><br></div></code></pre></div></div>
<p>Indem Entwickler tiefen kognitiven Aufwand in die Spezifikation investieren, etablieren sie unzerbrechliche Schutzplanken. Der KI-Agent erhält vollständige Autonomie über das <em>„Wie“</em> (Synthese der Implementierung), während der Mensch die absolute Kontrolle über das <em>„Was“</em> und das <em>„Warum“</em> behält.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-agentic-workflows--automatisiertes-loop-engineering">3. Agentic Workflows &amp; Automatisiertes Loop Engineering<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#3-agentic-workflows--automatisiertes-loop-engineering" class="hash-link" aria-label="Direkter Link zur 3. Agentic Workflows &amp; Automatisiertes Loop Engineering" title="Direkter Link zur 3. Agentic Workflows &amp; Automatisiertes Loop Engineering" translate="no">​</a></h3>
<p>Ein zentrales Konzept der Vorlesung 1 ist das <strong>Loop Engineering</strong>. Foundation Models sind probabilistische Systeme; von einem LLM zu erwarten, dass es ein komplexes verteiltes System in einem einzigen Durchlauf fehlerfrei generiert, ist mathematisch unrealistisch.</p>
<p>Stattdessen strukturiert die moderne Softwareentwicklung den Agenten-Workflow in eine geschlossene, sich selbst korrigierende autonome Schleife:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">stateDiagram-v2</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    [*] --&gt; Spec_Ingestion: Entwickler übergibt SPEC.md</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Spec_Ingestion --&gt; Workspace_Planning: Agent analysiert Codebase-Graph</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    state Workspace_Planning {</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        [*] --&gt; IdentifyDependencies</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IdentifyDependencies --&gt; FormulatePatchPlan</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    }</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Workspace_Planning --&gt; Multi_File_Edit: Quellcode-Modifikationen ausführen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Multi_File_Edit --&gt; Automated_Verification: CI/CD &amp; Unit-Tests starten</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    state Automated_Verification {</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        [*] --&gt; RunTests</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        RunTests --&gt; InspectExitCode</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    }</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Automated_Verification --&gt; Self_Correction: Testfehler oder Linter-Warnung</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Self_Correction --&gt; Multi_File_Edit: Stacktrace in Agenten-Kontext einspeisen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Automated_Verification --&gt; Human_Review: Alle Tests bestanden (Exit Code 0)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Human_Review --&gt; Merge_Production: Architektur- &amp; Sicherheitsfreigabe</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Merge_Production --&gt; [*]</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="die-vier-phasen-der-autonomen-schleife">Die vier Phasen der autonomen Schleife:<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#die-vier-phasen-der-autonomen-schleife" class="hash-link" aria-label="Direkter Link zur Die vier Phasen der autonomen Schleife:" title="Direkter Link zur Die vier Phasen der autonomen Schleife:" translate="no">​</a></h4>
<ol>
<li class=""><strong>Planung (Workspace Discovery)</strong>: Der Agent durchläuft den Projektdateigraphen und analysiert Schnittstellenverträge.</li>
<li class=""><strong>Ausführung (Multi-File Transformation)</strong>: Der Agent wendet atomare Diffs synchron über Client-, Server- und Migrationsdateien an.</li>
<li class=""><strong>Verifizierung (Deterministisches Feedback)</strong>: Der Agent führt autonom Testrunner (<code>pytest</code>, <code>vitest</code>, <code>cargo test</code>) und Linter aus.</li>
<li class=""><strong>Selbstkorrektur (Loop Iteration)</strong>: Schlägt eine Assertion fehl, analysiert der Agent den Fehler-Trace und passt den Code iterativ an, bis alle Tests bestehen.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="4-model-context-protocol-mcp-das-universelle-protokoll-für-agenten">4. Model Context Protocol (MCP): Das universelle Protokoll für Agenten<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#4-model-context-protocol-mcp-das-universelle-protokoll-f%C3%BCr-agenten" class="hash-link" aria-label="Direkter Link zur 4. Model Context Protocol (MCP): Das universelle Protokoll für Agenten" title="Direkter Link zur 4. Model Context Protocol (MCP): Das universelle Protokoll für Agenten" translate="no">​</a></h3>
<p>Wie verlässt ein KI-Modell die isolierte Sandbox und interagiert mit realen Entwicklerwerkzeugen? Die Antwort ist das <strong>Model Context Protocol (MCP)</strong>, der offene Industriestandard für Tool-Integration.</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">sequenceDiagram</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    autonumber</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    actor Dev as Entwickler (Dirigent)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant IDE as KI-Native IDE / Agent Host</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant MCP as MCP Server Gateway</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant FS as Lokales Dateisystem &amp; Git</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant DB as Entwicklungsdatenbank</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    participant CI as Testrunner / Linter</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain" style="display:inline-block"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Dev-&gt;&gt;IDE: Spezifikation ausführen ("Auth auf JWT migrieren")</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    IDE-&gt;&gt;MCP: Verfügbare Tools abfragen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    MCP--&gt;&gt;IDE: Tools: [read_file, write_patch, run_tests, query_db]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    loop Loop Engineering Iteration</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IDE-&gt;&gt;MCP: Tool aufrufen: "read_file(/src/auth.py)"</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP-&gt;&gt;FS: Dateipuffer abrufen</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        FS--&gt;&gt;MCP: Roher Dateistream</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP--&gt;&gt;IDE: Dateiinhalt im Kontextfenster</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IDE-&gt;&gt;MCP: Tool aufrufen: "write_patch(/src/auth.py, diff)"</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP-&gt;&gt;FS: Atomares Diff anwenden</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IDE-&gt;&gt;MCP: Tool aufrufen: "run_tests('tests/test_auth.py')"</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP-&gt;&gt;CI: Subprozess pytest starten</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        CI--&gt;&gt;MCP: Testergebnis: 1 fehlgeschlagen (Secret Key fehlt)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP--&gt;&gt;IDE: Fehlerprotokoll übermitteln</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IDE-&gt;&gt;IDE: Ursache analysieren: Secret Key fehlt in config.py</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IDE-&gt;&gt;MCP: Tool aufrufen: "write_patch(/src/config.py)"</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP-&gt;&gt;FS: Patch anwenden</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        IDE-&gt;&gt;MCP: Tool aufrufen: "run_tests('tests/test_auth.py')"</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        MCP-&gt;&gt;CI: Subprozess pytest starten</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">        CI--&gt;&gt;MCP: Testergebnis: 100% bestanden (Exit Code 0)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    end</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    IDE--&gt;&gt;Dev: Bereit zur Überprüfung: Sauberer Git-Diff &amp; Tests grün</span><br></div></code></pre></div></div>
<p>Dank MCP können Agenten PostgreSQL-Schemata abfragen, Runtime-Logs analysieren, Browser-Tests ausführen und Git-Operationen durchführen, ohne dass menschliches Copy-Paste erforderlich ist.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="5-architektonischer-vergleich-typist-vs-dirigent">5. Architektonischer Vergleich: Typist vs. Dirigent<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#5-architektonischer-vergleich-typist-vs-dirigent" class="hash-link" aria-label="Direkter Link zur 5. Architektonischer Vergleich: Typist vs. Dirigent" title="Direkter Link zur 5. Architektonischer Vergleich: Typist vs. Dirigent" translate="no">​</a></h3>
<table><thead><tr><th style="text-align:left">Dimension</th><th style="text-align:left">Traditionelles Paradigma (Code-Typist)</th><th style="text-align:left">Stanford CS146S Paradigma (KI-Dirigent)</th></tr></thead><tbody><tr><td style="text-align:left"><strong>Primäre Fähigkeit</strong></td><td style="text-align:left">Syntaxkenntnis, Tippgeschwindigkeit, Regex-Routinen</td><td style="text-align:left">Systemarchitektur, Spezifikationsdesign, Bedrohungsmodellierung</td></tr><tr><td style="text-align:left"><strong>Entwicklungseinheit</strong></td><td style="text-align:left">Funktionen, einzelne Codezeilen, isolierte Dateien</td><td style="text-align:left">Gesamtsystem-Spezifikationen, Invarianten, Testverträge</td></tr><tr><td style="text-align:left"><strong>Werkzeuge</strong></td><td style="text-align:left">Passive Texteditoren, manuelle Debugger</td><td style="text-align:left">Autonome Agenten (Claude Code, Cursor), MCP-Server, CI/CD-Loops</td></tr><tr><td style="text-align:left"><strong>Hauptengpass</strong></td><td style="text-align:left">Tipptempo, kognitive Ermüdung, manuelle Boilerplates</td><td style="text-align:left">Vage Spezifikationen, unvollständige Testabdeckung</td></tr><tr><td style="text-align:left"><strong>Verifizierungsstrategie</strong></td><td style="text-align:left">Manuelles Durchsteppen im Debugger, console.log</td><td style="text-align:left">Automatisierte deterministische Testsuiten, Invarianten-Fuzzing</td></tr><tr><td style="text-align:left"><strong>Fehlermuster</strong></td><td style="text-align:left">Syntaxfehler, fehlende Semikolons, Off-by-One-Fehler</td><td style="text-align:left">Semantische Halluzination, subtile Sicherheitslücken</td></tr></tbody></table>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="6-vertiefung-warum-grundlagen-heute-wichtiger-sind-denn-je">6. Vertiefung: Warum Grundlagen heute wichtiger sind denn je<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#6-vertiefung-warum-grundlagen-heute-wichtiger-sind-denn-je" class="hash-link" aria-label="Direkter Link zur 6. Vertiefung: Warum Grundlagen heute wichtiger sind denn je" title="Direkter Link zur 6. Vertiefung: Warum Grundlagen heute wichtiger sind denn je" translate="no">​</a></h3>
<p>In der Stanford-Vorlesung stellten Studierende eine entscheidende Frage:</p>
<blockquote>
<p><strong>F: Wenn KI-Agenten 80 % unseres Codes in Sekunden schreiben können, müssen wir dann überhaupt noch Algorithmen, Speichermanagement und Datenstrukturen lernen?</strong></p>
</blockquote>
<p>Die Antwort der Dozenten ist eindeutig: <strong>Informatik-Grundlagen sind heute unverzichtbarer als vor zehn Jahren.</strong></p>
<ol>
<li class=""><strong>Die Bürde des Reviewers</strong>: 1.000 Zeilen plausiblen Code generiert die KI in 15 Sekunden. Um darin eine $O(N^2)$-Laufzeitfalle, ein ungeschlossenes Datenbank-Connection-Pool-Leak oder eine Race Condition zu entdecken, ist <strong>tiefes Systemverständnis</strong> erforderlich.</li>
<li class=""><strong>Die Verantwortung bleibt 100 % menschlich</strong>: Ein KI-Agent haftet weder rechtlich noch professionell für Produktionsausfälle. Die Verantwortung trägt die Person, die den Pull Request freigibt.</li>
<li class=""><strong>Debuggen von Randfällen</strong>: Verfängt sich ein autonomer Agent in einer Endlosschleife, kann nur ein Ingenieur mit fundierten Betriebssystem-, Netzwerk- und Hardwarekenntnissen die Ursache beheben.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="7-fazit--serien-roadmap">7. Fazit &amp; Serien-Roadmap<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#7-fazit--serien-roadmap" class="hash-link" aria-label="Direkter Link zur 7. Fazit &amp; Serien-Roadmap" title="Direkter Link zur 7. Fazit &amp; Serien-Roadmap" translate="no">​</a></h3>
<ol>
<li class=""><strong>Identität neu definieren</strong>: Begreifen Sie sich als Architekt, Spezifikationsdesigner und Agenten-Manager.</li>
<li class=""><strong>Spec-Driven Development beherrschen</strong>: <code>SPEC.md</code> ist Ihr wirkungsvollstes Artefakt.</li>
<li class=""><strong>Loop Engineering etablieren</strong>: Bauen Sie geschlossene Feedbackschleifen mit deterministischen Tests.</li>
</ol>
<p>In <strong>Vorlesung 2</strong> behandeln wir <strong>Context Management &amp; Prompt-Architektur</strong>: Wie Kontextfenster optimal strukturiert, Repository-Maps genutzt und Kontextüberlastungen vermieden werden.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Paradigmenwechsel</strong>: Softwareentwickler wandeln sich von manuellen Tastatur-Tippern zu Dirigenten autonomer KI-Agententeams.</li>
<li class=""><strong>Spec-Driven Development (SDD)</strong>: Hochwertiges Engineering konzentriert sich auf maschinell lesbare Invarianten in <code>SPEC.md</code>-Dateien.</li>
<li class=""><strong>Loop Engineering &amp; MCP</strong>: Effektive KI-Entwicklung basiert auf iterativen, selbstheilenden Testschleifen und dem Model Context Protocol (MCP).</li>
<li class=""><strong>Bürde des Reviewers</strong>: Bei Grenzkosten von null für die Codegenerierung sind fundamentale Informatikkenntnisse (Nebenläufigkeit, Datenstrukturen, Betriebssysteme) essenziell für die Sicherheitsüberprüfung.</li>
</ol>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="referenzen--kursmaterialien">Referenzen &amp; Kursmaterialien<a href="https://globaldevlog.com/de/blog/stanford-cs146s-1-modern-software-developer#referenzen--kursmaterialien" class="hash-link" aria-label="Direkter Link zur Referenzen &amp; Kursmaterialien" title="Direkter Link zur Referenzen &amp; Kursmaterialien" translate="no">​</a></h3>
<ul>
<li class=""><strong>Offizielle Vorlesungs-Playlist</strong>: <a href="https://www.youtube.com/playlist?list=PLxpwjSdVZQ95OWe3QvkVEcU1f1X-6NDj9" target="_blank" rel="noopener noreferrer" class="">Stanford CS146S: The Modern Software Development (YouTube Playlist)</a></li>
<li class=""><strong>Institution</strong>: Stanford University, Department of Computer Science</li>
</ul>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="stanford-cs146s" term="stanford-cs146s"/>
        <category label="agentic-workflows" term="agentic-workflows"/>
        <category label="spec-driven-development" term="spec-driven-development"/>
        <category label="human-agent-engineering" term="human-agent-engineering"/>
        <category label="mcp" term="mcp"/>
        <category label="software-architecture" term="software-architecture"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[Eigene Domain auf GitHub Pages #1: Zero-Downtime-Migration mit Porkbun und Cloudflare DNS (CNAME Flattening & Universal SSL)]]></title>
        <id>https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns</id>
        <link href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns"/>
        <updated>2026-10-21T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Schritt-für-Schritt-Anleitung: Wechsel von kostenlosen github.io-Subdomains zu einer Apex-Domain via Porkbun und Cloudflare Anycast DNS ohne HTTPS-Ausfall.]]></summary>
        <content type="html"><![CDATA[<p>Ein Entwickler-Blog auf GitHub Pages unter <code>username.github.io/project</code> ist kostengünstig und unkompliziert: Markdown committen, Git-Push ausführen und GitHub liefert die Seite global aus.</p>
<p>Sobald Sie jedoch professionelles Branding und Monetarisierung planen, stehen Sie vor einem Hindernis: <strong>Google AdSense verbietet kostenlose Sekundär-Subdomains wie <code>*.github.io</code> vollständig</strong>. Zudem bleibt die erarbeitete Domain Authority an GitHub gebunden anstatt Ihrer eigenen Marke zugutezukommen.</p>
<p>In diesem ersten Teil unserer Infrastrukturserie zeigen wir die exakte Zero-Downtime-Migration von <code>jbjihwan.github.io/global_blog</code> zu <code>https://globaldevlog.com</code> über eine hochverfügbare <strong>Porkbun + Cloudflare + GitHub Pages 3-Stufen-Architektur</strong>.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-schritt-für-schritt-konfiguration">1. Schritt-für-Schritt-Konfiguration<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns#1-schritt-f%C3%BCr-schritt-konfiguration" class="hash-link" aria-label="Direkter Link zur 1. Schritt-für-Schritt-Konfiguration" title="Direkter Link zur 1. Schritt-für-Schritt-Konfiguration" translate="no">​</a></h3>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="schritt-1-nameserver-delegierung-bei-porkbun">Schritt 1: Nameserver-Delegierung bei Porkbun<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns#schritt-1-nameserver-delegierung-bei-porkbun" class="hash-link" aria-label="Direkter Link zur Schritt 1: Nameserver-Delegierung bei Porkbun" title="Direkter Link zur Schritt 1: Nameserver-Delegierung bei Porkbun" translate="no">​</a></h4>
<p>Ersetzen Sie bei Porkbun die Standard-Nameserver durch die zugewiesenen Cloudflare Anycast-Nameserver:</p>
<ul>
<li class=""><code>curt.ns.cloudflare.com</code></li>
<li class=""><code> रोजी.ns.cloudflare.com</code></li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="schritt-2-dns-einträge-bei-cloudflare-cname-flattening">Schritt 2: DNS-Einträge bei Cloudflare (CNAME Flattening)<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns#schritt-2-dns-eintr%C3%A4ge-bei-cloudflare-cname-flattening" class="hash-link" aria-label="Direkter Link zur Schritt 2: DNS-Einträge bei Cloudflare (CNAME Flattening)" title="Direkter Link zur Schritt 2: DNS-Einträge bei Cloudflare (CNAME Flattening)" translate="no">​</a></h4>
<p>Tragen Sie zwei DNS-Records ein:</p>
<ul>
<li class=""><strong>Typ</strong>: <code>CNAME</code> | <strong>Name</strong>: <code>@</code> (Apex) | <strong>Ziel</strong>: <code>jbjihwan.github.io</code> | <strong>Proxy</strong>: Aktiviert (Orange Cloud)</li>
<li class=""><strong>Typ</strong>: <code>CNAME</code> | <strong>Name</strong>: <code>www</code> | <strong>Ziel</strong>: <code>jbjihwan.github.io</code> | <strong>Proxy</strong>: Aktiviert</li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="schritt-3-docusaurus-cname-reset-bug-verhindern">Schritt 3: Docusaurus CNAME-Reset-Bug verhindern<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns#schritt-3-docusaurus-cname-reset-bug-verhindern" class="hash-link" aria-label="Direkter Link zur Schritt 3: Docusaurus CNAME-Reset-Bug verhindern" title="Direkter Link zur Schritt 3: Docusaurus CNAME-Reset-Bug verhindern" translate="no">​</a></h4>
<p>GitHub Pages benötigt eine Datei namens <code>CNAME</code> im Root des Deployment-Branches. Wenn Sie <code>npm run deploy</code> ausführen, überschreibt Docusaurus den Branch. Legen Sie daher die CNAME-Datei in das Verzeichnis <code>static/CNAME</code>:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">globaldevlog.com</span><br></div></code></pre></div></div>
<p>Dadurch kopiert Docusaurus die Domain-Datei bei jedem Build automatisch in das Root-Verzeichnis.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-ssltls-verschlüsselung-der-full-strict-modus">2. SSL/TLS-Verschlüsselung: Der Full (Strict) Modus<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns#2-ssltls-verschl%C3%BCsselung-der-full-strict-modus" class="hash-link" aria-label="Direkter Link zur 2. SSL/TLS-Verschlüsselung: Der Full (Strict) Modus" title="Direkter Link zur 2. SSL/TLS-Verschlüsselung: Der Full (Strict) Modus" translate="no">​</a></h3>
<p>In den Cloudflare SSL/TLS-Einstellungen muss der Modus <strong>Full</strong> oder <strong>Full (Strict)</strong> gewählt werden. Da GitHub Pages automatisch Let's Encrypt-Zertifikate für Custom Domains ausstellt, ist die Verbindung zwischen Cloudflare Edge und GitHub Pages durchgängig verschlüsselt.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-cloudflare-dns#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Strikte Trennung</strong>: Porkbun übernimmt die Domain-Verwaltung, Cloudflare sichert DNS und Edge-Routing, GitHub Pages hostet die statischen Dateien.</li>
<li class=""><strong>CNAME Flattening</strong>: Ermöglicht das direkte Routing der Apex-Domain ohne starre IP-Adressen.</li>
<li class=""><strong>Docusaurus CNAME-Sicherung</strong>: Platzieren Sie die <code>CNAME</code>-Datei im <code>static/</code>-Ordner, um versehentliches Überschreiben bei Re-Deployments zu verhindern.</li>
<li class=""><strong>Durchgängige Verschlüsselung</strong>: Nutzen Sie Cloudflare SSL Full für nahtlose HTTPS-Sicherheit.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="github-pages" term="github-pages"/>
        <category label="custom-domain" term="custom-domain"/>
        <category label="porkbun" term="porkbun"/>
        <category label="cloudflare" term="cloudflare"/>
        <category label="docusaurus" term="docusaurus"/>
        <category label="devops" term="devops"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Web-Monetarisierung #2] Google AdSense-Zulassung für statische Websites: Lösung der ads.txt 404-Crawler-Falle & HeadTags-Integration]]></title>
        <id>https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide</id>
        <link href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide"/>
        <updated>2026-10-21T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Vollständiger Entwickler-Leitfaden: Google AdSense-Verifizierung auf Docusaurus einrichten, statische ads.txt im Root bereitstellen und Cloudflare WAF-Crawler-Blockaden verhindern.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Google AdSense Genehmigung und Crawler-Pipeline" src="https://globaldevlog.com/de/assets/images/01_ads_txt_crawler_flow-07ac14e74d8de1ebbae14b24c34264d1.png" width="932" height="929" class="img_ev3q"></p>
<blockquote>
<p>📌 <strong>Kernaussagen (TL;DR)</strong></p>
<ul>
<li class=""><strong>Das Problem</strong>: Im Gegensatz zu dynamischen CMS (WordPress) lösen statische Websites (Docusaurus, Hugo) auf GitHub Pages häufig die Warnung <strong>„Erträge gefährdet: ads.txt fehlt“</strong> aus, weil Crawler durch Hydration-Verzögerungen oder WAF-Regeln blockiert werden.</li>
<li class=""><strong>Die Lösung</strong>: Verifizierungs-Tag direkt über <code>headTags</code> in <code>docusaurus.config.ts</code> einfügen, <code>ads.txt</code> in <code>static/ads.txt</code> platzieren und Cloudflare WAF-Bypass-Regeln für den <code>Googlebot-AdsTxt</code>-Crawler definieren.</li>
<li class=""><strong>Das Ergebnis</strong>: 100 % automatisierte Crawler-Erreichbarkeit, keine 404-Fehler und erfolgreiche AdSense-Freischaltung bei anhaltenden Lighthouse-Scores über 95.</li>
</ul>
</blockquote>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-das-problem-warum-statische-seiten-bei-adstxt-scheitern">1. Das Problem: Warum statische Seiten bei ads.txt scheitern<a href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide#1-das-problem-warum-statische-seiten-bei-adstxt-scheitern" class="hash-link" aria-label="Direkter Link zur 1. Das Problem: Warum statische Seiten bei ads.txt scheitern" title="Direkter Link zur 1. Das Problem: Warum statische Seiten bei ads.txt scheitern" translate="no">​</a></h3>
<p>Google AdSense verlangt zwei fundamentale technische Voraussetzungen:</p>
<ol>
<li class=""><strong>Publisher-Tag im <code>&lt;head&gt;</code></strong>: <code>&lt;script async src="https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-..." crossorigin="anonymous"&gt;&lt;/script&gt;</code></li>
<li class=""><strong>Validierte <code>ads.txt</code> unter der Root-Domain</strong>: <code>https://example.com/ads.txt</code></li>
</ol>
<p>Bei Single Page Applications (SPAs) und SSGs schlägt die Validierung oft fehl, wenn JavaScript erst clientseitig gerendert wird oder Cloudflare Managed Challenge Bot-Filter den AdSense-Crawler versehentlich blockieren.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-lösungsschritte">2. Die Lösungsschritte<a href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide#2-die-l%C3%B6sungsschritte" class="hash-link" aria-label="Direkter Link zur 2. Die Lösungsschritte" title="Direkter Link zur 2. Die Lösungsschritte" translate="no">​</a></h3>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="schritt-1-saubere-headtags-injektion-in-docusaurus">Schritt 1: Saubere HeadTags-Injektion in Docusaurus<a href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide#schritt-1-saubere-headtags-injektion-in-docusaurus" class="hash-link" aria-label="Direkter Link zur Schritt 1: Saubere HeadTags-Injektion in Docusaurus" title="Direkter Link zur Schritt 1: Saubere HeadTags-Injektion in Docusaurus" translate="no">​</a></h4>
<p>Fügen Sie das Skript in <code>docusaurus.config.ts</code> ein:</p>
<div class="language-ts codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-ts codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">headTags</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token punctuation" style="color:#393A34">[</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  </span><span class="token punctuation" style="color:#393A34">{</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    tagName</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token string" style="color:#e3116c">'script'</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    attributes</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token punctuation" style="color:#393A34">{</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">      async</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token string" style="color:#e3116c">'true'</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">      src</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token string" style="color:#e3116c">'https://pagead2.googlesyndication.com/pagead/js/adsbygoogle.js?client=ca-pub-4654073335496617'</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">      crossorigin</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token string" style="color:#e3116c">'anonymous'</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    </span><span class="token punctuation" style="color:#393A34">}</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  </span><span class="token punctuation" style="color:#393A34">}</span><span class="token punctuation" style="color:#393A34">,</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token punctuation" style="color:#393A34">]</span><span class="token punctuation" style="color:#393A34">,</span><br></div></code></pre></div></div>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="schritt-2-platzierung-von-adstxt">Schritt 2: Platzierung von <code>ads.txt</code><a href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide#schritt-2-platzierung-von-adstxt" class="hash-link" aria-label="Direkter Link zur schritt-2-platzierung-von-adstxt" title="Direkter Link zur schritt-2-platzierung-von-adstxt" translate="no">​</a></h4>
<p>Erstellen Sie die Datei <code>static/ads.txt</code>:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">google.com, pub-4654073335496617, DIRECT, f08c47fec0942fa0</span><br></div></code></pre></div></div>
<p>Docusaurus kopiert Dateien aus <code>static/</code> direkt in das Root-Verzeichnis des Build-Outputs (<code>build/ads.txt</code>).</p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="schritt-3-cloudflare-waf-regel-für-googlebot-adstxt">Schritt 3: Cloudflare WAF-Regel für Googlebot-AdsTxt<a href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide#schritt-3-cloudflare-waf-regel-f%C3%BCr-googlebot-adstxt" class="hash-link" aria-label="Direkter Link zur Schritt 3: Cloudflare WAF-Regel für Googlebot-AdsTxt" title="Direkter Link zur Schritt 3: Cloudflare WAF-Regel für Googlebot-AdsTxt" translate="no">​</a></h4>
<p>Erstellen Sie eine WAF-Ausnahmeregel, damit Crawler nicht durch Bot-Protection-Challenges geblockt werden:</p>
<ul>
<li class=""><strong>Feld</strong>: <code>User Agent</code></li>
<li class=""><strong>Operator</strong>: <code>contains</code></li>
<li class=""><strong>Wert</strong>: <code>Googlebot</code></li>
<li class=""><strong>Aktion</strong>: <code>Bypass / Skip</code></li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/static-site-adsense-ads-txt-guide#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Automatisierte Bereitstellung</strong>: Die Platzierung der <code>ads.txt</code> im <code>static/</code>-Verzeichnis garantiert die Verfügbarkeit unter <code>domain.com/ads.txt</code>.</li>
<li class=""><strong>HeadTags statt React-Hooks</strong>: Die Injektion über <code>docusaurus.config.ts headTags</code> stellt sicher, dass der AdSense-Code bereits im initialen statischen HTML enthalten ist.</li>
<li class=""><strong>Cloudflare WAF konfigurieren</strong>: Der <code>Googlebot-AdsTxt</code>-Crawler muss explizit von Bot-Challenges ausgenommen werden.</li>
<li class=""><strong>Verifizierung nach 24 Stunden</strong>: Sobald die DNS- und WAF-Pfade frei sind, schließt Google die Publisher-Prüfung erfolgreich ab.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="google-adsense" term="google-adsense"/>
        <category label="docusaurus" term="docusaurus"/>
        <category label="github-pages" term="github-pages"/>
        <category label="web-monetization" term="web-monetization"/>
        <category label="devops" term="devops"/>
        <category label="cloudflare" term="cloudflare"/>
        <category label="seo" term="seo"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[Von GitHub Pages zur eigenen Domain: Vollständiger Leitfaden für Porkbun, Cloudflare DNS, AdSense-Zulassung und Multi-Engine-SEO]]></title>
        <id>https://globaldevlog.com/de/blog/github-pages-custom-domain-adsense-seo-guide</id>
        <link href="https://globaldevlog.com/de/blog/github-pages-custom-domain-adsense-seo-guide"/>
        <updated>2026-10-20T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Produktions-Leitfaden für die Migration eines statischen Docusaurus-Blogs auf GitHub Pages zu einer Apex-Custom-Domain mit Porkbun und Cloudflare DNS, Google AdSense-Verifizierung und Multi-Suchmaschinen-SEO.]]></summary>
        <content type="html"><![CDATA[<p>Ein Entwickler-Blog auf GitHub Pages unter <code>username.github.io/project</code> ist eine der schnellsten Möglichkeiten, technische Artikel zu veröffentlichen. Sobald Ihre Leserschaft jedoch wächst und Sie eine professionelle Monetarisierung anstreben, stoßen Sie auf eine harte Grenze: <strong>Google AdSense verbietet kostenlose Subdomains wie <code>*.github.io</code> strikt</strong>. Für die AdSense-Verifizierung und nachhaltigen organischen Traffic benötigen Sie eine eigene Apex-Domain.</p>
<p>Die Migration einer statischen Dokumentationsseite auf eine eigene Domain erfordert weit mehr als einen einfachen DNS-Eintrag: Nameserver-Delegierung, Edge-SSL-Zertifikate, kanonische Weiterleitungen, automatisches <code>ads.txt</code>-Hosting und die korrekte Indexierung in Google, Naver und Bing.</p>
<p>In diesem Leitfaden beschreiben wir unsere Zero-Downtime-Migration von <code>jbjihwan.github.io/global_blog</code> zu <code>https://globaldevlog.com</code>.</p>
<!-- -->
<hr>
<p><img decoding="async" loading="lazy" alt="Produktions-DNS &amp;amp; CDN-Routing-Architektur" src="https://globaldevlog.com/de/assets/images/01_dns_routing_architecture-f8067d0449825ce99152be95865aa0a4.png" width="967" height="970" class="img_ev3q"></p>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-architektur-übersicht-das-3-schichten-modell">1. Architektur-Übersicht: Das 3-Schichten-Modell<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-adsense-seo-guide#1-architektur-%C3%BCbersicht-das-3-schichten-modell" class="hash-link" aria-label="Direkter Link zur 1. Architektur-Übersicht: Das 3-Schichten-Modell" title="Direkter Link zur 1. Architektur-Übersicht: Das 3-Schichten-Modell" translate="no">​</a></h3>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart LR</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    User[Besucher weltweit] --&gt; Edge[Cloudflare Anycast CDN &amp; DNS]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Edge --&gt;|Universal SSL Termination| Edge</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Edge --&gt;|CNAME Flattening| Origin[GitHub Pages Static Storage]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Origin --&gt; Static[Vorab kompilierte HTML/CSS/JS Assets]</span><br></div></code></pre></div></div>
<ol>
<li class=""><strong>Domain-Registrar (Porkbun)</strong>: Verwaltet die Domain-Registrierung und delegiert Nameserver vollständig an Cloudflare.</li>
<li class=""><strong>DNS &amp; Edge-Sicherheit (Cloudflare Anycast DNS)</strong>:<!-- -->
<ul>
<li class=""><strong>CNAME Flattening</strong>: Erlaubt es, die Apex-Domain (<code>globaldevlog.com</code>) ohne A-Record-Starrheit direkt auf GitHub Pages zu mappen.</li>
<li class=""><strong>Universal SSL</strong>: Stellt HTTPS-Zertifikate an der Edge bereit und erzwingt HTTP-zu-HTTPS-Weiterleitungen.</li>
</ul>
</li>
<li class=""><strong>Hosting-Plattform (GitHub Pages)</strong>: Liefert die Docusaurus-Build-Artefakte weltweit aus.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-multi-engine-seo-indexierung-fallen-und-lösungen">2. Multi-Engine SEO-Indexierung: Fallen und Lösungen<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-adsense-seo-guide#2-multi-engine-seo-indexierung-fallen-und-l%C3%B6sungen" class="hash-link" aria-label="Direkter Link zur 2. Multi-Engine SEO-Indexierung: Fallen und Lösungen" title="Direkter Link zur 2. Multi-Engine SEO-Indexierung: Fallen und Lösungen" translate="no">​</a></h3>
<p>Bei der Registrierung in internationalen und regionalen Suchmaschinen treten häufig typische Fehler auf:</p>
<table><thead><tr><th style="text-align:left">Suchmaschine</th><th style="text-align:left">Typisches Problem</th><th style="text-align:left">Technische Ursache &amp; Lösung</th></tr></thead><tbody><tr><td style="text-align:left"><strong>Google Search Console</strong></td><td style="text-align:left">„Sitemap konnte nicht gelesen werden“</td><td style="text-align:left">Docusaurus generiert standardmäßig <code>/sitemap.xml</code>. Bei Domain-Wechsel muss die alte Property gelöscht und ein DNS-TXT-Eintrag verifiziert werden.</td></tr><tr><td style="text-align:left"><strong>Naver Search Advisor</strong></td><td style="text-align:left">„Host-URL stimmt nicht überein“</td><td style="text-align:left">Naver verlangt strikte Übereinstimmung zwischen RSS-Link und registrierter URL (Trailing Slashes beachten).</td></tr><tr><td style="text-align:left"><strong>Bing Webmaster Tools</strong></td><td style="text-align:left">Verzögerte Indexierung</td><td style="text-align:left">Direkter Import über Google Search Console OAuth2 beschleunigt die Freischaltung auf wenige Minuten.</td></tr></tbody></table>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/github-pages-custom-domain-adsense-seo-guide#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Eigene Domain zwingend erforderlich</strong>: Google AdSense lehnt kostenlose Subdomains (<code>github.io</code>) grundsätzlich ab; eine eigene Apex-Domain ist Pflicht.</li>
<li class=""><strong>Porkbun + Cloudflare-Vorteil</strong>: CNAME Flattening und Universal SSL ermöglichen Zero-Downtime-Betrieb bei maximaler Ausfallsicherheit.</li>
<li class=""><strong>Multi-Engine SEO</strong>: Neben Google sollten Naver und Bing über saubere Sitemaps (<code>/sitemap.xml</code>) und RSS-Feeds parallel bedient werden.</li>
<li class=""><strong>Kanonische Weiterleitungen</strong>: Erzwingen Sie HTTPS und leiten Sie <code>www</code> konsistent auf die Apex-Domain weiter.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="docusaurus" term="docusaurus"/>
        <category label="devops" term="devops"/>
        <category label="cloudflare" term="cloudflare"/>
        <category label="seo" term="seo"/>
        <category label="web-monetization" term="web-monetization"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Leitfaden 2026] npm audit-Schwachstellen beheben ohne Builds zu zerstören: Die Wahrheit über npm audit fix --force]]></title>
        <id>https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth</id>
        <link href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth"/>
        <updated>2026-10-18T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Wie Sie npm audit-Schwachstellen beheben, ohne Produktions-Builds zu beschädigen. Warum 45 Build-Tool-Sicherheitslücken auf statischen Seiten kein Laufzeitrisiko darstellen und wie GHSA-Warnungen sicher gelöst werden.]]></summary>
        <content type="html"><![CDATA[<p>Jeder moderne Frontend-Entwickler kennt diesen plötzlichen Adrenalinstoß: Sie führen <code>npm audit</code> in Ihrem Dokumentations- oder Blog-Repository aus, und das Terminal warnt in leuchtend roter Schrift:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">45 vulnerabilities (15 moderate, 15 high, 15 critical)</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">To address all issues (including breaking changes), run:</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  npm audit fix --force</span><br></div></code></pre></div></div>
<p>Begriffe wie <strong>Critical</strong>, <strong>Remote Code Execution (RCE)</strong> und <strong>Prototype Pollution</strong> lösen sofort den Reflex aus, <code>npm audit fix --force</code> einzugeben, um die roten Warnungen schnellstmöglich verschwinden zu lassen.</p>
<p>In der Welt statischer Website-Generatoren (<strong>Static Site Generators, SSG</strong>) wie Docusaurus, Next.js (SSG) oder Hugo, die auf GitHub Pages oder AWS S3 gehostet werden, ist dieser Befehl jedoch oft ein fataler Fehler: Er bricht Produktions-Builds durch inkompatible Major-Updates, ohne die tatsächliche Sicherheit um ein einziges Prozent zu verbessern.</p>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-bedrohungsmodellierung-dynamischer-webserver-vs-statische-seite-ssg">1. Bedrohungsmodellierung: Dynamischer Webserver vs. Statische Seite (SSG)<a href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth#1-bedrohungsmodellierung-dynamischer-webserver-vs-statische-seite-ssg" class="hash-link" aria-label="Direkter Link zur 1. Bedrohungsmodellierung: Dynamischer Webserver vs. Statische Seite (SSG)" title="Direkter Link zur 1. Bedrohungsmodellierung: Dynamischer Webserver vs. Statische Seite (SSG)" translate="no">​</a></h3>
<p>Um zu verstehen, warum die meisten <code>npm audit</code>-Warnungen auf statischen Seiten Fehlalarme für die Produktionssicherheit sind, betrachten wir die fundamentale Angriffsfläche:</p>
<p><img decoding="async" loading="lazy" alt="Bedrohungsmodellierung: Dynamischer Webserver vs Statische Seite" src="https://globaldevlog.com/de/assets/images/01_threat_model-e9bc3435c9cf84ced67bdb27b1bffa32.png" width="881" height="1009" class="img_ev3q"></p>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="traditioneller-dynamischer-server-nodejs--express--django">Traditioneller dynamischer Server (Node.js / Express / Django)<a href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth#traditioneller-dynamischer-server-nodejs--express--django" class="hash-link" aria-label="Direkter Link zur Traditioneller dynamischer Server (Node.js / Express / Django)" title="Direkter Link zur Traditioneller dynamischer Server (Node.js / Express / Django)" translate="no">​</a></h4>
<ul>
<li class=""><strong>24/7 aktiver Prozess</strong>: Ein Node.js-Daemon lauscht kontinuierlich auf Port 80/443.</li>
<li class=""><strong>Echtzeit-Ausführung</strong>: Trifft eine bösartige HTTP-Anfrage ein, durchläuft sie Middleware-Pakete. Eine Schwachstelle (z. B. Prototype Pollution in <code>lodash</code> oder RCE in einer Template-Engine) kann zur Kompromittierung des gesamten Servers und zum Diebstahl von Umgebungsvariablen führen.</li>
</ul>
<h4 class="anchor anchorTargetStickyNavbar_Vzrq" id="statische-website-docusaurus--github-pages-cdn">Statische Website (Docusaurus / GitHub Pages CDN)<a href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth#statische-website-docusaurus--github-pages-cdn" class="hash-link" aria-label="Direkter Link zur Statische Website (Docusaurus / GitHub Pages CDN)" title="Direkter Link zur Statische Website (Docusaurus / GitHub Pages CDN)" translate="no">​</a></h4>
<ul>
<li class=""><strong>Reine Build-Zeit-Nutzung</strong>: Node.js läuft ausschließlich lokal oder in GitHub Actions während des Build-Prozesses.</li>
<li class=""><strong>Null Backend-Prozesse zur Laufzeit</strong>: An die Besucher werden ausschließlich vorab kompilierte statische HTML-, CSS- und JavaScript-Dateien über Anycast-CDNs ausgeliefert.</li>
<li class=""><strong>RCE-Risiko = 0 %</strong>: Selbst wenn ein Build-Tool (<code>webpack</code>, <code>micromatch</code>) eine theoretische RCE-Lücke hat, existiert zur Laufzeit kein Server, der Anfragen entgegennimmt.</li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-gefahren-von-npm-audit-fix---force">2. Die Gefahren von <code>npm audit fix --force</code><a href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth#2-die-gefahren-von-npm-audit-fix---force" class="hash-link" aria-label="Direkter Link zur 2-die-gefahren-von-npm-audit-fix---force" title="Direkter Link zur 2-die-gefahren-von-npm-audit-fix---force" translate="no">​</a></h3>
<p>Der Parameter <code>--force</code> erlaubt npm, grundlegende Major-Versionssprünge (<code>breaking changes</code>) durchzuführen. Bei Docusaurus führt dies regelmäßig dazu, dass Webpack- oder Babel-Plugins auf Versionen aktualisiert werden, die von Docusaurus noch nicht unterstützt werden. Das Ergebnis: Die Schwachstellenwarnung verschwindet, aber <code>npm run build</code> bricht mit kryptischen Syntaxfehlern ab.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="3-best-practices-der-4-stufen-sicherheitsleitfaden">3. Best Practices: Der 4-Stufen-Sicherheitsleitfaden<a href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth#3-best-practices-der-4-stufen-sicherheitsleitfaden" class="hash-link" aria-label="Direkter Link zur 3. Best Practices: Der 4-Stufen-Sicherheitsleitfaden" title="Direkter Link zur 3. Best Practices: Der 4-Stufen-Sicherheitsleitfaden" translate="no">​</a></h3>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    A[npm audit meldet Schwachstellen] --&gt; B{Betrifft die Lücke devDependencies?}</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    B --&gt;|Ja: Build-Tools wie Webpack/Babel| C[Prüfen: Wird Code ins Client-Bundle gepackt?]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    C --&gt;|Nein: Reines Build-Tool| D[Risiko im SSG-Kontext: 0% | Kein npm audit fix --force!]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    C --&gt;|Ja: Client-Runtime| E[Selektives Update via package.json overrides]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    B --&gt;|Nein: Echte Runtime-Abhängigkeit| E</span><br></div></code></pre></div></div>
<ol>
<li class=""><strong>Abhängigkeitsbereich prüfen</strong>: Unterscheiden Sie strikt zwischen Entwicklungs-Tools (<code>devDependencies</code>) und Client-Bibliotheken.</li>
<li class=""><strong>Selective Overrides nutzen</strong>: Verwenden Sie das <code>overrides</code>-Feld in <code>package.json</code>, um Sub-Abhängigkeiten gezielt ohne Breaking Changes zu patchen:<!-- -->
<div class="language-json codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-json codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token property" style="color:#36acaa">"overrides"</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token punctuation" style="color:#393A34">{</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">  </span><span class="token property" style="color:#36acaa">"nth-check"</span><span class="token operator" style="color:#393A34">:</span><span class="token plain"> </span><span class="token string" style="color:#e3116c">"^2.1.1"</span><span class="token plain"></span><br></div><div class="token-line" style="color:#393A34"><span class="token plain"></span><span class="token punctuation" style="color:#393A34">}</span><br></div></code></pre></div></div>
</li>
<li class=""><strong>CI-Pipelines absichern</strong>: Nutzen Sie <code>npm audit --omit=dev</code> in Produktions-Checks.</li>
</ol>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/static-site-security-npm-audit-truth#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Kein blindes <code>npm audit fix --force</code></strong>: Erzwungene Updates brechen Build-Pipelines durch inkompatible Major-Versionen.</li>
<li class=""><strong>SSG-Sicherheitsvorteil</strong>: Da statische Seiten ohne laufenden Node.js-Server über CDNs ausgeliefert werden, stellen reine Build-Tool-Lücken kein Produktions-Laufzeitrisiko dar.</li>
<li class=""><strong>Präzises Patchen mit Overrides</strong>: Aktualisieren Sie betroffene transitive Abhängigkeiten gezielt über <code>package.json overrides</code>.</li>
<li class=""><strong>Fokus auf echte Bedrohungen</strong>: Schützen Sie stattdessen Ihre CI/CD-Secrets und Deployment-Tokens.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="web-security" term="web-security"/>
        <category label="npm-audit" term="npm-audit"/>
        <category label="docusaurus" term="docusaurus"/>
        <category label="devops" term="devops"/>
        <category label="supply-chain" term="supply-chain"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Vision AI] ANPR-OCR-Engine, Regex-Normalisierung & Temporales Majority Voting (Evolution von v01 bis v11) (#5)]]></title>
        <id>https://globaldevlog.com/de/blog/2026-06-29-vision-anpr-5</id>
        <link href="https://globaldevlog.com/de/blog/2026-06-29-vision-anpr-5"/>
        <updated>2026-06-29T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Syntaxvalidierung von Kennzeichen, EasyOCR-Optimierung, temporales Sliding-Window Majority Voting und die Entwicklungsreise über 11 Iterationen von v01 bis v11.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Temporales Majority Voting und finale Verifikation" src="https://globaldevlog.com/de/assets/images/01_voting_evolution-02da50ebc7e87755c32fbc132dc9b992.png" width="2131" height="1599" class="img_ev3q"></p>
<blockquote>
<p>📌 <strong>Kernaussagen (TL;DR)</strong></p>
<ul>
<li class=""><strong>Herausforderung</strong>: Einzelne Frames führen durch Fahrzeugneigung und Spiegelungen unweigerlich zu Lesefehlern (z. B. Verwechslung von <code>6</code> und <code>8</code> oder <code>B</code> und <code>8</code>).</li>
<li class=""><strong>Lösung</strong>: Kombination aus EasyOCR, syntaktischer Regex-Korrektur und temporalem Mehrheitsentscheid (<em>Sliding-Window Majority Voting</em>) über 11 Frames.</li>
</ul>
</blockquote>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-das-temporale-majority-voting-verfahren">1. Das temporale Majority-Voting-Verfahren<a href="https://globaldevlog.com/de/blog/2026-06-29-vision-anpr-5#1-das-temporale-majority-voting-verfahren" class="hash-link" aria-label="Direkter Link zur 1. Das temporale Majority-Voting-Verfahren" title="Direkter Link zur 1. Das temporale Majority-Voting-Verfahren" translate="no">​</a></h3>
<p>Statt dem Ergebnis eines einzelnen Frames blind zu vertrauen, aggregiert das System Erkennungen über ein gleitendes Zeitfenster von 11 aufeinanderfolgenden Bildern:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    F1["Frame 1: 24가1511"] --&gt; Buffer[Ringpuffer: 11 Frames]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    F2["Frame 2: 24가1511"] --&gt; Buffer</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    F3["Frame 3: 24가1571 (Fehllesung)"] --&gt; Buffer</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    F4["Frame 4: 24가1511"] --&gt; Buffer</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Buffer --&gt; Voting{"Majority Voting: Welcher String hat die höchste Frequenz?"}</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Voting --&gt;|8 von 11 Stimmen| Confirmed["Bestätigtes Kennzeichen: 24가1511 (Konfidenz: 94.2%)"]</span><br></div></code></pre></div></div>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-die-evolutionäre-reise-von-v01-bis-v11">2. Die evolutionäre Reise: Von v01 bis v11<a href="https://globaldevlog.com/de/blog/2026-06-29-vision-anpr-5#2-die-evolution%C3%A4re-reise-von-v01-bis-v11" class="hash-link" aria-label="Direkter Link zur 2. Die evolutionäre Reise: Von v01 bis v11" title="Direkter Link zur 2. Die evolutionäre Reise: Von v01 bis v11" translate="no">​</a></h3>
<p>Über 11 Entwicklungszyklen steigerte das Team die End-to-End-Erkennungsrate von initial 31 % auf über 96 % unter realen Straßenbedingungen.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-06-29-vision-anpr-5#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Konsens schlägt Einzelframe</strong>: Temporales Voting filtert kurzzeitige Erkennungsfehler durch Vibrationen zuverlässig heraus.</li>
<li class=""><strong>Regex-Syntaxschutz</strong>: Ungültige Zeichenmuster werden noch vor dem Voting syntaktisch korrigiert.</li>
<li class=""><strong>Hohe Zuverlässigkeit</strong>: Über 11 Iterationen wurde eine Erkennungsgenauigkeit von über 96 % in Realaufnahmen erreicht.</li>
<li class=""><strong>Vollständige Pipeline</strong>: Die Kombination aller 6 Stufen liefert ein produktionsreifes System für intelligente Verkehrsanwendungen.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="computer-vision" term="computer-vision"/>
        <category label="anpr" term="anpr"/>
        <category label="easyocr" term="easyocr"/>
        <category label="regex" term="regex"/>
        <category label="voting-ensemble" term="voting-ensemble"/>
        <category label="python" term="python"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Vision AI] Artefakte in Dashcam-Videos überwinden: Deep Super-Resolution (EDSR vs FSRCNN) & Multi-Frame Image Stacking (#4)]]></title>
        <id>https://globaldevlog.com/de/blog/2026-06-28-vision-anpr-4</id>
        <link href="https://globaldevlog.com/de/blog/2026-06-28-vision-anpr-4"/>
        <updated>2026-06-28T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Rekonstruktion niedrig aufgelöster Kennzeichen-Ausschnitte mittels 4x EDSR Deep Super-Resolution und temporalem Multi-Frame Image Stacking.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="EDSR Deep Super-Resolution Vergleich" src="https://globaldevlog.com/de/assets/images/01_edsr_sr_comparison-02da50ebc7e87755c32fbc132dc9b992.png" width="2131" height="1599" class="img_ev3q"></p>
<blockquote>
<p>📌 <strong>Kernaussagen (TL;DR)</strong></p>
<ul>
<li class=""><strong>Herausforderung</strong>: Ausgeschnittene Kennzeichen messen oft unter 40x20 Pixel mit starker H.264-Kompressionsblockbildung. Standard-Bikubik-Interpolation verwäscht Zeichenkonturen.</li>
<li class=""><strong>Lösung</strong>: Einsatz von EDSR (Enhanced Deep Residual Networks) zur 4-fachen Kantenrekonstruktion und Multi-Frame-Mittelung zur Rauschunterdrückung.</li>
</ul>
</blockquote>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-edsr-vs-fsrcnn-der-qualitätsvergleich">1. EDSR vs. FSRCNN: Der Qualitätsvergleich<a href="https://globaldevlog.com/de/blog/2026-06-28-vision-anpr-4#1-edsr-vs-fsrcnn-der-qualit%C3%A4tsvergleich" class="hash-link" aria-label="Direkter Link zur 1. EDSR vs. FSRCNN: Der Qualitätsvergleich" title="Direkter Link zur 1. EDSR vs. FSRCNN: Der Qualitätsvergleich" translate="no">​</a></h3>
<table><thead><tr><th style="text-align:left">Modell</th><th style="text-align:left">Rechenzeit (ms)</th><th style="text-align:left">Rekonstruktionsqualität</th><th style="text-align:left">Geeignet für</th></tr></thead><tbody><tr><td style="text-align:left"><strong>Bikubische Interpolation</strong></td><td style="text-align:left">&lt; 1 ms</td><td style="text-align:left">Sehr unscharf; Zeichen verschwimmen</td><td style="text-align:left">Nicht nutzbar für OCR</td></tr><tr><td style="text-align:left"><strong>FSRCNN (Fast SR)</strong></td><td style="text-align:left">~ 8 ms</td><td style="text-align:left">Mäßige Kantenschärfung</td><td style="text-align:left">Mobile Edge-Geräte</td></tr><tr><td style="text-align:left"><strong>EDSR (Enhanced Deep Residual)</strong></td><td style="text-align:left">~ 35 ms</td><td style="text-align:left"><strong>Hervorragende Zeichenschärfe &amp; Kontrast</strong></td><td style="text-align:left"><strong>Produktions-Pipeline</strong></td></tr></tbody></table>
<p>EDSR entfernt unnötige Batch-Normalisierungs-Schichten und nutzt erweiterte Residualblöcke, wodurch hochfrequente Ziffernstrukturen selbst aus stark verpixelten Dashcam-Ausschnitten wiederhergestellt werden.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-06-28-vision-anpr-4#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Grenzen klassischer Interpolation</strong>: Bikubische Verfahren verstärken Blockartefakte und verhindern korrekte OCR-Ergebnisse.</li>
<li class=""><strong>EDSR 4x Rekonstruktion</strong>: Neuronale Residualnetzwerke schärfen Buchstabenkonturen und Kontraste signifikant.</li>
<li class=""><strong>Multi-Frame-Stacking</strong>: Temporale Mittelung eliminiert Sensorrauschen vor der Weitergabe an das OCR-Modul.</li>
<li class=""><strong>Verifizierte OCR-Voraussetzung</strong>: Die Super-Resolution erhöht die anschließende Erkennungsrate von 42 % auf über 89 %.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="computer-vision" term="computer-vision"/>
        <category label="super-resolution" term="super-resolution"/>
        <category label="edsr" term="edsr"/>
        <category label="image-stacking" term="image-stacking"/>
        <category label="anpr" term="anpr"/>
        <category label="deep-learning" term="deep-learning"/>
        <category label="python" term="python"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Vision AI] Hierarchische Objekterkennung: YOLOv3 Fahrzeug-ROI, YOLOv5 Kennzeichendetektor & CSRT-Tracking (#3)]]></title>
        <id>https://globaldevlog.com/de/blog/2026-06-27-vision-anpr-3</id>
        <link href="https://globaldevlog.com/de/blog/2026-06-27-vision-anpr-3"/>
        <updated>2026-06-27T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Zweistufige hierarchische Lokalisierung: Globale Fahrzeugerkennung via YOLOv3, gezielte Kennzeichen-Inferenz via YOLOv5 und CSRT-Korrelationsfilter-Tracking bei 50 FPS.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="YOLOv5 Kennzeichen-Lokalisierung" src="https://globaldevlog.com/de/assets/images/01_plate_localization-e3a163202d7a73e57bdf504aafdd6919.png" width="957" height="766" class="img_ev3q"></p>
<blockquote>
<p>📌 <strong>Kernaussagen (TL;DR)</strong></p>
<ul>
<li class=""><strong>Herausforderung</strong>: Die Suche nach winzigen Kennzeichen (30x15 Pixel) im vollen 1080p-Frame führt zu massiven False Positives an Schildern und senkt die Inferenzrate unter 10 FPS.</li>
<li class=""><strong>Lösung</strong>: Zweistufige Hierarchie — Erst Fahrzeug finden (YOLOv3), dann Kennzeichen nur im Ausschnitt suchen (YOLOv5) und Zwischenframes mit schnellem CSRT-Tracking überbrücken.</li>
</ul>
</blockquote>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-das-hierarchische-detektionsprinzip">1. Das hierarchische Detektionsprinzip<a href="https://globaldevlog.com/de/blog/2026-06-27-vision-anpr-3#1-das-hierarchische-detektionsprinzip" class="hash-link" aria-label="Direkter Link zur 1. Das hierarchische Detektionsprinzip" title="Direkter Link zur 1. Das hierarchische Detektionsprinzip" translate="no">​</a></h3>
<p>Statt das gesamte Bild mit einem schweren neuronalen Netz nach kleinsten Mustern zu durchsuchen, nutzt das System eine stufenweise Verengung:</p>
<div class="language-mermaid codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-mermaid codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">flowchart TD</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Frame[Vollbild 1920x1080] --&gt; Step1["Schritt 1: YOLOv3 detektiert Fahrzeug-ROI (Großes Bounding Box)"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Step1 --&gt; Crop[Fahrzeug-Ausschnitt isolieren]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Crop --&gt; Step2["Schritt 2: YOLOv5 detektiert Kennzeichen im Stoßstangenbereich"]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Step2 --&gt; Plate[Kennzeichen-Patch (z.B. 40x20 px)]</span><br></div><div class="token-line" style="color:#393A34"><span class="token plain">    Plate --&gt; Step3["Schritt 3: CSRT Tracker übernimmt Folgebilder mit 50+ FPS"]</span><br></div></code></pre></div></div>
<p>Durch das CSRT-Tracking muss das teure YOLOv5-Netzwerk nur alle 5 Frames ausgeführt werden. Die Zwischenbilder werden durch Korrelationsfilter stabil und ressourcenschonend verfolgt.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-06-27-vision-anpr-3#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Hierarchische Verengung</strong>: Eliminiert False Positives an Straßenschildern und Werbetafeln vollständig.</li>
<li class=""><strong>5-fache Geschwindigkeitssteigerung</strong>: CSRT-Tracking reduziert die GPU-Inferenzlast drastisch.</li>
<li class=""><strong>Stabile Verfolgung</strong>: Kennzeichen bleiben auch bei leichten Verdeckungen und Nickbewegungen im Fokus.</li>
<li class=""><strong>Optimale ROI-Übergabe</strong>: Der präzise Kennzeichenausschnitt wird direkt an die Super-Resolution-Stufe weitergeleitet.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="computer-vision" term="computer-vision"/>
        <category label="anpr" term="anpr"/>
        <category label="yolo" term="yolo"/>
        <category label="csrt-tracker" term="csrt-tracker"/>
        <category label="object-detection" term="object-detection"/>
        <category label="opencv" term="opencv"/>
        <category label="python" term="python"/>
    </entry>
    <entry>
        <title type="html"><![CDATA[[Vision AI] Dynamische Fahrspurbegrenzung & Geometrisches IoU-Übertrittskriterium (#2)]]></title>
        <id>https://globaldevlog.com/de/blog/2026-06-26-vision-anpr-2</id>
        <link href="https://globaldevlog.com/de/blog/2026-06-26-vision-anpr-2"/>
        <updated>2026-06-26T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Canny-Kantenfilterung, probabilistische Hough-Transformation (HoughLinesP), Steigungsschwellenwerte und geometrische Polygon-IoU-Berechnung zur Spurerkennung.]]></summary>
        <content type="html"><![CDATA[<p><img decoding="async" loading="lazy" alt="Dynamische Spurerkennung Overlay" src="https://globaldevlog.com/de/assets/images/01_lane_detection-0ce024bbbafb08d7449c40abec7b6dc2.png" width="2149" height="1599" class="img_ev3q"></p>
<blockquote>
<p>📌 <strong>Kernaussagen (TL;DR)</strong></p>
<ul>
<li class=""><strong>Herausforderung</strong>: Blendung durch nasse Fahrbahnen, Teer-Risse und Schatten erzeugen fehlerhafte Linien; einfache X-Koordinaten-Vergleiche erkennen Spurübertritte nicht zuverlässig.</li>
<li class=""><strong>Lösung</strong>: Kombination aus adaptiver ROI-Trapezmaske, Steigungsfilterung positiver/negativer Geraden und Polygon-Flächenüberlappung (IoU &gt; 0,15).</li>
</ul>
</blockquote>
<!-- -->
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="1-mathematische-formulierung-der-spurextraktion">1. Mathematische Formulierung der Spurextraktion<a href="https://globaldevlog.com/de/blog/2026-06-26-vision-anpr-2#1-mathematische-formulierung-der-spurextraktion" class="hash-link" aria-label="Direkter Link zur 1. Mathematische Formulierung der Spurextraktion" title="Direkter Link zur 1. Mathematische Formulierung der Spurextraktion" translate="no">​</a></h3>
<p>Die Fahrbahnbegrenzung wird durch Geradengleichungen in der Bildebene modelliert:</p>
<div class="language-text codeBlockContainer_Ckt0 theme-code-block" style="--prism-color:#393A34;--prism-background-color:#f6f8fa"><div class="codeBlockContent_QJqH"><pre tabindex="0" class="prism-code language-text codeBlock_bY9V thin-scrollbar" style="color:#393A34;background-color:#f6f8fa"><code class="codeBlockLines_e6Vv"><div class="token-line" style="color:#393A34"><span class="token plain">y = m · x + b,   wobei m = (y2 - y1) / (x2 - x1)</span><br></div></code></pre></div></div>
<p>Um irrelevante horizontale Markierungen und Schatten auszuschließen, definieren wir strikte Steigungsgrenzen:</p>
<ul>
<li class=""><strong>Linke Spur</strong>: $-0.85 &lt; m &lt; -0.45$</li>
<li class=""><strong>Rechte Spur</strong>: $+0.45 &lt; m &lt; +0.85$</li>
</ul>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="2-geometrisches-iou-kriterium-für-spurübertritte">2. Geometrisches IoU-Kriterium für Spurübertritte<a href="https://globaldevlog.com/de/blog/2026-06-26-vision-anpr-2#2-geometrisches-iou-kriterium-f%C3%BCr-spur%C3%BCbertritte" class="hash-link" aria-label="Direkter Link zur 2. Geometrisches IoU-Kriterium für Spurübertritte" title="Direkter Link zur 2. Geometrisches IoU-Kriterium für Spurübertritte" translate="no">​</a></h3>
<p>Ein Spurübertritt gilt als verifiziert, wenn das Polygon der Fahrzeug-Unterkante <code>P_{	ext{vehicle}}</code> die Grenzlinie der Fahrspur <code>P_{	ext{lane}}</code> schneidet:</p>
<p><code>	ext{IoU}_{	ext{intrusion}} = rac{	ext{Area}(P_{	ext{vehicle}} \cap P_{	ext{lane}})}{	ext{Area}(P_{	ext{vehicle}})} &gt; 	heta_{	ext{threshold}}</code></p>
<p>Mit einem Schwellenwert $	heta = 0.15$ werden kurzzeitige Messausreißer zuverlässig abgefangen, während ein echter Spurwechsel deterministisch registriert wird.</p>
<hr>
<h3 class="anchor anchorTargetStickyNavbar_Vzrq" id="-management-summary-35-zeilen">📌 Management Summary (3–5 Zeilen)<a href="https://globaldevlog.com/de/blog/2026-06-26-vision-anpr-2#-management-summary-35-zeilen" class="hash-link" aria-label="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" title="Direkter Link zur 📌 Management Summary (3–5 Zeilen)" translate="no">​</a></h3>
<ol>
<li class=""><strong>Robuste Filterung</strong>: Steigungsschwellenwerte eliminieren 95 % aller Störlinien durch Schatten und Teerfugen.</li>
<li class=""><strong>Polygon-IoU statt Punkt-Vergleich</strong>: Die Flächenüberlappung verhindert Fehlauslösungen bei Kurvenfahrten.</li>
<li class=""><strong>Echtzeit-Performance</strong>: Die Hough-Transformation auf der Trapez-ROI beansprucht weniger als 3 Millisekunden pro Frame.</li>
<li class=""><strong>Deterministische Übergabe</strong>: Verifizierte Spurübertritte triggern automatisch die hochauflösende Kennzeichenerfassung.</li>
</ol>]]></content>
        <author>
            <name>Jaybee</name>
            <uri>https://github.com/jbjihwan</uri>
        </author>
        <category label="computer-vision" term="computer-vision"/>
        <category label="anpr" term="anpr"/>
        <category label="lane-detection" term="lane-detection"/>
        <category label="hough-transform" term="hough-transform"/>
        <category label="iou" term="iou"/>
        <category label="opencv" term="opencv"/>
        <category label="python" term="python"/>
    </entry>
</feed>