Stanford CS329A (Ep 11): Agent Memory — MemGPT, Cartridges, CacheBlend und hierarchische Kontextarchitektur

Wenn Entwickler autonome KI-Agenten als langfristige Partner oder autonome Software-Engineering-Assistenten in der industriellen Praxis einsetzen, stoßen sie unweigerlich auf drei gravierende architektonische Hürden:
- „Der Agent vergisst fundamentale Architekturentscheidungen, die in der gestrigen Sitzung mühsam erarbeitet wurden, über Nacht vollständig.“
- „Das Einspeisen einer 100.000 Zeilen umfassenden Codebasis in ein 1-Million-Token-Kontextfenster führt zu massivem Aufmerksamkeitsverlust (Lost-in-the-Middle-Phänomen) und explodierenden API-Rechnungen.“
- „Beim Kombinieren mehrerer Dokumentfragmente (Chunks) in RAG-Pipelines werden vorhandene Präfix-KV-Caches ungültig, wodurch die Latenz bis zum ersten Token (TTFT) auf mehrere Sekunden ansteigt.“
Das menschliche Gehirn löst dieses Dilemma mit bestechender Eleganz: Es verfügt über ein stark begrenztes Arbeitsgedächtnis (nur 4 bis 7 Chunks), ruft jedoch Erinnerungen aus Jahrzehnten blitzschnell ab und synthetisiert domänenübergreifendes Wissen ohne kognitive Lähmung.
In der Fortsetzung von Teil 3: Agent Engineering von Stanford CS329A: Self-Improving AI Agents untersuchen wir die Agent Memory Architecture — wie moderne Systeme autonomen Agenten persistentes, hierarchisches Erinnerungsvermögen über drei Abstraktionsebenen hinweg verleihen:
- Software-Steuerungsebene (MemGPT, UC Berkeley 2023): Vom Betriebssystem inspiriertes virtuelles Speicher-Paging.
- Neuronale Repräsentationsebene (Cartridges, 2025): Kontextdestillation via Self-Study, die 500-seitige Dokumente in modulare, kontinuierliche KV-Vektoren komprimiert.
- Systeminfrastruktur-Ebene (CacheBlend, EuroSys 2025): Selektive KV-Neuberechnung, die Cross-Attention wiederherstellt und RAG-Latenzen um den Faktor 3.3x senkt.
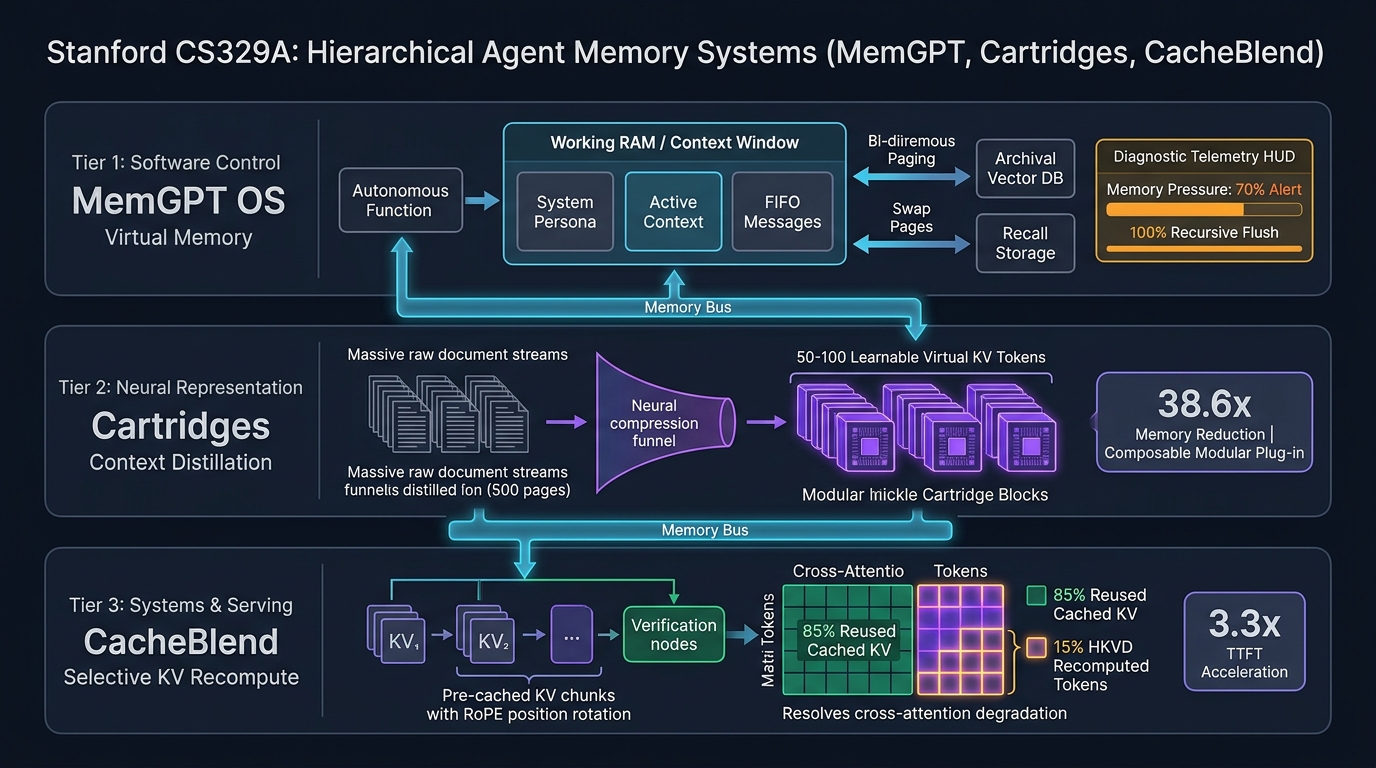
1. Das Dilemma des Langzeitkontexts und hierarchisches Speichermanagement
Das einfache Vergrößern des physischen Kontextfensters eines LLMs (z. B. von 8k auf über 1M Token) löst das Gedächtnisproblem nicht. Reines Brute-Force-Scaling führt zu drei fundamentalen Systemgrenzen:
- Aufmerksamkeitsdiffusion & Lost-in-the-Middle: Die Self-Attention flacht bei extrem langen Sequenzen ab, sodass subtile Fakten inmitten gigantischer Prompts übersehen werden.
- Ökonomische Untragbarkeit: Das wiederholte Senden von Hunderttausenden Token in jedem Dialogschritt verbrennt Rechenbudgets exponentiell.
- Statische Flüchtigkeit: Nach Beendigung eines Inferenzschritts verflüchtigen sich die Aktivierungen; der Agent kann seinen internen Zustand nicht ohne externe Intervention fortschreiben.
Um dauerhafte Autonomie zu gewährleisten, entkoppeln moderne Architekturen den schnellen Arbeitskontext (Working Context) vom riesigen Langzeitspeicher (Long-Term Storage) mittels strukturierter Hierarchical Context Management.
┌─────────────────────────────────────────────────────────────────────────┐
│              Der 3-Stufen-Abstraktions-Stack für Agent Memory           │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│ Software-Steuerungsebene │  │  Neuronale Repräsentat.  │  │ Systeminfrastruktur-Ebene│
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Virtuelles OS-Paging   │  │ • Self-Study-Destillation│  │ • Multi-Chunk-RAG-Fusion │
│ • Hauptkontext (RAM)     │  │ • Kontinuierliche KV-Vekt│  │ • Selektive KV-Neuberech.│
│ • Vektor-DB (Disk)       │  │ • 38.6x Speicherersparnis│  │ • Top 15% HKVD Recompute │
│ • Autonome Eviction      │  │ • 26.4x Durchsatzgewinn  │  │ • RoPE-Rotationsmatrix   │
│ • Deep Memory Recall 92% │  │ • Lego-Modulbauweise     │  │ • 3.3x TTFT-Latenzabfall │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Software-Steuerungsebene: MemGPT (UC Berkeley 2023)
Betriebssysteme haben Speicherbeschränkungen vor Jahrzehnten gemeistert. Ein modernes OS bietet Programmierern die Illusion unbegrenzten RAMs, indem es virtuelle Speicherseiten über die Memory Management Unit (MMU) transparent zwischen schnellem DRAM und Festplattenspeichern auslagert (Swap-in / Swap-out).
Das von Packer et al. an der UC Berkeley entwickelte MemGPT Long-Term Memory überträgt diese Betriebssystemarchitektur direkt auf Sprachmodelle:
„Das Promptfenster des LLMs ist das physische RAM. Externe Vektordatenbanken und relationale Protokolle sind die Festplatte. Indem wir das Modell mit Funktionsaufrufen (Function Calling) ausstatten, um Erinnerungen autonom zu prüfen, zu bearbeiten, auszulagern und abzurufen, wird der Agent zu seinem eigenen Betriebssystem.“
    ┌────────────────── [Hauptkontext (RAM: 8k~128k Token Limit)] ──────────────────┐
    │ 1. System Instructions : Kernidentität und Speicher-Befehlshandbuch (Read-only)│
    │ 2. Working Context     : Benutzerprofil, statische Fakten und Persona (R/W)   │
    │ 3. FIFO Message Queue  : Jüngster Dialogverlauf + Rekursiver Zusammenfassungsk.│
    └───────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
               (Swap-In / Search)                     │ (Swap-Out / Eviction & Flush)
                               │                      ▼
    ┌───────────────── [Externer Kontext (Disk: Unbegrenzter Speicher)] ────────────┐
    │ 1. Recall Storage   : Vollständiger Dialogverlauf mit Zeitstempeln (Postgre)   │
    │ 2. Archival Storage : Dokumenten-Vektordatenbank & Wissensgraphen (HNSW)       │
    └───────────────────────────────────────────────────────────────────────────────┘
Autonome Paging-Mechanismen
Statt den Kontext durch starre Skripte von außen abzuschneiden, steuert das Modell sein Gedächtnis selbst:
- Speicherdruck-Warnung (70%-Schwelle): Erreicht der aktive Dialog 70% der Fensterkapazität, wird ein System-Interrupt ausgelöst:
„Systemwarnung: Kontextfenster zu 70% belegt. Sichern Sie kritische Fakten via
working_context.replace(), bevor alte Nachrichten ausgelagert werden.“ - Rekursive Zusammenfassung & Flush (100%-Limit):
- Bei 100% greift der FIFO-Queue-Manager ein und lagert die ältesten 50% der Nachrichten aus.
- Diese werden nicht verworfen: MemGPT startet eine rekursive Zusammenfassung (Recursive Summarization), die bestehende Zusammenfassungen mit den neuen Fragmenten zu einem kompakten Block am Kopf der Warteschlange verschmilzt.
- Die ursprünglichen Rohdaten wandern dauerhaft in den
Recall Storage.
- Autonomer Heartbeat-Abruf:
- Fragt der Benutzer nach Ereignissen von vor Monaten, ruft das Modell
recall_storage.search()auf und setztrequest_heartbeat=true. Dies ermöglicht autonome Werkzeugketten, um Daten von der Disk ins RAM zu laden, bevor die finale Antwort formuliert wird.
- Fragt der Benutzer nach Ereignissen von vor Monaten, ruft das Modell
Benchmark-Ergebnisse: Deep Memory Recall (DMR)
Im DMR-Benchmark über Dutzende von Sitzungen:
- Standard-GPT-4 mit statischem Fenster brach auf 32,1% Genauigkeit ein.
- MemGPT hielt konstant eine Trefferquote von 92,5%.
- Bei verschachtelten Key-Value-Abfragen (Nested KV Retrieval) stürzten reguläre Modelle ab 3 Hops auf 0% ab, während MemGPT 100% Präzision bewahrte.
3. Neuronale Repräsentationsebene: Cartridges (2025)
MemGPT verwaltet Speicher auf Token-Ebene. Müssen jedoch 500-seitige Unternehmensberichte oder umfangreiche SDKs durchsucht werden, verursacht das Hin- und Herschieben von Rohtext enorme Latenzen und Kosten.
Die 2025 vorgestellte Architektur Cartridges Modular Agent Memory wählt einen radikal neuen Weg:
„Warum Wissen in sperrigen Text-Tokens mitschleppen? Was wäre, wenn ein LLM ein 500-seitiges Dokument offline selbst studieren (Self-Study) und in 50 bis 100 kontinuierliche, trainierbare KV-Cache-Vektoren (Cartridge) verdichten könnte, die sich wie Hardware-Steckmodule nutzen lassen?“
[500-seitiges Dokument / Große Codebasis]
             │
             ▼ (Self-Study Pipeline)
1. Synthetische Dialoggenerierung (Zusammenfassung, Tiefenfragen, Edge-Cases)
             │
             ▼
2. Kontext-Destillation via KL-Divergenz:
   Lehrer-Modell (500 Seiten Volltext + Frage) ──► P_Lehrer(y)
                                                      │ (D_KL Verlust)
   Schüler-Modell (Cartridge Z [50 KV-Tokens] + Frage) ─► P_Schüler(y)
             │
             ▼
[Modulare Cartridge Z (50~100 kontinuierliche KV-Vektoren)]
(38.6x Speicherkompression, 26.4x Durchsatzgewinn, Lego-artige Kombinierbarkeit)
Warum klassische Next-Token-Prediction (NTP) scheitert
Wurde die KV-Repräsentation einfach mit standardmäßiger Next-Token-Prediction trainiert, verfiel das Modell in das „Auswendiglern-Syndrom“:
- Es konnte Textpassagen wortgetreu aufsagen.
- Bei konzeptionellen oder analytischen Fragen über den Text versagte es jedoch völlig. Das Modell lernte nur Oberflächenmuster, kein semantisches Verständnis.
Die Self-Study- und Destillations-Lösung
- Generierung synthetischer Dialoge: Das Modell generiert Tausende vielschichtige Frage-Antwort-Paare über das Dokument hinweg (strukturelle Übersichten, Tiefenanalysen, Grenzfälle).
- Kontext-Destillation:
- Lehrer-Modell: Erhält die vollen 500 Seiten Rohtext im Prompt.
- Schüler-Modell: Erhält nur die kompakten Cartridge-Parameter $Z$ (50–100 virtuelle KV-Tokens) und die Frage.
- Die Parameter $Z$ werden via Gradientenabstieg optimiert, um die Kullback-Leibler-Divergenz (KL) zwischen Schüler und Lehrer zu minimieren:
========================================================================================
Formulierung des Cartridge-Destillationsverlusts:
========================================================================================
min_Z  Σ  D_KL( F( · | Dokument ⊕ x )  ||  F_Z( · | x ) )

Wobei:
  • F( · | Dokument ⊕ x ) : Ausgabelogits des Lehrermodells mit Volltext
  • F_Z( · | x )          : Ausgabelogits des Schülermodells nur mit Cartridge Z
  • Z                     : Kontinuierliche KV-Cache-Tensoren in den Schichten
========================================================================================
Ergebnisse & Modulare Steckbarkeit
- 38.6x Speicherersparnis: In Long-Context-Benchmarks (LongHealth, QASPER) erreichte die Cartridge die gleiche Genauigkeit wie In-Context-Learning, benötigte aber 38.6-mal weniger VRAM.
- 26.4x Inferenzdurchsatz: Durch den Wegfall langer Text-Prefills stieg die Durchsatzrate um das 26.4-Fache.
- Lego-artige Zusammensetzbarkeit: Werden einem Agenten gleichzeitig eine AMD-10-K-Cartridge und eine PepsiCo-Cartridge eingesteckt, kann er firmenübergreifende Finanzanalysen ohne erneutes Training fehlerfrei ausführen!
4. Systeminfrastruktur-Ebene: CacheBlend (EuroSys 2025)
Auf der Hardware- und Serving-Ebene stoßen RAG-Agenten auf fundamentale Ineffizienzen.
Werden 10 verschiedene Dokumenten-Chunks in einen Prompt eingebunden, stehen bisherige Serving-Engines vor einem unlösbaren Widerspruch:
- Prefix Caching (vLLM): Nur das erste Dokumentenfragment kann gecacht werden. Ändert sich die Reihenfolge, verfällt der gesamte nachfolgende Cache (Prefill-Dauer: 3 bis 6 Sekunden).
- Natives Zusammenfügen (PromptCache): Berechnet man jeden Chunk isoliert vor und fügt die Caches zusammen, wird die Cross-Attention zwischen Chunks ignoriert, was die Antwortgenauigkeit um bis zu 50% einbrechen lässt.
Das auf der EuroSys 2025 prämierte CacheBlend KV Cache Merging löst diesen Konflikt durch selektive KV-Neuberechnung (Selective KV Recompute):
[Vorberechnete KV-Caches der Dokumentfragmente A, B und C]
                           │
                           ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              CacheBlend Schichtweise selektive Neuberechnung            │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Identifikation der Top 15% High-deviation KV (HKVD) Cross-Tokens     │
│ 2. Neuberechnung der Attention NUR für diese kritischen 15%             │
│ 3. Direktes Verschmelzen der verbleibenden 85% aus vorab berechn. Cache │
│ 4. RoPE-Rotationsmatrix zur exakten Anpassung der absoluten Koordinaten │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Ultra-schneller Prefill: 3.3x schnellere TTFT, ΔF1 < 0.01]
Der mathematische Durchbruch: Sparsity der Attention
Die Autoren wiesen nach:
„Werden mehrere Textfragmente zusammengesetzt, verändern sich bei weniger als 15% der Tokens die Aufmerksamkeitsgewichte signifikant durch Nachbarfragmente. Über 85% der Tokens bleiben gegenüber dem Kontext praktisch invariant!“
- High-Deviation KV Detection (HKVD): In jeder Schicht filtert CacheBlend dynamisch die obersten 15% der abweichenden Tokens heraus und berechnet nur diese neu.
- Latenzverdeckung durch Pipelining: Während die GPU die 15% berechnet (~2 ms), lädt ein asynchroner I/O-Thread bereits die Tensoren der nächsten Schicht von NVMe-SSDs in den VRAM. Die Rechenzeit verschwindet komplett im Schatten des Datentransfers.
- RoPE-Positionskorrektur: Durch das Verschieben der Chunks ändern sich deren absolute Positionen. CacheBlend wendet eine 2D-Givens-Rotationsmatrix auf die Key-Tensoren an, wodurch die Positionskoordinaten in Mikrosekunden mathematisch exakt wiederhergestellt werden.
Leistungsdaten
- 3.3x niedrigere TTFT: Die Latenz bis zum ersten Token sank bei komplexen RAG-Aufgaben von 3.450 ms auf 1.050 ms.
- 5x höherer Serverdurchsatz: GPU-Cluster können das fünffache an parallelen Agenten-Anfragen bedienen.
- Kein Genauigkeitsverlust: Die Abweichung im F1-Score gegenüber vollständiger Neuberechnung lag unter 0,01.
5. Vergleichstabelle der Speicherparadigmen
=============================================================================================================
Dimension             MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
Abstraktionsebene     Software-Steuerung / OS-Paging Neuronale Repräsentation      Inferenz-Infrastruktur
Haupteinheit          Text-Tokens & JSON-Funktionen  Kontinuierliche KV-Vektoren   Vorberechnete KV-Tensoren
Kapazitätshorizont    Unbegrenzt (Externe Datenbank) 50–100 Tokens pro Dokument    Dynamisches Multi-Chunk RAG
Aktualisierungsmodus  Autonome Funktionsaufrufe      Self-Study KL-Destillation    Selektive Recompute (15% HKVD)
Hardware-Effekt       Beseitigt Kontextüberlauf      38.6x geringerer VRAM-Bedarf  3.3x schnellere TTFT
Kombinierbarkeit      Relationale Datenbankabfragen  Modulare Matrix-Kopplung      RoPE-Rotationsanpassung
=============================================================================================================
6. Technische Tiefenanalyse (Q&A)
F1: Woher weiß MemGPT autonom, WANN es den externen Speicher abfragen muss?
MemGPT nutzt präzise Systemanweisungen am Kopf des Kontexts, kombiniert mit standardisiertem Function Calling:
„Du bist eine autonome Intelligenz mit Langzeitgedächtnis. Bei Fragen zu vergangenen Unterhaltungen oder Benutzerdaten, die nicht im aktiven Arbeitskontext stehen, darfst du NICHT raten. Du MUSST zuerst
recall_storage.search()aufrufen.“
Fehlen Fakten, steuern die Aufmerksamkeitsköpfe auf die Erzeugung des Funktionsaufrufs als wahrscheinlichsten Tokenpfad hin. Durch das Flag request_heartbeat=true erhält das Modell die Suchergebnisse sofort zurück, sodass die Abrufschleife ohne menschliche Unterbrechung schließt.
F2: Warum zerstört das willkürliche Aneinanderhängen von KV-Caches nicht die RoPE-Positionskodierung?
Bei klassischer absoluter Positionseinbettung müsste ein verschobener Token komplett neu eingebettet werden.
RoPE (Rotary Position Embedding) kodiert Positionen jedoch als Drehungen im 2D-Koordinatenraum, wobei das Skalarprodukt ausschließlich vom relativen Abstand $(m - n)$ abhängt:
K_neu = R_Theta(p_neu - p_alt) * K_cached
CacheBlend passt den Key-Vektor einfach durch Multiplikation mit der Rotationsmatrix der Positionsdifferenz $(p_neu - p_alt)$ an. Dies erfordert vernachlässigbare Rechenzeit (under 10 microseconds) und garantiert absolute mathematische Konsistenz.
Fazit & Ausblick
Autonomie erfordert Gedächtnis. MemGPT demonstrierte, wie Betriebssystemkonzepte unbegrenzten kognitiven Horizont eröffnen. Cartridges zeigte, wie enzyklopädisches Wissen in handliche, kontinuierliche Vektoren destilliert wird. CacheBlend bewies, dass selektives Neuberechnen Latenzen um 3.3x einbrechen lässt.
In Lektion 12 vollenden wir Teil 3 mit dem entscheidenden Prüfstein für künstliche Intelligenz: Agent Evaluation & Long Tasks — Messung von Langzeit-Trajektorien, GDPVal und DeepScholar-Bench.
Wichtigste Erkenntnisse
- Hierarchische Trennung: Schneller Arbeitskontext (RAM) und skalierbare externe Speicher (Disk) müssen getrennt verwaltet werden.
- Kontinuierliche Vektoren statt Textwände: Cartridges reduzieren den Speicherbedarf um das 38.6-Fache bei voller modularer Kombinierbarkeit.
- Sparsity für Instant-Prefill: Das selektive Neuberechnen der 15% abweichenden Tokens (CacheBlend) beschleunigt den ersten Token um das 3.3-Fache.