Stanford CS329A (Ep 12): Agent Evaluation & Long Tasks — METR-Zeithorizonte, OpenAI GDPval und DeepScholar-Bench

Wenn ein Entwicklungsteam einen autonomen Software-Engineering-Agenten vorstellt und dabei auf „92% im MMLU-Test“ verweist, löst dies in Führungsetagen und bei Investoren oft nur Achselzucken aus. Die geschäftlichen Kernfragen sind ungleich konkreter und anspruchsvoller:
- „Kann dieser autonome Agent eine mehrstündige, hochkomplexe Aufgabe ohne menschliche Intervention selbstständig von A bis Z lösen?“
- „Wenn ein menschlicher Senior-Ingenieur 8 Stunden für ein kritisches Produktions-Refactoring oder eine Finanzmodellierung benötigt, liefert dieser Agent vergleichbare Qualität? Und wie hoch ist sein ökonomischer Nettowert in echtem Geld ($)?“
Klassische akademische Benchmarks (MMLU, GSM8K, HumanEval) sind mit Resultaten jenseits der 90% weitgehend gesättigt und durch Trainingsdaten-Kontamination im Internet kompromittiert. Vor allem ist das Lösen eines 5-sekündigen Multiple-Choice-Rätsels meilenweit entfernt von Long-Horizon Agent Tasks, die Hunderte von aufeinander aufbauenden Entscheidungen über mehrere Stunden erfordern.
Zum feierlichen Abschluss von Teil 3: Agent Engineering (Lektionen 10 bis 12) von Stanford CS329A: Self-Improving AI Agents untersuchen wir die moderne Wissenschaft der Agent Evaluation Benchmarks — die Messung agentischer Intelligenz nicht anhand von Prozentpunkten, sondern in physikalischen Einheiten von menschlicher Arbeitszeit und ökonomischen Dollars ($):
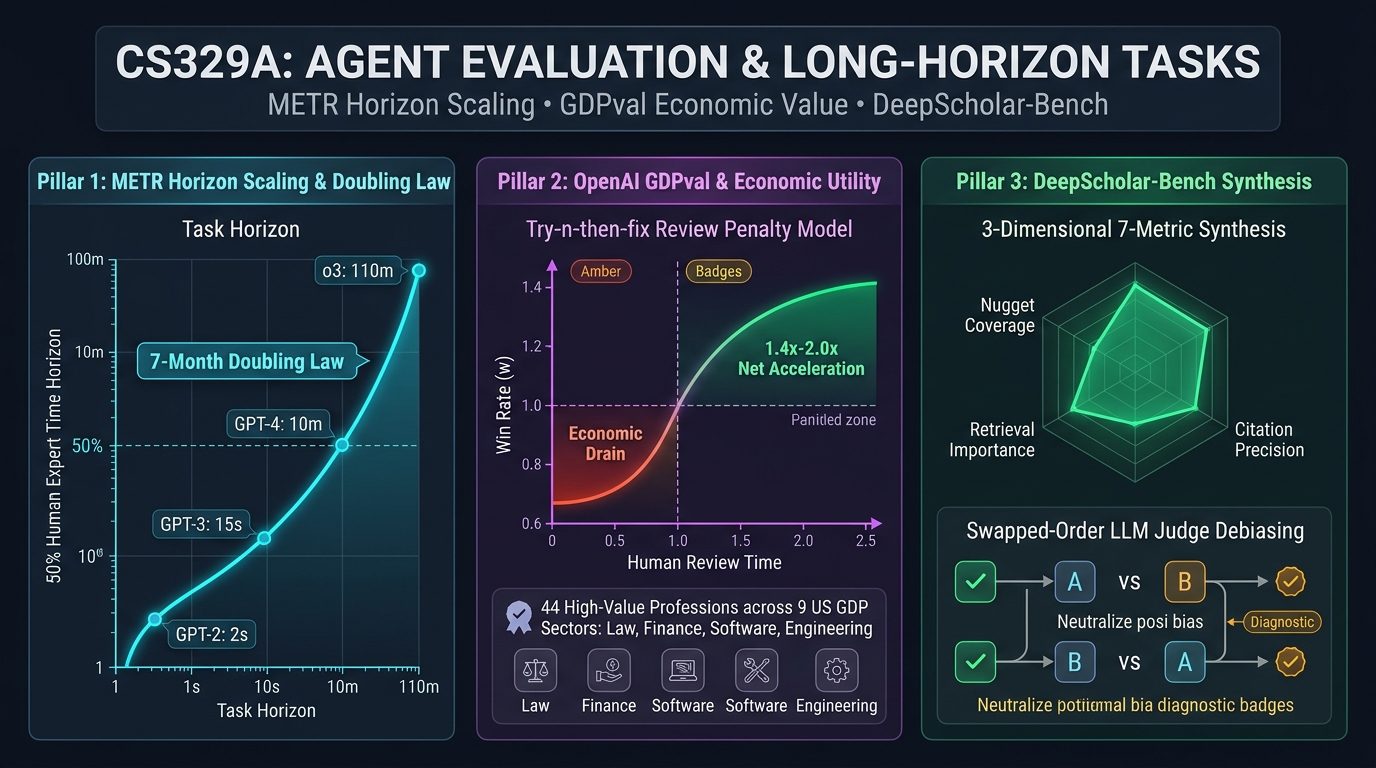
- Menschliche Zeithorizonte (METR, 2025): Der 50%-Erfolgs-Zeithorizont (h_agent) und das empirische 7-Monate-Verdopplungsgesetz.
- Ökonomischer Realwert (OpenAI GDPval, 2025): Evaluation von 44 Berufen in den 9 Kernsektoren des US-BIP und die strenge Mathematik der „Try-n-then-fix“-Prüfkosten.
- Kontaminationsfreie akademische Forschungsevaluation (DeepScholar-Bench, 2025): 3-dimensionales 7-Metriken-System und Verfahren zur Beseitigung von Positionsverzerrungen bei LLM-Judges.
1. Die Evaluationskrise: Warum Multiple-Choice-Tests versagen
Über fünf Jahre lang verließ sich die KI-Forschung auf statische Frage-Antwort-Datensätze. Beim Einsatz autonomer Agenten in der Praxis traten jedoch fundamentale Mängel zutage:
- Sättigung & Kontamination: Spitzenmodelle erreichten rasch über 90% im MMLU, weil Testfragen beim Web-Crawling im Vortraining auswendig gelernt wurden.
- Fehlender Zeithorizont: Eine Multiple-Choice-Frage erfordert 2 Sekunden und 1 Schritt. Reale Softwareentwicklung verlangt das kohärente Halten interner Zustände über mehr als 100 sequentielle Werkzeugaufrufe.
- Die Illusion der perfekten Aufgabenstellung: Herkömmliche Tests bieten saubere Formulierungen. Reale Industrieaufgaben sind von Natur aus chaotisch (Task Messiness): uneindeutige Anforderungen, schwankende Netzwerklatenzen, kryptische Logdateien und irreversible Zerstörungsrisiken.
Führende KI-Labore verwarfen daher Multiple-Choice-Prüfungen zugunsten kontinuierlicher physikalischer Metriken.
┌─────────────────────────────────────────────────────────────────────────┐
│               Die 3 Säulen moderner Agenten-Evaluation                  │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│   METR Zeithorizonte     │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Maßstab: Menschl. Zeit │  │ • Maßstab: Echte US-Dollar│ │ • Maßstab: 7-Metriken-Vec│
│ • 50% Erfolgs-Horizont h │  │ • 44 wissensint. Berufe  │  │ • Wöchentl. arXiv-Feed  │
│ • 7-Monate-Verdopplung   │  │ • Try-n-then-fix Formel  │  │ • Null Datenkontamination│
│ • Task Messiness Faktor  │  │ • 14 Jahre Branchenexpert│  │ • Nugget Coverage (39%)  │
│ • 2s (GPT-2) -> 110m (o3)│  │ • Win-Rate Schwelle 40%  │  │ • Swapped-Order Debias  │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Intelligenz in menschlicher Arbeitszeit messen: METR (2025)
Die Aussage, ein Modell erreiche 88%, sagt nichts über seine zeitliche Autonomie aus. Das renommierte Forschungslabor METR (Model Evaluation and Threat Research) schuf einen bahnbrechenden Standard:
„Vergesst Prozentwerte. Messt stattdessen die Wahrscheinlichkeit, mit der ein KI-Agent eine Aufgabe löst, für die ein qualifizierter menschlicher Experte die Zeit $t$ benötigt. Definiert die Intelligenz durch den 50%-Zeithorizont (h_agent) — die Dauer einer menschlichen Aufgabe, die das Modell mit 50% Wahrscheinlichkeit meistert.“
    [170 komplexe Software- & ML-Aufgaben (Sekunden bis 8 Stunden Aufwand)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [Menschl. Expertenzeit t]      [Empirische Erfolgsrate p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [Item-Response-Theory (IRT) Logistische Regression]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [50%-Zeithorizont h_agent: GPT-2 (2s) ──► OpenAI o3 (110 Min.)]
Die logistische Zeithorizont-Formel
Aufbauend auf der psychometrischen Item-Response-Theorie (IRT) modelliert METR die Erfolgswahrscheinlichkeit $p$ als logistische Funktion von menschlicher Aufgabendauer t_task und Agentenkapazität h_agent:
========================================================================================
METR Zeithorizont-Erfolgswahrscheinlichkeitsformel:
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

Wobei:
  • t_task  : Durchschnittliche Zeit, die ein qualifizierter Experte benötigt
  • h_agent : Der 50%-Erfolgs-Zeithorizont des Agenten (wenn t_task = h_agent, p = 0.5)
  • β_agent : Steigungsparameter für den Leistungsabfall bei steigender Komplexität
  • σ(z)    : Standard logistische Sigmoid-Funktion 1 / (1 + exp(-z))
========================================================================================
Das 7-Monate-Verdopplungsgesetz
Die Auswertung von 16 Spitzenmodellen zwischen 2019 und 2025 belegte ein deterministisches exponentielles Gesetz:
- 2019 (GPT-2): Zeithorizont von 2 Sekunden (einfache Autovervollständigung).
- 2021 (GPT-3): Zeithorizont von 15 Sekunden.
- 2023 (GPT-4): Zeithorizont von 10 Minuten.
- 2025 (OpenAI o3): Zeithorizont von 110 Minuten (~2 Stunden).
- Empirischer Trend: Der 50%-Zeithorizont verdoppelt sich exakt alle 7 Monate (207 Tage).
- Zukunftsprojektion: Hält dieser Trend an, werden autonome Agenten zwischen 2028 und 2030 Aufgaben mit 50% Wahrscheinlichkeit autonom lösen, für die ein menschlicher Experte einen vollen Monat (160 Stunden) konzentriert arbeiten muss.
3. Realen ökonomischen Wert messen: OpenAI GDPval (2025)
Während METR die Zeit erfasste, verankerte OpenAIs Benchmark GDPval die Agentenleistung im wirtschaftlichen Kapital.
OpenAI wählte 44 hochbezahlte digitale Berufe aus den 9 Hauptsektoren des US-BIP aus (Finanzwesen, Recht, Softwareentwicklung, Engineering, Medizinverwaltung etc.). Es wurden Experten mit durchschnittlich 14 Jahren Berufserfahrung engagiert, um 220 reale Aufgaben zu entwerfen (DCF-Finanzmodelle, Patentanalysen, Datenverarbeitungspipelines):
- Durchschnittliche Bearbeitungszeit durch Menschen: 9,5 Stunden (Median 5,0 Stunden).
- Durchschnittlicher Marktwert pro Aufgabe: 398 US-Dollar (~550.000 KRW).
Die Wahrheit über Blind Win Rates
Senior-Experten bewerteten Modellarbeiten und Arbeiten menschlicher Kollegen im Doppelblindverfahren:
- GPT-4o: Blind Win Rate von 12,5% (fiel bei Branchenexperten fast durchgängig durch).
- OpenAI o3: Blind Win Rate von 35,2%.
- Claude Opus 4.1: Blind Win Rate von 47,6% (Gewonnen oder Unentschieden)!
- Spitzenmodelle liefern inzwischen Ergebnisse, die erfahrene Praktiker in fast der Hälfte der Fälle als gleichwertig oder überlegen einstufen.
Die Illusion der Geschwindigkeit und die Try-n-then-fix-Kosten
Marketingversprechen lauten oft: „Der Agent erledigte eine 9-Stunden-Aufgabe in 2 Minuten — 270x schneller!“ GDPval widerlegt diese Sichtweise durch die Formalisierung des menschlichen Prüf- und Korrekturaufwands:
========================================================================================
Reale ökonomische Zeit-Kosten-Gleichung (Try-n-then-fix Modell):
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

Wobei:
  • M_T : Generierungszeit des Modells (wenige Minuten)
  • R_T : Zeit, die der menschliche Prüfer zur detaillierten Revision benötigt
  • H_T : Basiszeit für die vollständige Neuerstellung durch den Menschen
  • w   : Modell-Win-Rate (Wahrscheinlichkeit, dass der Entwurf akzeptabel ist)
  • n   : Maximale Anzahl von Versuchen, bevor der Mensch aufgibt und selbst tippt
========================================================================================
Die Gewinnschwelle: Vom Bremsklotz zum Produktivitätsgewinn
- Ist die Modellqualität gering ($w < 20%$, z. B. GPT-4o), verbringt der Prüfer Stunden mit der Fehlersuche und verwirft den Entwurf letztlich. Die Folge: Der Einsatz von GPT-4o führte zu einer Netto-Verlangsamung um 13% (0,87x Arbeitsgeschwindigkeit)!
- Erst bei Überschreiten der kritischen Schwelle von $w \ge 40%$ (erreicht durch o3 und Opus 4.1) amortisiert sich die Prüfzeit, was in einer realen Produktivitätssteigerung um 1,3x bis 1,4x resultiert.
4. Kontaminationsfreie akademische Forschungsevaluation: DeepScholar-Bench (2025)
Wie bewertet man autonome Agenten bei offenen wissenschaftlichen Syntheseaufgaben, für die es keine eindeutige Musterlösung gibt?
Das im August 2025 vorgestellte DeepScholar-Bench etablierte eine dynamische Pipeline, die wöchentlich neu veröffentlichte arXiv-Preprints einspeist und damit Trainingsdaten-Kontamination vollständig ausschließt.
       [Wöchentlich frische arXiv-Publikationen (0% Kontaminationsgarantie)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               DeepScholar-Bench 3-Dimensionen / 7-Metriken-Stack        │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Wissenssynthese (Knowledge Synthesis)                                │
│    • Organisation & Kohärenz (Logische Struktur, Lesbarkeit, Format)    │
│    • Nugget Coverage (Abdeckung essenzieller atomarer Fakten)           │
│ 2. Recherchequalität (Retrieval Quality)                                │
│    • Relevanzrate (Thematische Passgenauigkeit der zitierten Literatur)│
│    • Dokumentenwichtigkeit (Fähigkeit, wegweisende Grundlagen zu zitier)│
│ 3. Verifizierbarkeit (Verifiability)                                    │
│    • Zitationspräzision (Stimmen Textbehauptungen mit Quellen überein?) │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Swapped-Order LLM-Judge: Mathematische Beseitigung von Positionsfehlern]
Die Ernüchterung des 30,9%-Mittelwerts
Selbst Spitzenforschungssysteme wie OpenAI DeepResearch erreichten über alle 7 Metriken hinweg nur einen geometrischen Mittelwert von 30,9%:
- Brillanter Stil vs. Lückenhafter Inhalt: Agenten schnitten bei Gliederung und Sprache hervorragend ab (Organization: 85,7%), versagten jedoch beim Erfassen harter Fakten (Nugget Coverage: 39,2%) und beim Finden historischer Schlüsselpublikationen (Document Importance: 12,4%).
- Das Orakel-Experiment: Übergab man dem Agenten vorab die perfekte Literaturliste (Oracle Retriever), kletterte die Gesamtpunktzahl lediglich auf 49%. Dies beweist: Der wahre Engpass autonomer Forschung liegt nicht im Suchen, sondern im tiefen synthetisierenden Begreifen umfangreicher Fachliteratur.
5. Vergleichstabelle moderner Evaluationsparadigmen
=============================================================================================================
Dimension             METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
Hauptmessgröße        Menschliche Arbeitszeit (h)   Ökonomischer Realwert ($ USD) 7-Metriken-Qualitätsvektor
Aufgabenfeld          Software- und ML-Entwicklung  44 wissensintensive Berufe    Offene Forschungssynthese
Wahrheitskriterium    Deterministische Unit-Tests   Doppelblind-Bewertung 14 J.   Atomare Fakten-Nuggets
Kontaminationsschutz  Isolierte Air-Gapped-Aufgaben Reale Unternehmens-Szenarien  Dynamischer arXiv-Livestream
Prüfkosten-Modell     Nicht modelliert (Auto-Pass)  Try-n-then-fix Kostenformel   Swapped-Order Judge-Debiasing
Aktuelle Spitze       o3: 110 Min. (50% Erfolg)     Opus 4.1: 47,6% Win-Rate      DeepResearch: 30,9% Geo-Mean
=============================================================================================================
6. Technische Tiefenanalyse (Q&A)
F1: Was bedeutet „Task Messiness“ bei METR und wie beeinflusst sie die Agentenleistung?
METR quantifiziert mit der Task Messiness 16 Störfaktoren realer Industrieumgebungen:
- Dynamische Umgebung: Das System verändert sich während der Ausführung (Netzwerklatenzen, Datenbank-Locks).
- Irreversible Aktionen: Zerstörerische Operationen (z. B. fehlerhaftes
DROP TABLEoder fehlerhafte Git-Pushes), die kein einfaches Zurückspringen erlauben. - Aktive Informationsbeschaffung: Inputs werden nicht serviert; der Agent muss Logdateien durchsuchen und Abhängigkeiten erschließen.
Die statistische Auswertung ergab: Mit jedem zusätzlichen Punkt auf der Messiness-Skala fiel die Erfolgsrate des Agenten um 8,1%. Reale Überlegenheit erfordert Resistenz gegen dieses Umgebungsrauschen.
F2: Wie beseitigt das „Swapped-Order-Verfahren“ Positionsverzerrungen bei LLM-Judges?
Lässt man einen LLM-Judge zwei Entwürfe $(A)$ und $(B)$ vergleichen, bevorzugt das Modell mit 60% bis 70% Wahrscheinlichkeit systematisch den zuerst genannten Entwurf $(A)$ (Position Bias).
Um diesen Fehler exakt aufzuheben, nutzt DeepScholar-Bench das Swapped-Order-Mittelungsverfahren:
- Durchlauf 1: Vorlage als
[A, B], Erfassung des Bewertungsvektors $S_1 = [s(A), s(B)]$. - Durchlauf 2: Vertauschte Vorlage als
[B, A], Erfassung des Vektors $S_2 = [s(B), s(A)]$. - Bildung des arithmetischen Mittels:
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
Unter identischen Temperaturparametern heben sich die reihenfolgebedingten Verzerrungen mathematisch exakt auf.
Fazit & Abschluss von Teil 3
Mit Lektion 12 haben wir Teil 3 · Agent Engineering (L10–L12) erfolgreich abgeschlossen:
- In Lektion 10 meisterten wir SWE-Agents und profilergestützte KernelBench-GPU-Optimierung.
- In Lektion 11 lösten wir das Langzeitgedächtnis via MemGPT, Cartridges und CacheBlend.
- In Lektion 12 maßen wir die Agentenleistung an harten physikalischen Maßstäben: Menschliche Zeit (METR) und Wirtschaftlicher Ertrag (GDPval).
Damit steht das vollständige systemtechnische Fundament moderner autonomer Agenten.
Ausblick auf Teil 4: Die Frontlinien der KI
Im finalen Abschnitt unseres Kurses, Part 4 · Frontiers (Lektionen 13 bis 17), betreten wir den theoretischen Gipfel künstlicher Intelligenz: Das Wesen maschinellen Denkens.
Wir starten in Lektion 13 mit: 《LLM Reasoning: Grundlagen des Schließens, Chain-of-Thought und emergente kognitive Skalierung》, basierend auf den wegweisenden Arbeiten von Denny Zhou (Google DeepMind).
Kern-Erkenntnisse
- Zeit statt Punkte: Der 50%-Erfolgszeithorizont (h_agent) verdoppelt sich alle 7 Monate — von 2 Sekunden (GPT-2) auf 110 Minuten (o3).
- Prüfkosten diktieren den ROI: Liegt die Win-Rate unter 40%, führt der menschliche Korrekturaufwand zu wirtschaftlichen Verlusten.
- Synthese ist die wahre Herausforderung: Beim wissenschaftlichen Arbeiten ist das Auffinden von Quellen gelöst; das tiefgehende synthetische Verständnis bleibt die ungelöste Grenze.