Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — Formale Verifikation, Lean 4, AlphaGeometry und Gemini Deep Think

In unserer vorherigen Vorlesung über LLM-Reasoning haben wir analysiert, wie Chain-of-Thought (CoT)-Prompting und Self-Consistency-Decodierung mehrstufiges kausales Schließen in neuronalen Netzen entfachten. In missionskritischen Bereichen — wie der Verifikation kryptografischer Protokolle, Raumfahrt-Flugsteuerungssoftware oder den anspruchsvollsten mathematischen Beweisen der Welt — birgt natürlicher Freitext jedoch eine fundamentale Schwachstelle:
"Ganz gleich, wie eloquent und plausibel eine von einem LLM generierte Gedanken-Kette in natürlicher Sprache erscheint: Sie bleibt eine probabilistische Sequenz stochastischer Token. Ein einziger subtiler Vorzeichenfehler, ein Zirkelschluss oder ein halluziniertes Lemma bringt das gesamte System zum Einsturz. In der reinen Mathematik ist ein zu 99% korrekter Beweis gleichbedeutend mit einem zu 0% korrekten Beweis."
Willkommen zu Vorlesung 14 von Stanford CS329A: Self-Improving AI Agents, dem zweiten Teil von Part 4: Frontiers (Frontiers in Reasoning & Autonomy). Basierend auf den bahnbrechenden Arbeiten unter der Leitung von Dr. Thang Luong (Senior Research Director bei Google DeepMind) untersuchen wir, wie künstliche Intelligenz von stochastischer Wortvorhersage zu unfehlbarer, mechanisch verifizierter mathematischer Deduktion aufstieg und historische Medaillen bei der Internationalen Mathematik-Olympiade (IMO) errang:
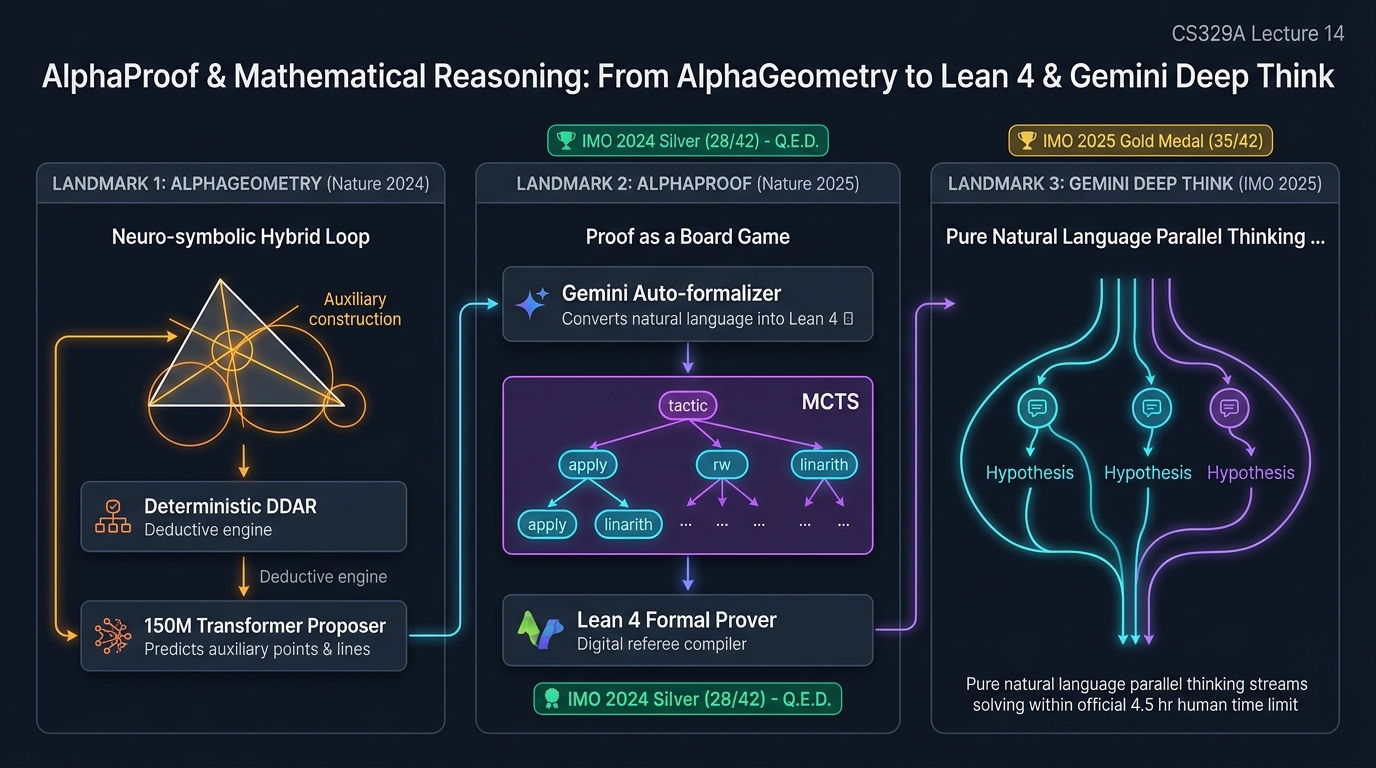
- AlphaGeometry (Nature 2024): Die neuro-symbolische Synthese deterministischer Deduktions-Engines mit generativen Transformern für kreative geometrische Hilfskonstruktionen.
- AlphaProof (DeepMind, Nature 2025): Die Transformation formaler Beweisführung in ein AlphaZero-Brettspiel mittels Lean 4, automatischer Formalisierung und Test-Time Reinforcement Learning (TTRL).
- Gemini Deep Think (IMO 2025): Der Triumph des reinen Schließens in natürlicher Sprache und parallelen Denkens (Parallel Thinking), der innerhalb des menschlichen 4,5-Stunden-Zeitlimits die erste offizielle IMO-Goldmedaille (35/42) errang.
- Formale LLM-Verifikation und mathematisches Schließen: Der tiefgreifende Vergleich zwischen maschinell typgeprüften formalen Kernels und unbeschränktem Reinforcement Learning.
1. Mathematik: Der ultimative Lackmustest für Künstliche Intelligenz
Warum gilt die Mathematik unangefochten als der „ultimative Lackmustest (Litmus Test)“ für autonome kognitive Agenten? Während Code-Benchmarks (wie SWE-bench) und Konversationsaufgaben heuristische Näherungen und partielle Toleranzen gestatten, erzwingt die formale Mathematik drei kompromisslose strukturelle Bedingungen:
┌──────────────────────────────────────────────────────────────────────────┐
│              Warum Mathematik der ultimative Härtetest für KI ist        │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Objektive mechanische   │  │ Extreme Reward-Sparsity │  │ Gigantischer            │
│ Verifizierbarkeit       │  │ (Spärliche Belohnung)   │  │ kombinatorischer Raum   │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Formale Logiksysteme  │  │ • Hunderte Deduktions-  │  │ • Unbegrenzter          │
│   (Lean 4, Coq, Isabelle)│   schritte mit 0 Belohnung│    Verzweigungsfaktor im   │
│ • Deterministischer     │    bis zum finalen Q.E.D.  │    Lemmata-Raum (b -> inf) │
│   Typenprüf-Compiler    │  │ • Belohnung wird nur    │  │ • Geometrische Hilfslinien│
│ • 0% Halluzinationsrate │    bei Gesamterfolg vergeben│   erfordern echte Genialität│
│ • Binäre Wahrheit (0 / 1)│ • Kredit-Zuweisung extrem │  │ • Reine Brute-Force     │
│ • Null Fehlertoleranz   │    komplex und schwierig   │    vollständig unmöglich  │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- Objektive mechanische Verifizierbarkeit (Objective Mechanical Verifiability): Anders als bei Literaturaufsätzen oder juristischen Gutachten, deren Bewertung subjektiv ist, wird formale Mathematik von einem deterministischen Compiler-Programm (wie dem Lean 4 Typchecker) mit 100%iger mathematischer Gewissheit überprüft.
- Extreme Belohnungsspärlichkeit (Extreme Reward Sparsity): In einem mehrstufigen Beweis über hunderte Schritte erhält ein Agent keinerlei positive Belohnung, bis das Endziel (
Goal Solved) vollständig erreicht ist. Ein Beweis, der zu 99% korrekt ist, aber im letzten Schritt scheitert, erhält den Reward 0. - Gigantischer kombinatorischer Suchraum (Massive Combinatorial Search Space): Im Gegensatz zu Schach (Verzweigungsfaktor $\approx 35$) oder Go ($\approx 250$) ist der Raum möglicher mathematischer Lemmata, Definitionen und Konstruktionen unbegrenzt ($b \to \infty$).
2. Neuro-symbolische Synthese: AlphaGeometry (Trinh et al., Nature 2024)
Euklidische Geometrieprobleme bei der IMO stellen selbst für Ausnahmebegabungen eine gewaltige Hürde dar. Selbst wer sämtliche Axiome beherrscht, scheitert, wenn er nicht eine kreative Hilfskonstruktion (Auxiliary Construction) findet — etwa das Zeichnen eines Hilfskreises durch drei nicht-triviale Punkte oder das Fällen eines Hilfslotes.
Historisch war die KI-Forschung in zwei Lager gespalten:
- Symbolische Deduktions-Engines (DDAR): Extrem schnell, 100% präzise und fehlerfrei, aber bar jeder schöpferischen Intuition. Sobald Standardregeln erschöpft sind, blockiert das System vollständig.
- Tiefe neuronale Netze (Transformer): Ausgestattet mit starker Mustererkennung und Intuition, jedoch anfällig für numerische Halluzinationen und Winkelfehler.
AlphaGeometry vereinte beide Ansätze in einer asymmetrischen, symbiotischen Architektur:
               +-------------------------------------------+
               |        Euklidisches Geometrieproblem      |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |  Symbolische Engine (DDAR) | <---------+
                        |  - Deduktive Datenbank(DD) │           │
                        |  - Algebraischer Löser(AR) │           │
                        +--------------+-------------+           │
                                       |                         │
                         [Beweisziel bereits erreicht?]          │
                           /                   \                 │
                        (Ja)                   (Nein / Blockiert)│
                         /                       \               │
                        v                         v              │
             +--------------------+    +-----------------------+ │
             | Vollständiger      |    | 150M-Transformer      | │
             | Beweis (Lesbar)    |    | Hilfsfiguren-Vorschlag│ │
             +--------------------+    +-----------+-----------+ │
                                                   |             |
                                      [Vorhersage entscheidender |
                                       Hilfspunkte & Hilfslinien]│
                                                   +-------------+
Die 100-Millionen-Synthesedaten-Engine (Synthetic Data)
Der zentrale Engpass lag im Datenmangel: In der gesamten Geschichte gab es weniger als 1.000 formalisierte Geometriebeweise. DeepMind überwand dies synthetisch:
- Zufällige geometrische Graphen: 1 Milliarde zufällige Konfigurationen aus Punkten, Linien und Kreisen wurden erzeugt.
- Vorwärtsdeduktion: Die symbolische DDAR-Engine leitete systematisch über 100 Millionen gültige geometrische Sätze und Beweispfade aus diesen Zufallskonstruktionen ab.
- Hilfslinien-Abhängigkeitsfilter: Man isolierte 9 Millionen Theoreme, die ausschließlich dann bewiesen werden konnten, wenn zuvor eine spezifische Hilfskonstruktion eingefügt worden war.
- Supervised Distillation: Ein 150M-Parameter-Transformer wurde gezielt darauf trainiert, genau diese unentbehrlichen Hilfskonstruktionen vorherzusagen, sobald die symbolische Engine blockiert.
IMO-Testergebnisse
Auf einem Benchmark aus 30 historischen IMO-Geometrieaufgaben:
- Die zuvor führende symbolische Methode (Wu-Methode) löste lediglich 10 Aufgaben.
- AlphaGeometry löste 25 von 30 Aufgaben innerhalb der offiziellen Prüfungszeit und erreichte das Niveau menschlicher IMO-Goldmedaillengewinner.
- Bei der IMO 2004 Aufgabe 1 entdeckte AlphaGeometry, dass eine von den Prüfern gestellte Prämisse überflüssig war, und verallgemeinerte den Satz in eleganterer Form.
3. Beweise als Brettspiel: AlphaProof (Nature 2025)
Geometrie ist jedoch nur ein Teilgebiet der Mathematik. Um Zahlentheorie, abstrakte Algebra und Kombinatorik zu bewältigen, muss ein System formale logische Schritte präzise beherrschen.
Im Juli 2024 präsentierte das Team um Dr. Thang Luong AlphaProof, ein System, das mathematische Beweisführung als Zweipersonen-Nullsummenspiel gegen einen unbestechlichen Compiler modelliert.
┌──────────────────────────────────────────────────────────────────────────┐
│                   AlphaProof Systemarchitektur                           │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Gemini Auto-Formalizer   │                   │ AlphaZero-Suchnetzwerk    │
├──────────────────────────┤                   ├───────────────────────────┤
│ • Mathematischer Freitext│                   │ • 3B Parameter Transformer│
│ • 100 Mio. Rohaufgaben   │                   │ • Lean 4 Taktik-Policy:   │
│ • Bidirektionale Prüfung │                   │   apply, rw, linarith     │
│ • Lean 4 Formaler Code   │                   │ • Value-Head: Distanz zum │
│ • 80 Mio. gültige Sätze  │                   │   finalen Q.E.D.-Ziel     │
└────────────┬─────────────┘                   └─────────────┬─────────────┘
             │                                               │
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Lean 4 Formaler Kernel   │
                      ├─────────────────────────────┤
                      │ • Strenger Typenprüfer      │
                      │ • Feedback-Schleife         │
                      │ • Binäre Verifikation (0/1):│
                      │   - Taktik-Kompilierung OK  │
                      │   - Typ-Inhabitation Q.E.D. │
                      └─────────────────────────────┘
Die Lean 4-Umgebung: Das unendliche Schachbrett
Lean 4 ist eine rein funktionale Programmiersprache basierend auf dem Calculus of Inductive Constructions (CIC). Gemäß der Curry-Howard-Isomorphie:
- Eine Mathematische Aussage (Proposition) entspricht einem Typ (Type).
- Ein Mathematischer Beweis (Proof) entspricht einem Programmterm (Term), der diesen Typ bewohnt.
- Der Lean-Compiler fungiert als unfehlbarer Schiedsrichter: Wenn der Beweiscode fehlerfrei kompiliert, ist das Theorem 100% bewiesen.
Der Agent beobachtet in jedem Beweisschritt den aktuellen Goal-Zustand und wählt formale Taktiken wie induction, ring, rw [mul_comm] oder linarith.
Auto-Formalisierung: Aufbau von 80 Millionen Theoremen
Weltweit beherrschen weniger als 1.000 Mathematiker Lean 4 fließend. DeepMind nutzte Gemini-Modelle, um Millionen unstrukturierter Lehrbuchaufgaben in Lean 4 zu übersetzen, wodurch ein Korpus aus 80 Millionen formalisierten Theoremen entstand.
Test-Time Reinforcement Learning (TTRL)
Konfrontiert mit Aufgabe 6 der IMO 2024 — einer extrem fordernden Kombinatorikaufgabe, die nur 5 von 609 menschlichen Teilnehmern lösten — gelang der Basis-Policy zunächst kein Durchbruch. DeepMind aktivierte TTRL:
[Eingabe: IMO 2024 Aufgabe 6]
         │
         ▼
[Gemini Automatischer Aufgabensynthesizer]
         │
         ├──> Synthese von 400.000 strukturellen Aufgabenvariationen
         │    (Vereinfachte Parameter, Randfälle, Hilfslemmata)
         ▼
[TPU-Cluster mit tausenden v5e-Beschleunigern]
         │
         ├──> Durchführung von AlphaZero-Selbstspiel auf 400.000 Varianten
         ├──> Dynamische Aktualisierung der Modellgewichte über 3 Tage
         ▼
[Zur Testzeit generiertes, hochspezialisiertes Expertennetzwerk]
         │
         ▼
[100% maschinell verifizierter Lean 4 Beweis für Aufgabe 6 erbracht!]
AlphaProof löste 4 von 6 Aufgaben und errang 28 von 42 Punkten: Die offizielle IMO-Silbermedaille (nur 1 Punkt an Gold vorbei).
4. Reines Schließen in natürlicher Sprache: Gemini Deep Think (IMO 2025)
Trotz des historischen Triumphs von AlphaProof blieben zwei praktische Einschränkungen bestehen:
- Die Übersetzung von Aufgaben in Lean 4 erforderte eine aufwendige Formalisierungspipeline.
- Die TTRL-Schleife beanspruchte 3 Tage massiver TPU-Rechenzeit und überschritt damit das menschliche Wettbewerbslimit von 4,5 Stunden pro Tag.
Im Juli 2025 präsentierte DeepMind Gemini Deep Think, das gänzlich ohne Zwischenübersetzung in formale Sprachen olympisches Gold errang:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think: Paralleles Denken                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Hypothesenpfad A (Alg.) │  │ Hypothesenpfad B (Geom.)│  │ Hypothesenpfad C (Komb.)│
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Fortschritt: 4 Schritte│ │ • Blockiert bei Lemma 3  │  │ • Asymptotische Schranke│
│ • Erkennt Widerspruch   │  │ • Zweig wird beschnitten │  │ • Fließt in Pfad A ein  │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
Gemini Deep Think verzichtet auf sequentielle Einzelschritt-Generierung und setzt auf Paralleles Denken (Parallel Thinking):
- Dutzende unterschiedliche algebraische, geometrische und analytische Hypothesen werden simultan verfolgt.
- Scheitert ein Pfad, rettet das System partielle Invarianten und integriert diese in andere aktive Zweige.
- Innerhalb des offiziellen 4,5-Stunden-Limits löste es 5 von 6 Aufgaben (35 von 42 Punkten) und gewann die weltweit erste offizielle IMO-Goldmedaille für KI.
5. Architekturvergleich: Formale Verifikation vs. RL in natürlicher Sprache
+-----------------------+----------------------------------+----------------------------------+
| Vergleichsdimension   | Formale Verifikation (AlphaProof)| Freies RL (Gemini Deep Think)    |
+-----------------------+----------------------------------+----------------------------------+
| Verifikations-Engine  | Lean 4 Typchecker-Compiler       | Multi-Agenten-LLM & Selbstkritik |
| Halluzinationsrisiko  | Exakt 0% (Mathematisch bewiesen) | > 0% (Subtile Logikbrüche möglich|
| Suchdauer             | Stunden bis 3 Tage (MCTS + TTRL) | 4,5 Stunden (Echtzeit-Inferenz)  |
| Zielbereiche          | Kritische Software, Kryptografie | Offene Wissenschaft, Strategie   |
| Infrastruktur         | Lean 4 Ökosystem, Mathlib        | Hochskalierte verteilte RL-Cluster|
+-----------------------+----------------------------------+----------------------------------+
6. Zentrale Erkenntnisse für das KI-Engineering
- Synthetische Daten eröffnen neue Horizonte: AlphaGeometry bewies, dass deterministische symbolische Engines bei realer Datenknappheit hunderte Millionen Beweise synthetisieren können, um neuronale Netze zu trainieren.
- Formale Verifikation eliminiert Halluzinationen: In missionskritischen Bereichen müssen Agenten an deterministische Compiler-Umgebungen wie Lean 4 gekoppelt werden.
- Test-Time RL erweitert Leistungsgrenzen: AlphaProof zeigte, dass die dynamische Gewichtsanpassung während der Inferenz (TTRL) Lösungen für zuvor unlösbare Probleme erschließt.
- Paralleles Denken in natürlicher Sprache erreicht menschliches Tempo: Gemini Deep Think bewies, dass parallele Hypothesenverfolgung olympiataugliche mathematische Spitzenleistungen innerhalb menschlicher Prüfungsfristen ermöglicht.
In der kommenden Vorlesung 15: Autonomous Systems & Reliability verlassen wir die idealisierte Welt der Mathematik und widmen uns den chaotischen Herausforderungen realer Software-Umgebungen: Selbstheilung (Self-Healing), Sandbox-Sicherheit und robuste Leitplanken für autonome Agenten. Seien Sie gespannt!