Stanford CS329A (Ep 16): Multimodal & Embodied Agents — Robotik-Basismodelle zur Steuerung der physischen Welt (VLA, RT-2, OpenVLA, π₀)

In unserer vorherigen Vorlesung über Autonome Systeme und Zuverlässigkeit haben wir untersucht, wie Software-Agenten innerhalb virtueller Sandboxes operieren, abgesichert durch mehrstufige Sicherheitsgrenzen und AI Control Protokolle. Dennoch sieht sich die KI-Gemeinschaft einer existenziellen Frage gegenüber:
"Kann eine Intelligenz, die ausschließlich auf Computerbildschirme beschränkt ist, Text generiert und Software-Skripte ausführt, jemals echte Allgemeine Künstliche Intelligenz (AGI) erreichen? Unsere physische Realität wird nicht durch virtuelle Shell-Befehle gesteuert; sie wird geformt von Gravitation, Reibung, 3D-Geometrie und den feinen Kontaktdynamiken starrer sowie verformbarer Objekte."
Was geschieht, wenn wir ein multimodales Basismodell mit einem physischen Körper ausstatten — mit zwei hochauflösenden RGB-Augen (Kameras) und einem stählernen Roboterarm mit sieben Freiheitsgraden (Manipulator)?
- Ein rohes Hühnerei behutsam ohne Schalenbruch aufnehmen und in eine Pfanne legen;
- Verstreutes Kinderspielzeug im Wohnzimmer nach Farben sortieren und in Aufbewahrungsboxen ablegen;
- Auf einem industriellen Montageband mikroelektronische Steckverbinder mit einer Genauigkeit von 0,1 Millimetern präzise zusammenfügen!
Willkommen zu Vorlesung 16 von Stanford CS329A: Self-Improving AI Agents, dem vierten Teil von Part 4: Frontiers (Frontiers in Reasoning & Autonomy). Basierend auf den wegweisenden Arbeiten von Dr. Danny Driess (Founding Research Scientist bei Physical Intelligence, ehemals Google DeepMind Robotics) sezieren wir die Architektur von Vision-Language-Action (VLA) Modellen:
- Aktionen als Sprachtoken (RT-2, DeepMind 2023): Die Überführung kontinuierlicher 7DoF-Motorsteuerungssignale in 256 diskrete Vokabulartoken eines 55B-VLM.
- Der Triumph von Open Source (OpenVLA, 2024): Wie eine 7B-Architektur geschlossene 55B-Giganten übertrifft – dank dualer Bildfusion (SigLIP + DINOv2), Quantil-Binning und LoRA-Anpassung auf Consumer-Gaming-GPUs.
- Kontinuierliche Steuerung und Diffusion ($\pi_0$): Wie Flow Matching die Mikrovibrationen diskreter Quantisierung überwindet und komplexe Aufgaben wie das Falten von Wäsche meistert.
- Verkörperte Sicherheitsarchitektur: Zweistufige Schutzsysteme aus softwareseitiger Geschwindigkeitskappung und hardwarenahen Kraft-Momenten-Reflexschleifen.
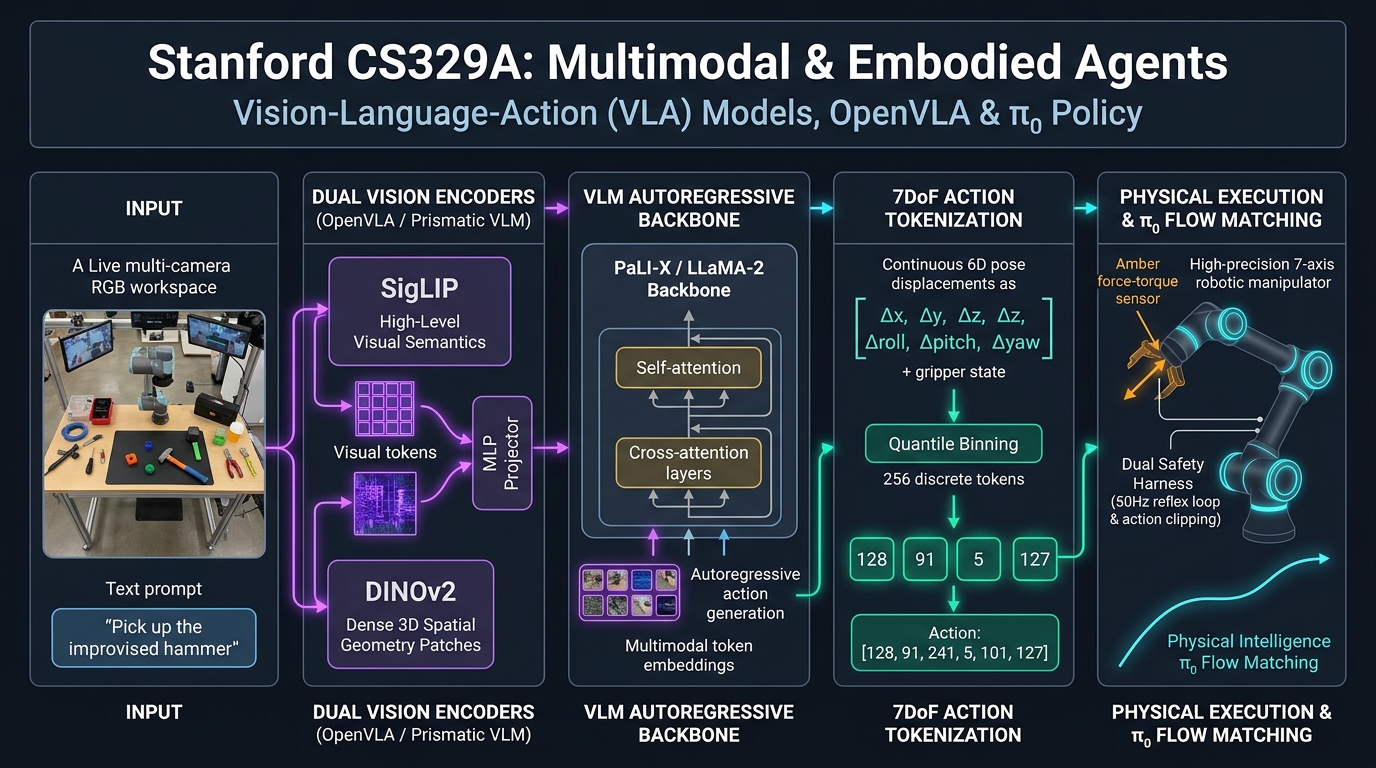
1. Die physische Grenze: Überwindung der Datenknappheit in der Robotik
Über Jahrzehnte hinweg litt die Robotikforschung unter einer lähmenden Datenknappheit. Während Sprachmodelle auf Billionen von Web-Tokens trainiert wurden, waren physische Interaktionsdaten extrem rar und teuer:
- Daten müssen physisch an echten Robotern durch menschliche Teleoperation erfasst werden.
- Eine Flotte von 13 Google-Robotern sammelte in 17 Monaten Dauerbetrieb lediglich rund 130.000 Demonstrationen.
- Herkömmliche Robotik-Policys waren daher extrem fragil: Veränderten sich die Lichtverhältnisse im Raum um 10% oder verschob sich ein Objekt um 5 cm, griff der Arm ins Leere.
Dr. Danny Driess und das DeepMind-Team formulierten einen revolutionären Paradigmenwechsel:
"Trainiert eine Robotik-Policy nicht von Grund auf mit spärlichen Labordaten. Nehmt stattdessen ein massives Vision-Language-Modell (VLM), das auf Milliarden von Web-Bildern und Texten vortrainiert wurde, und bringt ihm bei, Motorbefehle so auszugeben, als wären physische Aktionen schlicht Vokabeln einer weiteren Fremdsprache."
┌──────────────────────────────────────────────────────────────────────────┐
│              Der Paradigmenwechsel zu Vision-Language-Action (VLA)       │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ Klassische Robotik-Policy        │   │ Vision-Language-Action (VLA)     │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • Kleines CNN auf wenigen        │   │ • 7B bis 55B multimodale Basis   │
│   tausend Labordaten trainiert   │   │ • Internetweites Vorwissen       │
│ • Semantische Generalisierung 0% │   │ • Physikalischer Menschenverstand│
│ • Scheitert bei 5 cm Abweichung  │     „Ein Stein taugt als Hammer“     │
│ • Code für jede Aufgabe neu nötig│   │ • Zero-Shot-Transfer auf neue    │
│ • Isolierte Aufgabensilos        │     Objekte und reale Umgebungen     │
└──────────────────────────────────┘   └──────────────────────────────────┘
2. Aktionen als Vokabeln: RT-2 (Brohan et al., DeepMind 2023)
Im Juli 2023 stellte Google DeepMind den Robotic Transformer 2 (RT-2) vor, der multimodale Basismodelle (PaLI-X 55B, PaLM-E 12B) in direkte End-to-End-Robotersteuerungen verwandelte.
[Eingabe: Kamerabild] + [Befehl: „Bewege den Fußball neben das Foto von Messi“]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             Massives VLA-Basismodell (PaLI-X 55B)             │
     │  • Semantisches Webwissen: Identifiziert Lionel Messis Bild   │
     │  • Räumliches Schließen: Berechnet 3D-Koordinaten im Raum     │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (Autoregressive Token-Ausgabe)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ Greifer schließen (127)
                     │       │  │   │   └──┴───┴───── 3D-Rotation (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── 3D-Translation (Δx, Δy, Δz)
                     └─────────────────────────────── Fortsetzungs-Flag
7DoF-Aktionsraum und 256-Bin-Gleichverteilung
Industrielle Roboterarme agieren in einem kontinuierlichen Raum mit 7 Freiheitsgraden (7DoF):
- 3D-Translation ($\Delta x, \Delta y, \Delta z$): Raumverschiebung des Endeffektors.
- 3D-Rotation ($\Delta roll, \Delta pitch, \Delta yaw$): Lageänderung des Handgelenks.
- Greiferzustand ($gripper$): Öffnen und Schließen der Finger.
Um kontinuierliche Fließkommazahlen in diskrete Token für den Transformer zu überführen, nutzt RT-2 eine gleichmäßige Diskretisierung:
- Der Wertebereich
[a_min, a_max](z. B.[-30cm, +30cm]) wird in 256 gleich große Intervalle (Bins) zerlegt:
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad \text{beschränkt auf } [0, 255]
- 256 selten genutzte Token aus dem Vokabular werden als Aktions-Token redefiniert.
- Eine Ausgabe-Beschränkungsmaske (Output Constraint Mask) erzwingt im Aktionsmodus, dass ausschließlich diese 256 gültigen Token generiert werden.
Übertragung von Weltwissen auf den physischen Körper
Weil RT-2 das semantische Vorwissen des Internets beibehält, zeigte es bemerkenswerte Fähigkeiten:
- Obwohl es nie mit dem Begriff „Hammer“ an Robotern trainiert wurde, wählte es auf den Befehl „Nimm einen improvisierten Hammer auf“ ohne Zögern einen Stein statt eines Radiergummis.
- Es führte komplexe relationale Anweisungen aus („Wirf die leere Dose in den Müll“) und verdreifachte die Generalisierungsrate im Vergleich zum Vorgängermodell RT-1.
Co-Fine-Tuning: Schutz vor katastrophalem Vergessen
Wird ein VLM nur auf Roboterdaten feineingestellt, vergisst es sein Sprachverständnis (Catastrophic Forgetting). RT-2 löste dies durch Co-Fine-Tuning, indem jedem Trainingsbatch stets ein Anteil ursprünglicher Bild-Text-Paare beigemischt wurde.
3. Open Source und Demokratisierung: OpenVLA (2024)
Trotz des Erfolgs von RT-2 blieb das 55B-Modell ein proprietäres System, das auf TPU-Cluster angewiesen und für die Forschung unzugänglich war.
2024 veröffentlichten Forscher aus Stanford und Berkeley OpenVLA, ein quelloffenes 7B-VLA-Modell, trainiert auf dem Open X-Embodiment Datensatz (970.000 reale Demonstrationen).
               +-------------------------------------------+
               |              RGB-Kamerabild               |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   SigLIP-Encoder   |     |   DINOv2-Encoder   |
             | (Semantische       |     | (3D-Raumgeometrie  |
             |  Hochwert-Token)   |     |  und Detailtiefe)  |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (Kanal-Verkettung / Concatenation)
                                     v
                        +----------------------------+
                        |     2-Schicht-MLP-Projektor|
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |   Llama-2 7B Sprachbasis   |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |  256 Quantil-Aktions-Token |
                        +----------------------------+
1. Duale Bildfusion: SigLIP + DINOv2 (Prismatic VLM)
Robotik erfordert semantisches Verständnis („Was ist das?“) und Submillimeter-Geometrie („Wo genau liegt der Tassenrand?“):
- SigLIP: Verknüpft Sprache und Bildkonzepte auf hoher Ebene.
- DINOv2: Liefert hochfrequente räumliche Tiefen- und Kantenmerkmale.
- Die Fusion beider Merkmalsvektoren steigerte die Greifpräzision um über 20% gegenüber Einzelsystemen.
2. Quantil-Binning (Quantile Binning)
Das lineare Binning von RT-2 war ineffizient: In der Praxis sind 90% der Bewegungen millimeterfeine Korrekturen, während rasante Armbewegungen selten auftreten.
- OpenVLA berechnete die empirischen Quantile der 970.000 Trajektorien:
\text{Intervallgrenzen: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- Dies konzentriert die Token-Auflösung auf die feinsten Justierbewegungen und reduziert Fehlgriffe drastisch.
3. LoRA-Feintuning auf einer einzigen RTX 4090
- Durch Einfrieren der Bildkomponente und Anwendung von LoRA auf nur 1,4% der Parameter lässt sich OpenVLA binnen 15 Stunden an neue Roboter anpassen.
- 4-Bit-Quantisierung (NF4) reduziert den Speicherbedarf auf 7GB VRAM, was 6Hz Echtzeitsteuerung auf einer herkömmlichen Gaming-GPU (RTX 4090) ermöglicht.
- OpenVLA übertraf den 55B-Koloss RT-2-X in 29 realen Aufgaben um 16,5% höhere Erfolgsquote.
4. Kontinuierliche Steuerung: Physical Intelligence $\pi_0$ (2024)
Trotz aller Erfolge stößt diskrete Tokenisierung an Grenzen:
- Quantisierungsrauschen führt bei Frequenzen über 50Hz zu mechanischem Zittern (Jittering).
- Verformbare Objekte — wie das Falten von Wäsche oder das Montieren von Kartons — verlangen nach kontinuierlichen Bewegungsprofilen.
Dr. Danny Driess und das Team von Physical Intelligence entwickelten mit $\pi_0$ (pi-zero) eine Flow-Matching-Diffusions-Policy:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Physical Intelligence π₀ Architektur                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ High-Level VLM-Planer    │                   │ Kontinuierliche Diffusions-│
├──────────────────────────┤                   │ Policy (Flow Matching)    │
│ • Szenenverständnis      │                   ├───────────────────────────┤
│ • Aufgabenzerlegung      │ ── Latente Ziele ─► • 50Hz Echtzeit-Inferenz    │
│ • Zielüberwachung        │                   │ • Kontinuierliches Vektorfeld│
└──────────────────────────┘                   │ • Kein diskretes Rauschen │
                                               └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [Glatte Bewegungstrajektorie]
                                               (Faltet Wäsche & Kartonagen)
$\pi_0$ generiert über Denoising kontinuierliche Trajektorien in Echtzeit und meistert als erstes einheitliches System komplexe Haushaltstätigkeiten an biegeschlaffen Objekten.
5. Vergleich der Robotik-Basismodelle
+-----------------------+----------------------------------+----------------------------------+
| Merkmal               | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| Modellgröße           | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Llama-2 Basis)               |
| Bild-Encoder          | Einfacher ViT                    | Dual-Fusion (SigLIP + DINOv2)    |
| Diskretisierung       | 256 lineare Bins                 | 256 Quantil-Bins                 |
| Hardware-Anforderung  | Cloud-TPU-Cluster                | Einzelne Consumer-GPU (RTX 4090) |
| Anpassungseffizienz   | Vollständiges Finetuning         | 1,4% LoRA + 4-Bit-Quantisierung  |
| Verfügbarkeit         | Proprietär / Geschlossen         | 100% Open Source (Code & Gewichte|
+-----------------------+----------------------------------+----------------------------------+
6. Verkörperte Sicherheit: Zweistufige Reflexarchitektur
Physische Roboter üben reale Kräfte aus. Produktionssysteme erfordern daher zwingend ein zweistufiges Sicherheitsharness:
[VLA-Aktionsausgabe: 7DoF Delta]
                 │
                 ▼
[Stufe 1: Software-Geschwindigkeits- und Raumkappung]
  ├── Geschwindigkeitsgrenze: ||Δpos|| <= 5 cm pro Schritt
  └── Virtueller Sicherheitskäfig (Bounding Box Geofence)
                 │
                 ▼
[Stufe 2: Hardware-Kraft-Momenten-Reflexschleife (1000 Hz)]
  ├── Falls Kontaktkraft F_kontakt > 20 Newton:
  └── VLA-Befehl sofort übersteuern -> Not-Aus / Nachgiebigkeitsmodus
- Software-Aktionskappung: Überschreitet die Ausgabe des Modells sichere Grenzwerte (z. B. mehr als 5 cm Verschiebung pro Schritt), greift die Motorsteuerung regulierend ein.
- Hardware-Sensorreflexe: Bei 1.000 Hz reagieren Kraftsensoren unmittelbar auf unerwartete Widerstände (Kollision mit Personen) und schalten Antriebe reflexartig stromlos, völlig unabhängig vom High-Level-Modell.
7. Wichtige Erkenntnisse für das KI-Engineering
- Physische Aktionen sind eine Modalität der Sprache: Das Diskretisieren von Motorbewegungen erlaubt die Nutzung von Internet-Wissen für reale Manipulationen.
- Duale Bildfusion ist entscheidend: Die Kombination aus Semantik (SigLIP) und räumlicher Tiefe (DINOv2) sichert Millimeterpräzision.
- Quantil-Binning schließt Genauigkeitslücken: Die Verteilung der Token nach empirischen Bewegungsdaten verhindert Greiffehler.
- Diffusion führt zur stufenlosen Steuerung: Systeme wie $\pi_0$ eliminieren Diskretisierungszittern und eröffnen die Handhabung verformbarer Materialien.
In unserer letzten Vorlesung, Vorlesung 17 (GRAND FINALE): Future Research Directions, ziehen wir das Fazit aus allen 17 Vorlesungen und skizzieren die großen ungelösten Rätsel auf dem Weg zur echten AGI. Wir sehen uns im Finale!