Stanford CS329A (Ep 8): Suche und Deep Research — Programmsuche (AlphaCode) und Wissenssuche mit Search-o1

In der Softwaretechnik und wissenschaftlichen Spitzenforschung bemisst sich echte Expertise niemals an reiner Auswendiglernerei. Selbst der genialste Chefarchitekt schreibt ein hochgradig nebenläufiges, verteiltes System aus mehreren tausend Zeilen Code nicht beim ersten Tastenanschlag fehlerfrei nieder. Selbst ein Nobelpreisträger verfasst bahnbrechende pharmakologische Studien nicht allein aus dem biologischen Gedächtnis, ohne externe Fachliteratur und Patente zu konsultieren.
Die wahre Stärke menschlicher Intelligenz wurzelt in systematischer Exploration:
„Die Fähigkeit, Millionen plausibler Hypothesen breit zu durchsuchen (Search), irrelevante Irrwege konsequent zu verwerfen (Filter), während des Denkprozesses auftretende Wissenslücken aktiv in externen Wissensspeichern zu schließen (Retrieve) und fragmentierte Beobachtungen zu belastbaren Erkenntnissen zu synthetisieren.“
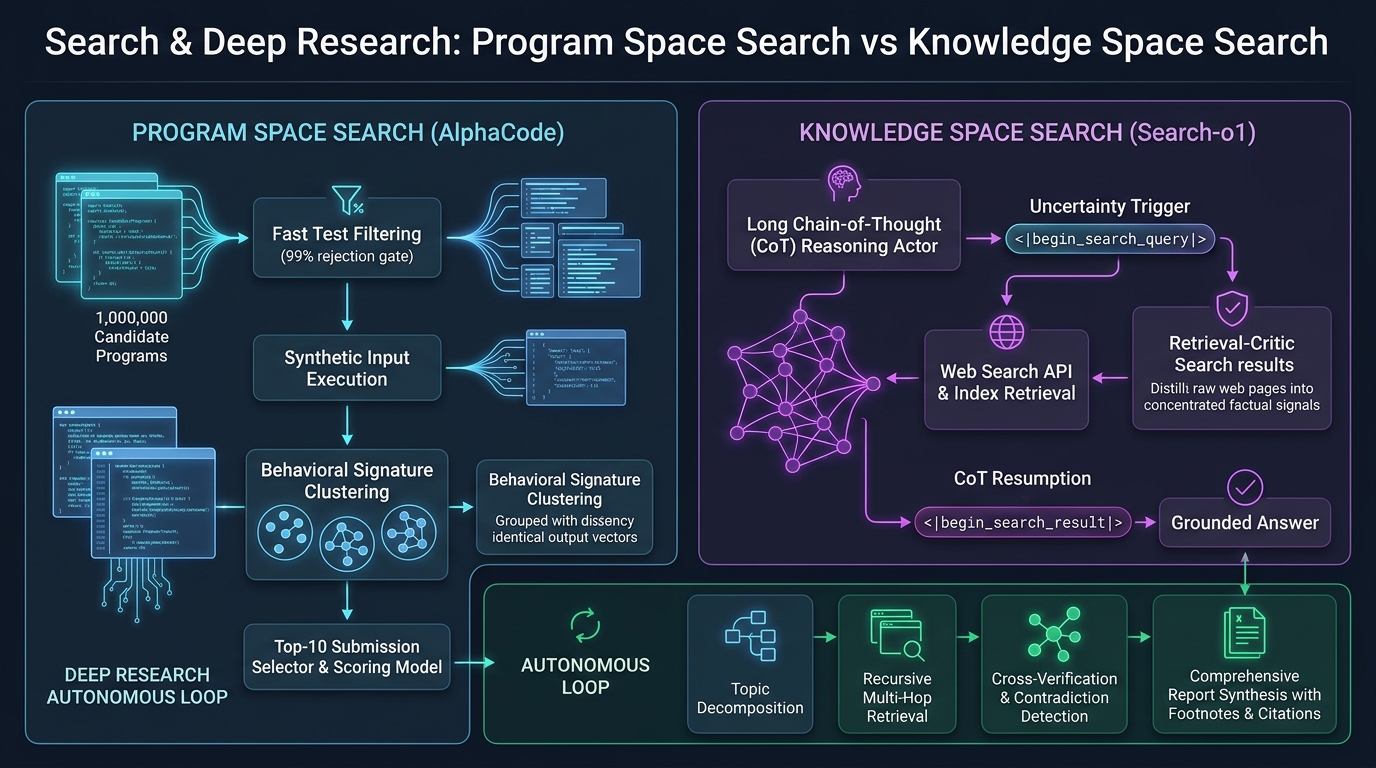
In dieser achten Vorlesung von Stanford CS329A: Self-Improving AI Agents (Selbstverbessernde KI-Agenten) analysieren wir, wie das Konzept der Suche (Search) die kognitiven Fähigkeiten künstlicher Intelligenz über zwei komplementäre Dimensionen hinweg potenziert:
- Suche im Programmraum (Program Space Search): Massive Codegenerierung und Aggregation über Laufzeit-Verhaltenssignaturen in AlphaCode Competitive Programming (AlphaCode Wettbewerbsprogrammierung) von Google DeepMind.
- Suche im Wissensraum (Knowledge Space Search): Nahtlose Verzahnung von logischen Denkketten mit aktiver Informationsbeschaffung durch Search-o1 Autonomous Investigation (Autonome Recherche) und Self-Reflective Search Loops (Selbstreflexive Suchschleifen).
- Autonome Deep-Research-Pipelines (Deep Research Workflows): Die Architektur des Information Synthesis Agent (Informationssynthese-Agenten), der komplexe Aufgabenstellungen zerlegt, das Web rekursiv durchdringt und referenzierte Fachberichte synthetisiert.
1. Die Doppeldimension agentischer Suche (The Dual Nature of Search)
In der klassischen KI beschränkte sich die Suche auf diskrete Zustandsräume (etwa Graphensuche mit A* oder Minimax im Schach). In modernen autonomen Agentenarchitekturen hat sich das Paradigma jedoch auf zwei gewaltige Fronten ausgeweitet: den kontinuierlichen Wahrscheinlichkeitsraum von Token-Sequenzen und das offene weltweite Web:
                          ┌─────────────────────────────────────┐
                          │   Die zwei Dimensionen der Suche    │
                          └──────────────────┬──────────────────┘
                                             │
             ┌───────────────────────────────┴───────────────────────────────┐
             ▼                                                               ▼
┌─────────────────────────────────────────┐     ┌─────────────────────────────────────────┐
│        Suche im Programmraum (Code)     │     │       Suche im Wissensraum (Wissen)     │
├─────────────────────────────────────────┤     ├─────────────────────────────────────────┤
│ • AlphaCode 1 & 2 (Google DeepMind)     │     │ • Search-o1 & Agentic RAG               │
│ • Extrem spärliche Belohnungen (0 / 1)  │     │ • Unendliches offenes Webwissen         │
│ • 1.000.000 parallele Kandidatenprogramme│    │ • Erkennung von Denk-Wissenslücken      │
│ • Laufzeit-Verhaltenssignaturen         │     │ • Reason-in-Documents Faktenextraktion  │
│ • Clusterung funktionaler Invarianten   │     │ • Rekursive Multi-Hop-Recherche         │
└─────────────────────────────────────────┘     └─────────────────────────────────────────┘
Die gemeinsame Kernherausforderung beider Domänen ist der Precision-Recall-Tradeoff unter begrenztem Rechenbudget:
- In der Programmsynthese sichert das Ziehen von Millionen Samples eine extrem hohe theoretische Trefferquote ($pass@k$), doch die offiziellen Wettbewerbsregeln limitieren die Einreichungen auf maximal 10 Versuche ($10@k$).
- In der offenen Recherche schwemmt eine Websuche zehntausende Zeilen unstrukturierten HTML-Code, Werbung und widersprüchliche Behauptungen an, die bei ungefilterter Injektion den Kontext des Modells kontaminieren (Context Pollution).
2. Suche im Programmraum: AlphaCode (Science Titelthema, 2022)
Wettbewerbsplattformen wie Codeforces verlangen selbst von erfahrenen Programmierern Höchstleistungen. Man muss komplexe Aufgabenbeschreibungen mathematisch formalisieren und performanten C++-Code verfassen, der strenge Laufzeit- ($O(N \log N)$) und Speichergrenzen ($256\text 256 MB$) gegenüber verdeckten Testfällen einhält. Ein einziger Indexfehler führt unweigerlich zu Wrong Answer.
Google DeepMinds AlphaCode bewies, dass massive Inferenzrechenleistung in Verbindung mit semantischer Clusterung eine KI unter die besten 54 % menschlicher Programmierer heben kann.
                  [Aufgabenstellung in natürlicher Sprache]
                                      │
                                      ▼
           1. Massive Diversitäts-Stichprobe (1.000.000 C++/Python-Codes)
              (Zufällige Schwierigkeits-Tags, DP/Graphen, Temperatur 0,25)
                                      │
                                      ▼
           2. Erste Filterstufe: Ausführung von Beispieltests (Sample Tests)
              (Prüfung auf Basisfällen -> verwirft >99 % syntaktisch defekten Code)
                                      │
                                      ▼
           3. Synthetische Testeingaben & Verhaltenssignaturen-Clusterung
              (10 zufällige gültige Eingaben -> Gruppierung nach Ausgabevektor)
                                      │
                                      ▼
           4. Extraktion der Top-10-Clusterrepräsentanten
              (Auswahl je 1 Spitzenkandidaten aus den 10 größten Clustern)
                                      │
                                      ▼
                    [10 offizielle Einreichungen im Wettbewerb]
                 (Besser als 54,3 % von über 5.000 menschlichen Experten)
Die Genialität der Clusterung nach Verhaltenssignaturen (Behavior Signatures)
Wie filtert man aus den 5.000 Programmen, die die Basisbeispiele überstanden haben, jene 10 heraus, die sämtliche verdeckten Testfälle bestehen?
Textuelle oder syntaktische Ähnlichkeitsmetriken (wie BLEU oder CodeBERT-Embeddings) scheitern grundlegend:
- Zwei Programme mit 99 % identischem Code können sich in einem einzigen Vergleichsoperator (
<statt<=) unterscheiden, was den einen in eine Endlosschleife stürzt. - Umgekehrt können ein iterativer Ansatz und eine rekursive Implementierung syntaktisch völlig verschieden sein, aber exakt denselben korrekten mathematischen Algorithmus abbilden.
DeepMind wandte das Prinzip an, dass Code anhand seines Verhaltens zur Laufzeit beurteilt werden muss:
- Ein Hilfsmodell synthetisiert 10 gültige Zufallseingaben für das Problem.
- Alle 5.000 überlebenden Programme führen diese 10 Eingaben in einer isolierten Sandbox aus.
- Jedes Programm erhält einen Ausgabevektor als Verhaltenssignatur:
Signature(P_i) = [ P_i(input_1), P_i(input_2), ..., P_i(input_10) ]
- Das fundamentale Invarianten-Gesetz: Fehlerhafte Programme scheitern auf unterschiedliche Weise und streuen in isolierte Kleinstgruppen; alle Programme mit der korrekten mathematischen Logik liefern für identische Eingaben exakt dieselben Ausgaben und bilden das mit Abstand größte dominante Cluster!
- AlphaCode wählt aus den 10 größten Clustern je einen Repräsentanten für die offizielle Einreichung.
AlphaCode 2: 10.000-fache Sampling-Effizienz dank Gemini
Ende 2023 stellte DeepMind AlphaCode 2 auf Basis von Gemini Pro vor:
- Einführung eines dedizierten Scoring-Modells, das die Programme innerhalb der Cluster nach algorithmischer Eleganz und Komplexität bewertet.
- Steigerung der Lösungsrate von 25 % auf 43 %, was dem 85. Perzentil (Candidate Master) entspricht.
- Spektakuläres Ergebnis: AlphaCode 2 übertraf die Leistung von AlphaCode 1 mit nur 100 Samples gegenüber 1.000.000 Samples. Diese 10.000-fache Steigerung der Sampling-Effizienz belegt eindrucksvoll, dass stärkere Basismodelle den erforderlichen Suchraum dramatisch verkleinern.
3. Suche im Wissensraum: Search-o1 (2025)
Wendet man sich vom Code dem Bereich natürlicher Sprache und wissenschaftlicher Fakten zu, zeigt sich bei langen Denkketten (Long CoT, z. B. bei o1 oder DeepSeek-R1) ein auffälliges Muster: Bei komplexen Problemen äußern Modelle im Schnitt 30,4-mal pro Antwort Unsicherheitsmarkierungen („vielleicht“, „Moment“, „vermutlich“). Statisches RAG sucht nur einmal vorab und versagt, wenn während eines 10-stufigen Beweises unerwartete Faktenlücken auftreten.
Search-o1 revolutionierte diesen Ablauf durch dynamische, selbstreflexive Informationsabfrage:
sequenceDiagram
    autonumber
    participant LLM as Reasoning-Actor (QwQ-32B)
    participant Engine as Such-Controller
    participant Web as Web-Such-API (Bing / Google)
    participant Critic as Retrieval-Critic (Reason-in-Docs)

    LLM->>LLM: Generiert lange Denkkette (Long CoT)...
    Note over LLM: Wissenslücke: "Wie lautet die genaue Sequenz des CXCR4-Rezeptors?"
    LLM->>Engine: Sendet Tag: <|begin_search_query|> human CXCR4 sequence <|end_search_query|>
    Note over LLM: Denkkette pausiert (Zustand im KV-Cache gesichert)
    Engine->>Web: Startet Echtzeit-Websuche
    Web-->>Engine: Liefert 10 Roh-HTML-Dokumente (50.000 Tokens)
    Engine->>Critic: Übergibt HTML + aktuellen Denkschritt
    Critic->>Critic: Filtert Rauschen, destilliert Kernfakt (Reason-in-Docs)
    Critic-->>Engine: "CXCR4 ist ein 352-AS-GPCR; Rest 28 bindet den Liganden."
    Engine->>LLM: Injiziert Fakt: <|begin_search_result|> Fakt-Extrakt <|end_search_result|>
    Note over LLM: Denkkette wird fortgesetzt
    LLM->>LLM: Vollendet biochemische Herleitung auf verifizierter Basis
Die zwei Säulen von Search-o1
- Reasoning-Actor (Denkender Akteur): Sobald das Modell während der Deduktion interne Wissensunsicherheit registriert, stoppt es die Generierung autonom über Steuer-Tags (
<|begin_search_query|>) und friert seinen KV-Cache ein. - Retrieval-Critic („Reason-in-Documents“): Verhindert, dass rohe Webseiten mit 50.000 Tokens die Aufmerksamkeit des Modells zerstreuen (Context Distraction). Ein separates Kritik-Modell liest die Dokumente vorab und extrahiert exakt die 2–3 Zeilen relevanter Fakten, die für den aktuellen Schritt benötigt werden.
Ergebnisse auf GPQA Diamond (Wissenschaftliche Prüfungen auf PhD-Niveau):
========================================================================================
Architektur                  Gesamtgenauigkeit Chemie          Biologie        Physik
----------------------------------------------------------------------------------------
Menschliche Fachexperten (PhD)  65,4 %          48,9 %          37,2 %          39,9 %
Basis-Denkmodell (QwQ-32B)      58,1 %          45,2 %          41,5 %          43,2 %
Klassischer statischer RAG-Agent 61,6 %          51,0 %          44,8 %          47,0 %
Search-o1 (Dynamische CoT-Suche) 63,6 % (+5,5p)  56,4 % (+7,5p)  50,2 % (+13,0p) 52,8 % (+12,9p)
========================================================================================
Search-o1 übertraf auf GPQA Diamond nicht nur statische RAG-Systeme deutlich, sondern schlug den Durchschnitt menschlicher promovierter Naturwissenschaftler in Chemie, Biologie und Physik.
4. Autonome Deep-Research-Pipelines
Verbindet man die Cluster-Filterung von AlphaCode mit den aktiven Suchzyklen von Search-o1, entsteht die Blaupause moderner Deep Research Agent LLMs:
                       [Komplexe Forschungsaufgabe des Nutzers]
                                         │
                                         ▼
                   ┌──────────────────────────────────────┐
                   │    Hierarchische Aufgabenzerlegung   │
                   │ (Aufteilung in 5–8 Teilhypothesen)   │
                   └──────────────────┬───────────────────┘
                                      │
          ┌───────────────────────────┼───────────────────────────┐
          ▼                           ▼                           ▼
┌──────────────────┐        ┌──────────────────┐        ┌──────────────────┐
│  Teilhypothese A │        │  Teilhypothese B │        │  Teilhypothese C │
│  Multi-Hop-Suche │        │  Multi-Hop-Suche │        │  Multi-Hop-Suche │
└─────────┬────────┘        └─────────┬────────┘        └─────────┬────────┘
          │                           │                           │
          └───────────────────────────┼───────────────────────────┘
                                      │
                                      ▼
                   ┌──────────────────────────────────────┐
                   │  Widerspruchs- und Quellenkritik     │
                   │ (Erkennung kollidierender Aussagen)  │
                   └──────────────────┬───────────────────┘
                                      │
                                      ▼
                   ┌──────────────────────────────────────┐
                   │  Evidenzbasierter Abschlussbericht   │
                   │(15 Seiten mit exakten Quellen-Links) │
                   └──────────────────────────────────────┘
Vier Phasen autonomer Tiefenrecherche
- Hypothesen-Dekomposition: Zerlegt komplexe Aufgaben in präzise verifizierbare technische Teilfragen.
- Rekursive Multi-Hop-Exploration: Folgt Zitations- und Quellverweisen aus Primärdokumenten zu Patenten und Rohdaten.
- Widerspruchsauflösung: Identifiziert Diskrepanzen zwischen Marketingmitteilungen und unabhängigen Messungen.
- Rückverfolgbare Quellenattribution: Hinterlegt für jede Zahl und Behauptung direkte Web-Links und eliminiert Halluzinationen.
5. Vergleich der Suchparadigmen
=========================================================================================================
Dimension             Klassisches statisches RAG     AlphaCode (Programmraum)  Search-o1 (Wissensraum)
---------------------------------------------------------------------------------------------------------
Suchraum              Statische Vektordatenbank      Diskreter Code-Tokenraum   Offenes Web und Live-APIs
Trigger-Mechanismus   Einmalig bei Nutzereingabe     Massivsampling bei Inferenz Selbstreflexive Lückenerkennung
Filter-Kriterium      Top-K Kosinus-Ähnlichkeit      Laufzeit-Verhaltenssignatur Reason-in-Docs Faktendestillation
Validierungsanker     Distanz im Embedding-Raum      Reale Sandbox-Ausgabe      Formale Logik & Quellencheck
Hauptschwachpunkt     Kontextdrift bei Mehrstufigkeit Enormer Rechenaufwand     Latenz bei Webabfragen
=========================================================================================================
6. Vertiefende technische Fragen & Antworten
F1: Warum ist die Clusterung nach Verhaltenssignaturen der textuellen Code-Analyse überlegen?
Die formale Korrektheit von Algorithmen lässt sich nicht an Syntaxbäumen ablesen. Zwei Programme mit zu 99 % identischem AST können durch eine winzige Abweichung bei Schleifengrenzen fehlschlagen. Umgekehrt können iterative und rekursive Architekturen völlig verschieden aufgebaut sein, aber identische korrekte Ergebnisse liefern. Erst die Messung des Ausgabevektors bei realer Ausführung bündelt alle korrekten Ansätze in einem dominanten Cluster.
F2: Warum filtert „Reason-in-Documents“ Webdokumente, statt sie direkt einzubinden?
Dies verhindert Aufmerksamkeitszerstreuung (Attention Distraction). Lange Denkketten erfordern höchste semantische Fokussierung. Werden zehntausende Tokens ungefilterter Webseiten (Menüs, Werbung, Fülltext) injiziert, verwässert das die Aufmerksamkeit des Modells und zerstört den logischen Faden. Ein dediziertes Kritik-Modell destilliert die Dokumente vorab auf die reinen, relevanten Faktenzeilen.
Zusammenfassung und Ausblick
Suche transformiert Sprachmodelle von statischen Textgeneratoren zu dynamischen Entdeckern. AlphaCode hat gezeigt, wie man durch Exploration im Programmraum Wettbewerbsprogrammierung bezwingt; Search-o1 und Deep Research beweisen, dass die Integration aktiver Wissenssuche naturwissenschaftliche Prüfungen auf Forscherniveau meistert.
In der kommenden Lektion 9 schließen wir Teil 2 (Training & Evolution) mit einer großen Synthese ab: Post-Training Evolution — Vom Sprachmodell zur autonomen Agentenflotte (SFT, RLHF, Tool Grounding).
Kernpunkte
- Rechenzeit-optimierte Suche: Breit gefächertes Sampling mit strengen Filtern (AlphaCode) übertrifft ungeführte Einzelgenerierung deutlich.
- Verhalten schlägt Syntax: Die Natur von Programmen offenbart sich in ihren Ausgaben; nur Verhaltenssignaturen identifizieren verlässlich den korrekten Code.
- Aktive Suche im Denkprozess: Das Erkennen von Wissenslücken während der Inferenz (Search-o1) setzt neue Maßstäbe für wissensintensive Aufgaben.