[Stanford CS329A #5] Mehrschritt-Planung und Baumsuche: ADaPT, LATS, SPRINT und MCTS für Sprachagenten

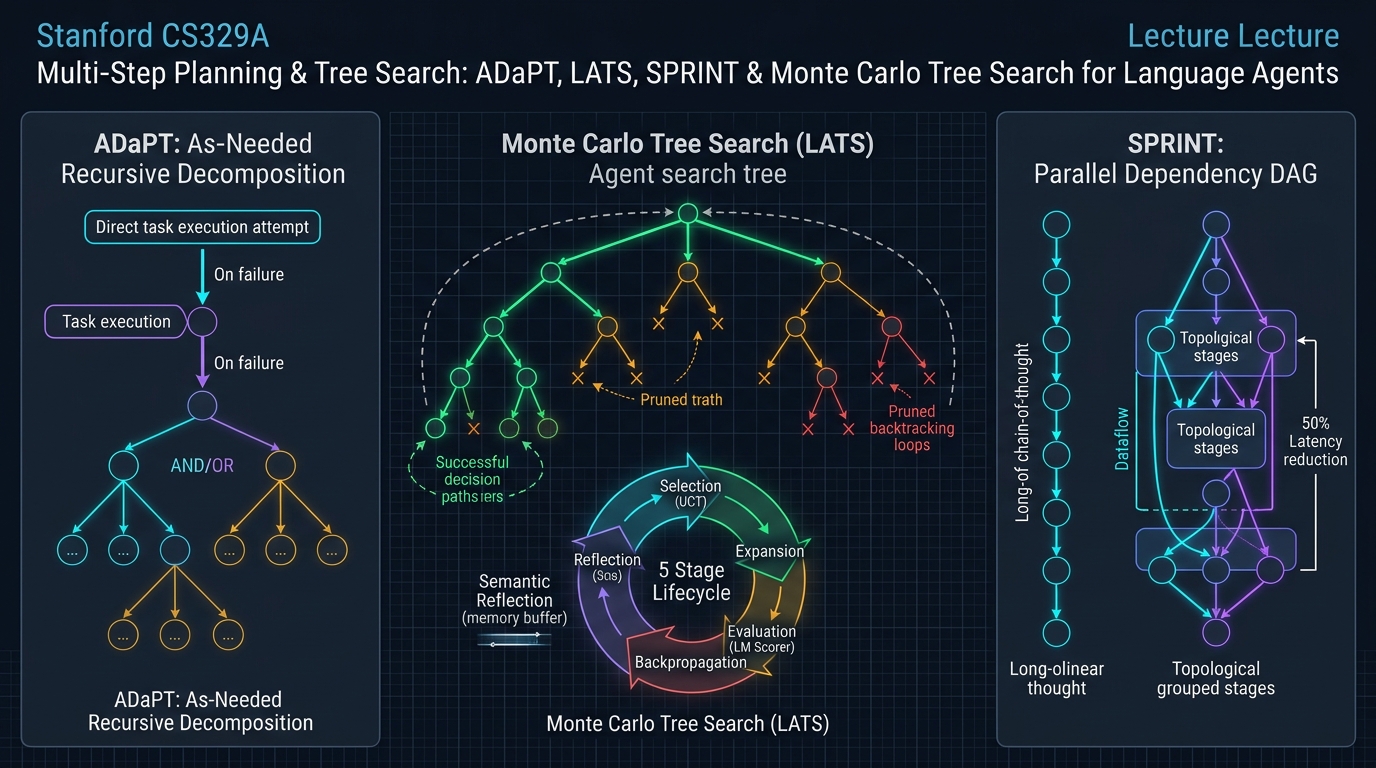
Willkommen zur fünften Ausgabe unserer technischen Analyse der Graduierten-Vorlesung der Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025).
In Vorlesung 4 haben wir untersucht, wie autonome Agenten ihre geschlossenen Räume verlassen, externe Tools ansteuern und Compiler-Feedbackschleifen zur Fehlerbehebung nutzen (ReAct, RLEF). Dennoch unterscheidet sich das Beheben lokaler Syntaxfehler grundlegend vom architektonischen Entwurf komplexer Softwaresysteme mit über 100.000 Zeilen Code oder der Bewältigung wissenschaftlicher Langzeithorizonte.
Standardansätze wie ReAct oder Chain-of-Thought (CoT) sind im Kern gierige Einweg-Sucher (Greedy Single-Path): Sie bewerten ausschließlich den nächsten Schritt und marschieren unumkehrbar vorwärts. Wie ein Schachamateur, der nur den nächsten Zug berechnet und drei Züge später schachmatt gesetzt wird, gerät ein gieriges Sprachmodell bei fehlerhaften Zwischenentscheidungen unweigerlich in eine irreversible Sackgasse.
Die heutige Vorlesung 5 bildet das monumentale Finale von Part 1 (Foundation · Fundamentale Grundlagen) des Stanford-Lehrplans: Mehrschritt-Planung (Multi-Step Planning) und Baumsuche (Tree Search).
Indem wir den mathematischen Kern von AlphaGo – die Monte-Carlo-Baumsuche (MCTS) – in autoregressive Sprachmodelle verpflanzen, verwandeln wir reaktive Textgeneratoren in strategische Großmeister. Wir analysieren Systeme, die Konsequenzen Dutzende Schritte im Voraus antizipieren, Sackgassen dynamisch beschneiden, auf frühere Entscheidungszustände zurücksetzen (Backtracking) und parallele Denkprozesse orchestrieren:
- Synthese von Denken, Handeln und Planen: Language Agent Tree Search (LATS, Zhou et al., 2023).
- Bedarfsgesteuerte rekursive Zerlegung: Modulare Aufteilung erst bei Scheitern über ADaPT (Allen AI, 2023).
- Paralleles Abhängigkeits-DAG-Packing: Halbierung der Inferenzlatenz um 53,5 % via SPRINT (Stanford Future Data, 2025).
- Adaptive Verzweigung via Thompson-Sampling: Lösung des Dilemmas zwischen Breite und Tiefe mit AB-MCTS (Sakana AI, 2025).
- Verankerung der Planungsintelligenz in neuronalen Gewichten: SWiRL (Step-Wise RL, 2025).
flowchart TD
    subgraph MCTS_Loop ["LATS MCTS-Lebenszyklus für Sprachagenten"]
        direction TB
        Root["Wurzelknoten: Benutzeraufgabe / Spezifikation"]
        --> Select["1. Selektion: UCT-basierte Traversierung optimaler Pfade"]
        --> Expand["2. Expansion: Sampling von n Kandidatenaktionen"]
        --> Eval["3. Evaluation: LM-Score + Self-Consistency Ensemble"]
        --> Backprop["4. Backpropagation: Rückwärtspropagierung skalarer Werte"]
        --> Reflect["5. Semantische Reflexion: Textuelles Fehler-Postmortem"]
    end

    subgraph PlanningParadigms ["Spektrum fortschrittlicher Agentenplanung"]
        direction TB
        P1["LATS (MCTS-Baumsuche)<br/>• Ausnutzung der Prompt-Historie für Backtracking ohne Mehraufwand<br/>• HumanEval: 92,7 % Pass@1; HotpotQA: Sprung von 32 % auf 71 %"]
        --> P2["ADaPT (Bedarfsgesteuerte Zerlegung)<br/>• Keine starren Vorabpläne; direkter Single-Shot-Versuch zuerst<br/>• Rekursive AND/OR-Unteraufgaben nur bei gemeldetem Fehlschlag"]
        --> P3["SPRINT (Paralleles DAG-Packing)<br/>• Graphentheoretische Erkennung unabhängiger Denkschritte<br/>• GPU-Cluster-Parallelisierung; Latenzreduktion um 53,5 %"]
        --> P4["SWiRL (Schrittweises Reinforcement Learning)<br/>• Destillation der MCTS-Suchweisheit direkt in die Modellgewichte<br/>• Strategische Weitsicht in einem einzigen Vorwärtspass"]
    end

    MCTS_Loop ==> PlanningParadigms