Zum Hauptinhalt springen

2 Posts getaggt mit "ai-architecture"

Alle Tags anzeigen

[Stanford CS329A #2] Test-Time Compute Scaling: Jenseits klassischer Skalierungsgesetze zur rechenoptimalen Inferenz

· 11 Minuten Lesezeit
Jaybee
AI & Robotics Engineer

Stanford CS329A Test-Time Compute Scaling

Willkommen zum zweiten Teil unserer fundierten ingenieurwissenschaftlichen Analyse des Hauptstudiums-Kurses der Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025).

In der Einführungsvorlesung haben wir den makroökonomischen Paradigmenwechsel von statischen autoregressiven Next-Token-Prädiktoren hin zu autonomen Agentenschleifen mit Umgebungs-Feedback nachgezeichnet. Heute widmen wir uns dem rechnerischen Fundament dieser Autonomie: Test-Time Compute Scaling (Skalierung der Rechenzeit während der Inferenz).

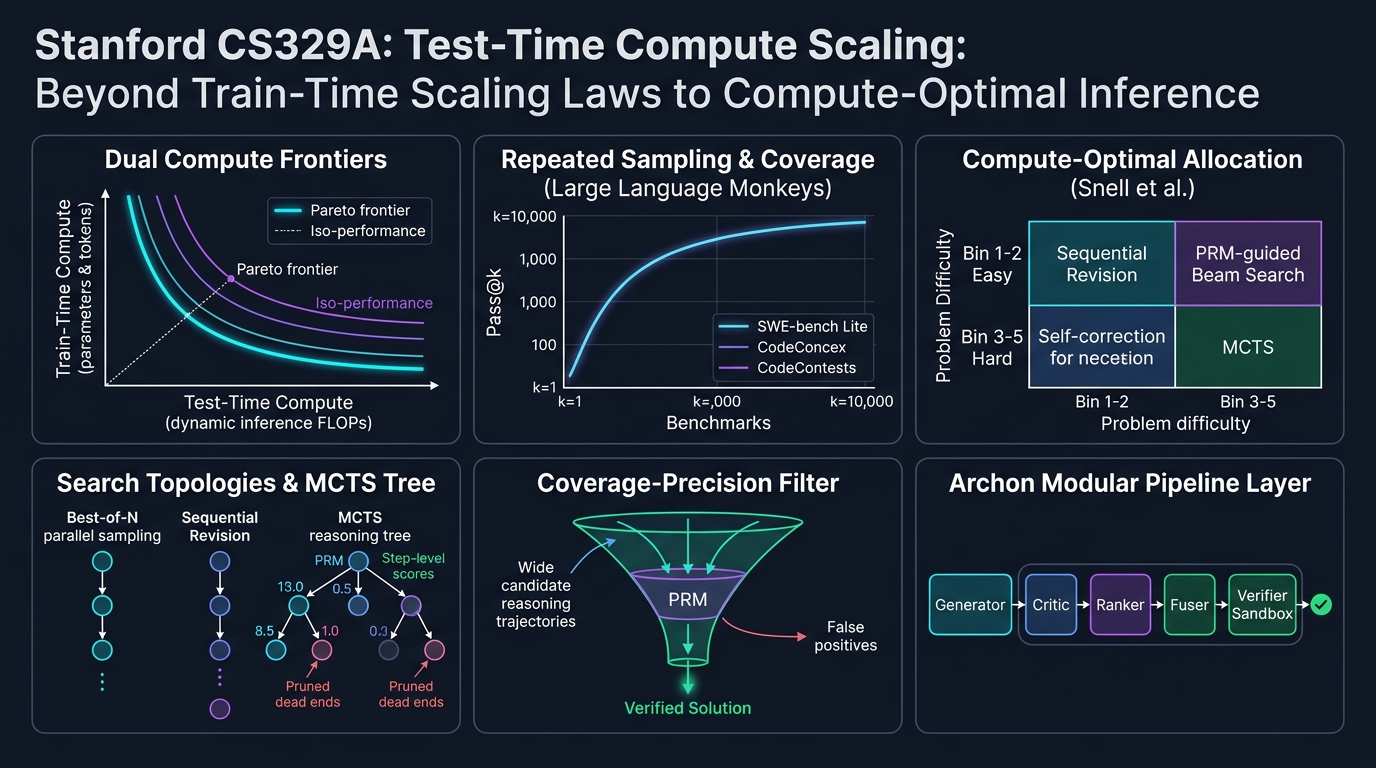
Über ein halbes Jahrzehnt lang wurde die KI-Forschung von den Skalierungsgesetzen des Pre-Trainings beherrscht (Kaplan et al., Chinchilla): massive GPU-Cluster aufbauen, die Modellparameter N in die Hunderte Milliarden treiben und zig Billionen Web-Tokens D verarbeiten. Doch was geschieht, wenn wir uns nach dem Einfrieren der Modellgewichte θ weigern, eine hastige Greedy-Antwort innerhalb von 50 Millisekunden zu akzeptieren? Was passiert, wenn ein Agent stattdessen 10 Sekunden, 1 Minute oder 10 Minuten investiert, um Argumentationsbäume zu explorieren, Zwischenschritte zu verifizieren und Hypothesen zu revidieren?

Anhand der bahnbrechenden empirischen Resultate von Large Language Monkeys (Brown et al., 2024), Snell et al.s Compute-Optimal Scaling (Stanford/UC Berkeley, 2024) und des modularen Archon-Architektur-Frameworks formalisieren wir mathematisch und systemtechnisch, wie der Austausch von Inferenz-FLOPs gegen Parameterkapazität die moderne KI revolutioniert.

flowchart TD
subgraph PreTrain ["Klassische Grenze: Skalierung der Trainingsrechenzeit"]
direction TB
P1["Billionen Web-Tokens (D)"] --> P2["Massive GPU-Cluster (C_train)"]
P2 --> P3["Eingefrorenes dichtes Modell (θ)"]
P3 --> P4["Einmaliger Forward-Pass (O(1) fixe Inferenz)"]
end

subgraph TestTime ["CS329A-Grenze: Skalierung der Test-Time-Rechenzeit"]
direction TB
T1["Eingefrorene Basisgewichte (θ)"] --> T2["Dynamische FLOP-Allokation während der Inferenz"]
T2 --> T3{"Adaptive Strategiewahl nach Schwierigkeit"}
T3 -- "Geringe Schwierigkeit (Bin 1-2)" --> T4["Sequenzielle Revision (Selbstkorrektur)"]
T3 -- "Hohe Schwierigkeit (Bin 3-5)" --> T5["PRM-geführte Baumsuche (MCTS / Beam Search)"]
T4 --> T6["Process Reward Model (PRM) Verifizierer"]
T5 --> T6
T6 --> T7["Mathematisch & mechanisch verifizierte Lösung"]
end

PreTrain -.->|"Wendepunkt: Parametersättigung"| TestTime
[Stanford CS329A #1] Kursübersicht: Von großen Sprachmodellen zu selbstverbessernden KI-Agenten

· 10 Minuten Lesezeit
Jaybee
AI & Robotics Engineer

Stanford CS329A Selbstverbessernde KI-Agenten

Willkommen zur detaillierten technischen Aufschlüsselung des Kurses CS329A der Stanford University: Self-Improving AI Agents (Selbstverbessernde KI-Agenten, Herbst 2025).

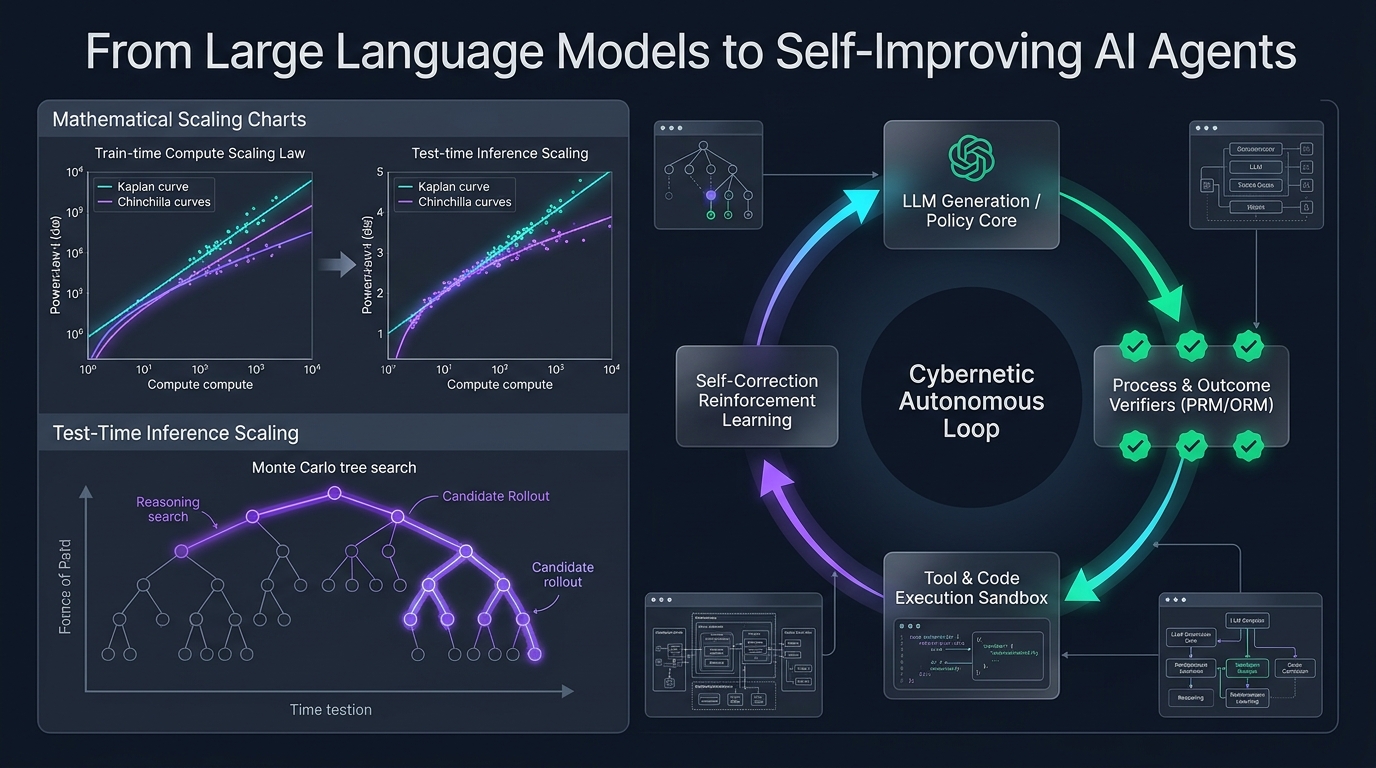
In den vergangenen vier Jahren wurde die Landschaft der künstlichen Intelligenz von einem einzigen Dogma beherrscht: Das Vortraining größerer Modelle auf immer gigantischeren Textkorpora führt zu kontinuierlich wachsenden kognitiven Fähigkeiten. Während dieses Paradigma die moderne generative KI-Revolution entfachte – und Modelle wie GPT-4, Claude 3.5 und Gemini hervorbrachte –, hat die vorderste Front der Machine-Learning-Forschung einen entscheidenden Wendepunkt erreicht.

Statische Basismodelle (Static Foundation Models) weisen, ungeachtet astronomischer Parameterzahlen, fundamentale Grenzen auf: Sie sind passive, autoregressive Prädiktoren des nächsten Tokens, die in einem rückkopplungslosen Regime (Open-loop) agieren. Sobald ihre Gewichte nach dem Training eingefroren (frozen) sind, können sie schwierigen Problemen nicht dynamisch mehr Rechenleistung zuweisen, die sachliche Richtigkeit ihrer eigenen Ableitungen nicht autonom verifizieren und Fehler nicht auf Basis von Umgebungsrückmeldungen iterativ korrigieren.

flowchart LR
subgraph Statisches_Paradigma ["Statisches Paradigma (2020-2024)"]
direction TB
A1[Massiver Webkorpus] --> B1[Großskalierter Pre-Training-Cluster]
B1 --> C1[Überwachtes Feintuning SFT]
C1 --> D1[Eingefrorenes Statisches Modell]
D1 -->|Einzelner Vorwärtsdurchlauf| E1[Einmalige Textantwort]
end

subgraph Autonomes_Paradigma ["Stanford CS329A: Selbstverbessernde Agenten"]
direction TB
A2[Komplexes Aufgabenziel] ==> B2[Schlussfolgerungs- und Planungs-Engine]
B2 -->|Aktionen / Code-Entwürfe| C2[Sandbox-Umgebung und Werkzeuge]
C2 -->|Ausführungsspuren und Status| D2[Prozess-Verifizierer PRM]
D2 -->|Belohnungs- und Fehlersignale| B2
D2 ==>|Inferenz- und Trainings-Updates| E2[Kontinuierliche Selbstevolution]
end

Stanford CS329A widmet sich der Kernfrage des kommenden KI-Jahrzehnts: Wie konstruieren wir Software-Agenten, die nicht bloß Text generieren, sondern ihr eigenes Denken und ihren Code kontinuierlich überprüfen, verifizieren, planen und eigenständig verbessern?

In dieser Einführungsvorlesung analysieren wir die evolutionäre Flugbahn von Basis-LLMs zu Agentensystemen, formalisieren die Mathematik der Skalierungsgesetze und der Inferenzzeit-Rechenallokation, untersuchen die vier kanonischen Agenten-Workflow-Muster und isolieren den kritischen Flaschenhals autonomer Intelligenz: die Generator-Verifizierer-Lücke (Generator-Verifier Gap).