[Stanford CS329A #6] Trainingszeit-Skalierung und RL: DeepSeekMath, GRPO und großskalige Denkoptimierung

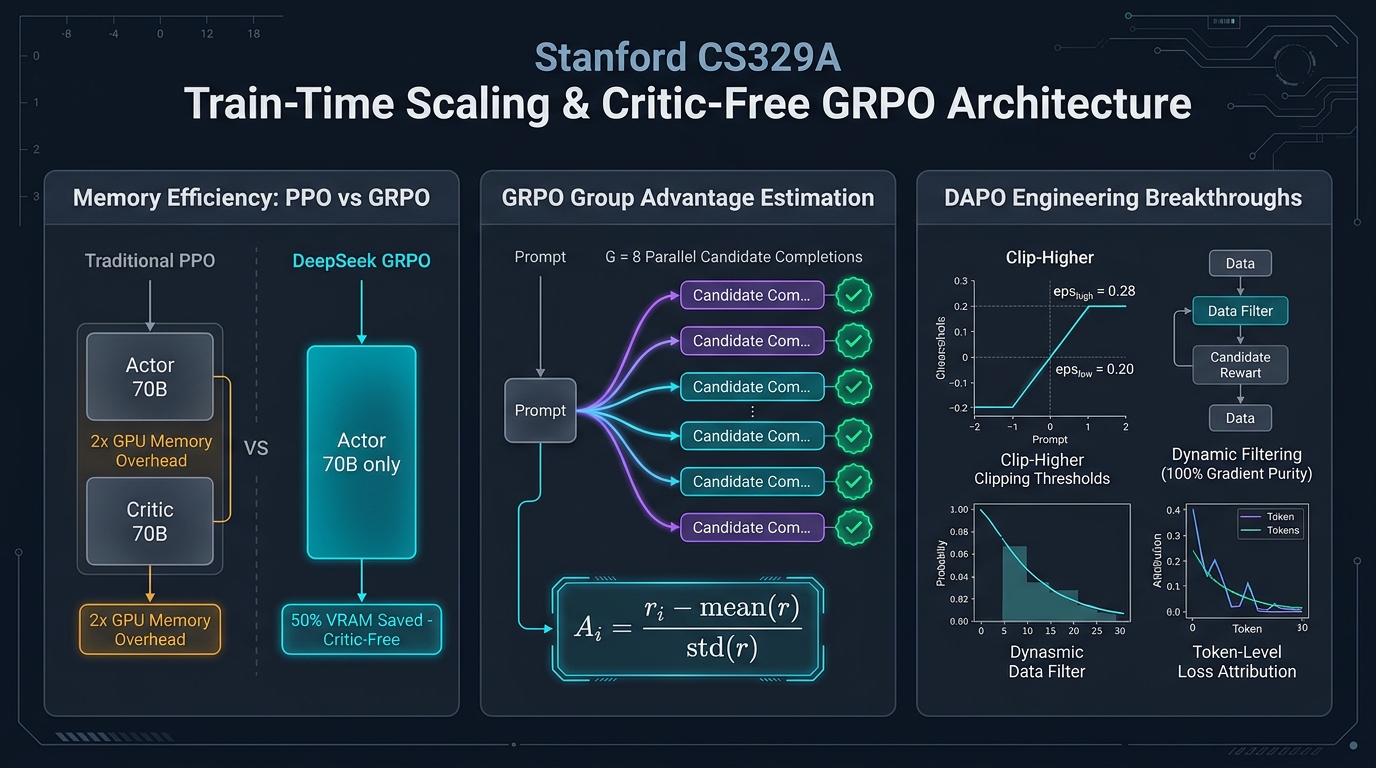
Willkommen zur sechsten Ausgabe unserer technischen Analyse der Graduierten-Vorlesung der Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025).
In den Vorlesungen 1 bis 5 (Part 1: Grundlagen) haben wir untersucht, wie autonome Agenten die Leistungsfähigkeit eingefrorener Sprachmodelle maximieren, indem sie Inferenz-Rechenzeit (Test-Time Compute) allozieren: durch MCTS-Suchbäume, Compiler-Fehleranalysen und Verifikator-Ensembles.
Dennoch müssen wir eine fundamentale mathematische Grenze anerkennen: Erhält ein Grundschüler bei einer Klausur zehn Minuten zusätzliche Bedenkzeit, wird er dennoch keinen Beweis der Infinitesimalrechnung erbringen. Wenn ein Sprachmodell in seinen eingefrorenen synaptischen Gewichten ($\theta$) die zugrundeliegenden mathematischen Konzepte nicht repräsentiert, führt auch das Generieren von 10.000 Rollouts oder Beam-Search nicht zu wahrer Intelligenz, sondern zu statistischem Zufall.
Mit dem heutigen Tag eröffnen wir Part 2: Training & Evolution (Vorlesungen 6 bis 9) und wenden uns der entscheidenden Frage zu:
„Wie können wir, statt bei jeder Inferenz kostspielige Suchbäume zu durchlaufen, massive Rechenleistung während des Trainings investieren, um die Gewichte des Modells permanent in einen Spitzen-Denker zu transformieren?“
In Vorlesung 6 analysieren wir die drei Säulen des Post-Training Reinforcement Learnings (RL), die den Engpass menschlicher Annotationen überwunden und moderne Denkmodelle hervorgebracht haben:
- Autonomes Reasoning-Bootstrapping: Self-Taught Reasoner (STaR, Zelikman et al., Stanford 2022).
- Das Ende des Critic-Modells: Group Relative Policy Optimization (GRPO, DeepSeekMath 2024).
- Skalierung auf 1.000 GPUs: Entkoppeltes Clipping und dynamisches Sampling (DAPO, 2025).
flowchart TD
    subgraph ParadigmShift ["Paradigmenwechsel: Inferenzzeit vs. Trainingszeit"]
        direction TB
        TestTime["Part 1: Inferenzzeit-Skalierung (Test-Time Scaling)<br/>• Eingefrorene synaptische Gewichte (θ = konstant)<br/>• Externe Laufzeitsuche (MCTS, ReAct, RLEF)<br/>• Hohe Antwortlatenz und teure Servicing-Kosten"]
        --> TrainTime["Part 2: Trainingszeit-Skalierung (Train-Time RL)<br/>• Aktive Gradientenoptimierung der Gewichte (θ ← θ + Δθ)<br/>• Verankerung strategischer Planungsinstinkte im Netz<br/>• Ultraschnelle Inferenz im Einzeldurchlauf (Single-Pass)"]
    end

    subgraph RLEvolution ["Die Evolution des mathematischen Reinforcement Learnings"]
        direction TB
        M1["STaR (Stanford 2022)<br/>• Modell lernt aus den eigenen korrekten Deduktionspfaden<br/>• Rationalisierung: Rückwärtsgerichtete Hint-Integration<br/>• 6B-Modell schlägt 175B GPT-3 auf CommonsenseQA"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• Vollständige Eliminierung des Critic-Modells (50 % VRAM-Ersparnis)<br/>• Relative Z-Score-Advantage-Berechnung über G Ausgaben<br/>• 7B-Open-Weights übertrifft Google Minerva 540B auf MATH"]
        --> M3["DAPO (Industrielles Open-Source 2025)<br/>• Asymmetrisches Clip-Higher verhindert Entropiekollaps<br/>• Dynamisches Sampling filtert Null-Varianz-Batches aus<br/>• Qwen-32B bricht Rekorde auf AIME in halber Trainingszeit"]
    end

    ParadigmShift ==> RLEvolution