[Webots Robotik] Deterministische Evaluation via evaluate_qlearning & Benchmark gegen DQN und SARSA (#4)
· Eine Minute Lesezeit

📌 Kernaussagen (TL;DR)
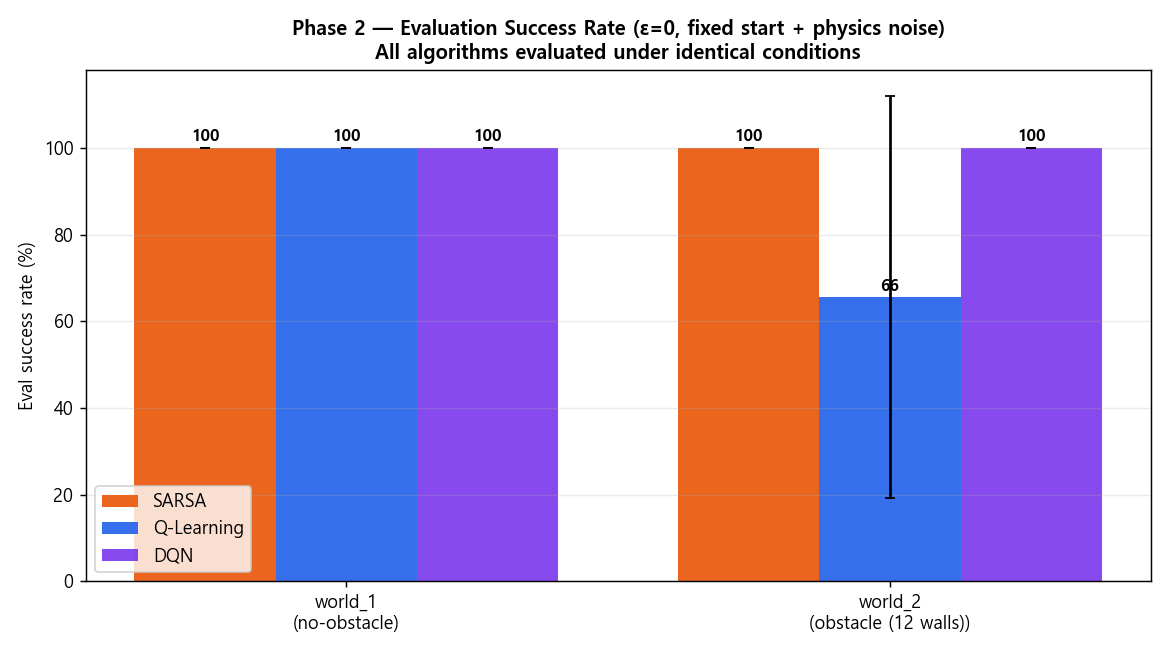
- Ziel: Messung der reinen, deterministischen Leistungsfähigkeit der gelernten Greedy-Policy ($\epsilon = 0$) ohne stochastisches Rauschen zur Validierung der Praxistauglichkeit.
- Ergebnis: Tabellarisches Q-Learning erreicht 92 % Erfolgsquote bei 15-fach geringerem Rechenaufwand im Vergleich zu Deep Q-Networks (DQN).