[Stanford CS329A #4] Tool-Nutzung und Code-Ausführungsfeedback: ReAct, RLEF und konstitutionelle Selbstkorrektur

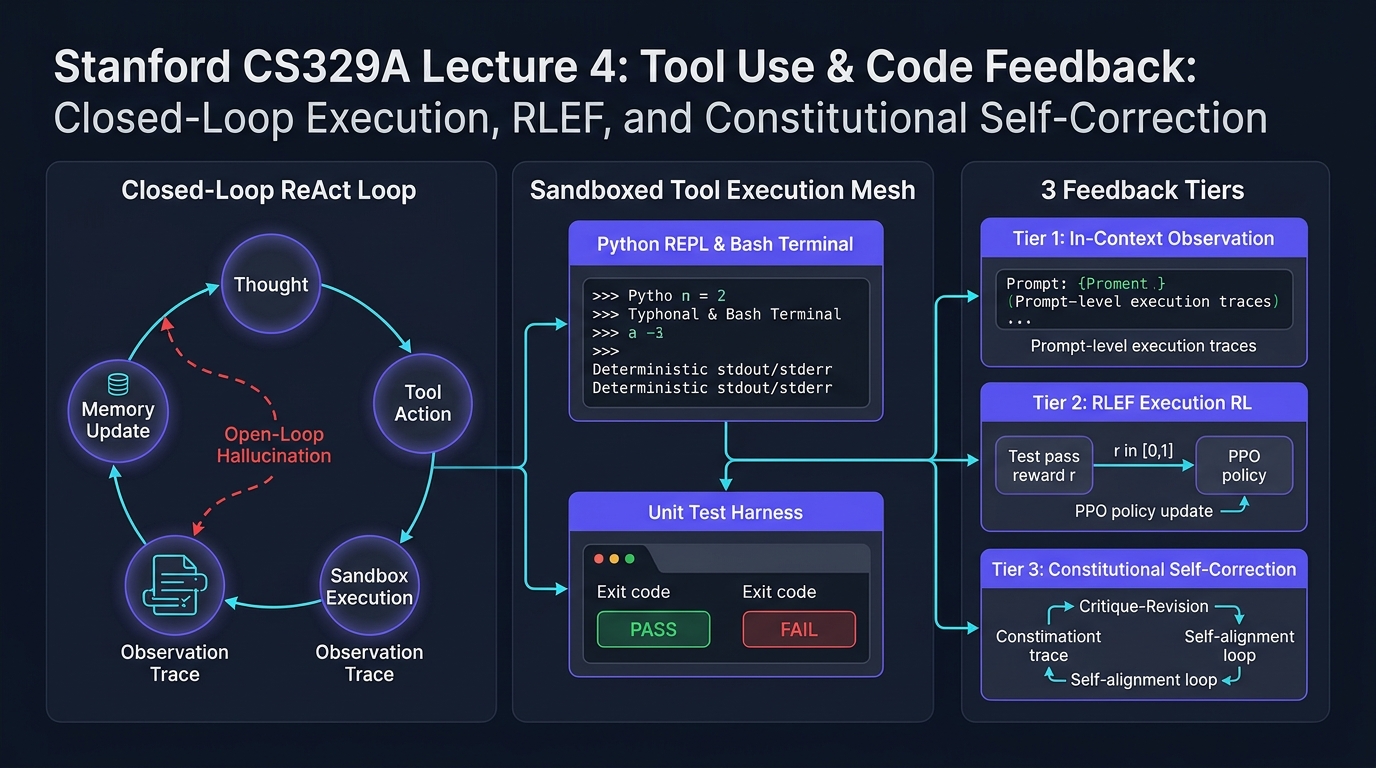
Willkommen zur vierten Ausgabe unserer technischen Analyse der bahnbrechenden Graduierten-Vorlesung der Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025).
In den Vorlesungen 2 und 3 haben wir untersucht, wie Test-Time Compute Scaling und Process Reward Models (PRMs) es Sprachmodellen ermöglichen, Argumentationsbäume systematisch zu explorieren und Zwischenschritte formal zu verifizieren. Dennoch bleibt ein fundamentales Dilemma bestehen: Reine Sprachmodelle, die ausschließlich auf Textgenerierung beschränkt sind, agieren wie „Schüler, die isoliert in einem geschlossenen Raum Prüfungen ablegen“. Sie sind vollständig auf das statische, eingefrorene parametrische Gedächtnis (Parametric Memory) angewiesen, das während des Pre-Trainings erworben wurde. Konfrontiert mit dynamischen Fakten der Außenwelt, veränderlichen Web-APIs oder strengen Syntaxregeln ausführbaren Codes halluziniert ein isoliertes Modell unweigerlich.
Die heutige Vorlesung 4 markiert den entscheidenden architektonischen Übergang vom passiven Sprachmodell zum geschlossenen, aktiven Agenten: Werkzeugnutzung (Tool Use) und Ausführungs-Feedbackschleifen (Feedback Loops).
Moderne autonome Agenten behandeln Code oder API-Aufrufe nicht als bloßen Ausgabetext, sondern als interaktive Sensoren und Aktuatoren. In dieser Lektion analysieren wir die drei fundamentalen Ebenen agentischen Feedbacks:
- Prompt-basiertes Umgebungs-Feedback: Die Verknüpfung von Reflexion und Aktion über ReAct (Yao et al., 2022).
- Policy-basiertes Ausführungs-Feedback: Die direkte Verankerung von Compiler- und Testdiagnosen in den Modellgewichten über RLEF (Reinforcement Learning from Execution Feedback, 2024).
- Selbstüberwachtes Werte-Alignment: Die Ablösung kostspieliger menschlicher Evaluatoren durch prinzipienbasierte Kritik- und Revisionsschleifen über Constitutional AI (Anthropic, 2022).
flowchart TD
    subgraph ClosedLoop ["Closed-Loop-Agentenarchitektur"]
        direction TB
        Agent["Autonomer Agentenkern (LLM Policy)"]
        Thought["Internes Denken (Gedankenraum L)"]
        Action["Ausführbarer Werkzeugaufruf (Aktionsraum A)"]
        Sandbox["Isolierte Sandbox (Python REPL / Shell / Search)"]
        Obs["Deterministische Umgebungsbeobachtung (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"Feedback-Aktualisierung (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["Die 3 Stufen agentischen Feedbacks"]
        direction TB
        T1["Stufe 1: In-Context-Umgebungs-Feedback (ReAct)<br/>• Verschränkte Schleife: Thought + Action + Observation<br/>• Faktenhalluzination bei Wissensabfragen auf 0 % gesenkt"]
        --> T2["Stufe 2: Policy-Level Ausführungs-Feedback (RLEF)<br/>• MDP-Formulierung: State, Action, Sandbox Reward<br/>• PPO-Optimierung mit Trennung von Public & Private Tests<br/>• Llama-3.1-70B steigert Genauigkeit bei CodeContests 1@3 von 27,5 % auf 40,1 %"]
        --> T3["Stufe 3: Autonome Werte-Selbstkorrektur (Constitutional AI)<br/>• Kritik- und Revisions-SFT auf Basis natürlicher Sprachprinzipien<br/>• RLAIF-Präferenzbelohnungsmodell ersetzt manuelle Annotation<br/>• Beseitigung des Engpasses menschlicher Skalierbarkeit"]
    end

    ClosedLoop ==> FeedbackTiers