Zum Hauptinhalt springen

5 Posts getaggt mit "reinforcement-learning"

Alle Tags anzeigen

[Webots Robotik] Sim-to-Real: Hardware-Transfer via Arduino Uno, HC-06 Bluetooth & ArUco-Vision-Tracking (#5)

· Eine Minute Lesezeit
Jaybee
AI & Robotics Engineer

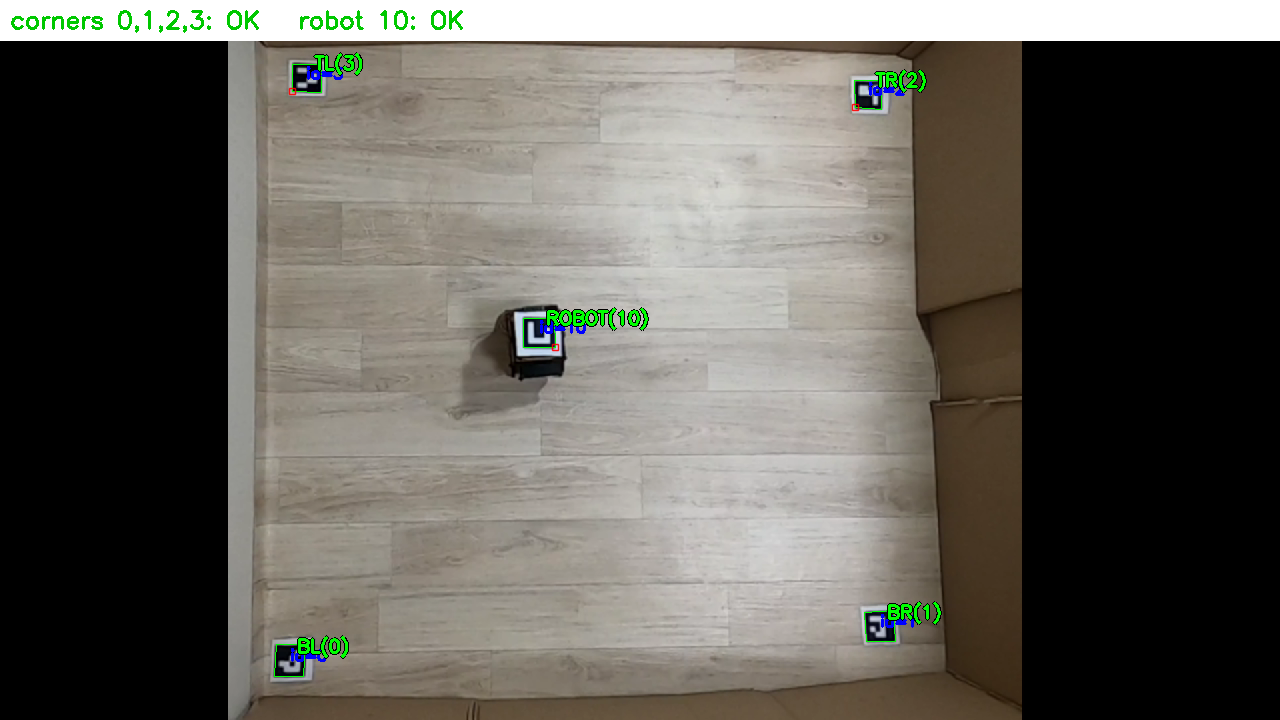
ArUco Marker Vision Tracking

📌 Kernaussagen (TL;DR)

  • Herausforderung: Strikte Ressourcenbeschränkungen (Arduino Uno mit 2 KB SRAM), nichtlinearer Radschlupf und die klassische Reality Gap zwischen Simulation und Realität.
  • Lösung: Auslagerung der Bildverarbeitung an einen Host-PC via ArUco-Deckenkamera-Homographie und drahtlose Steuerbefehlsübertragung via Bluetooth HC-06.
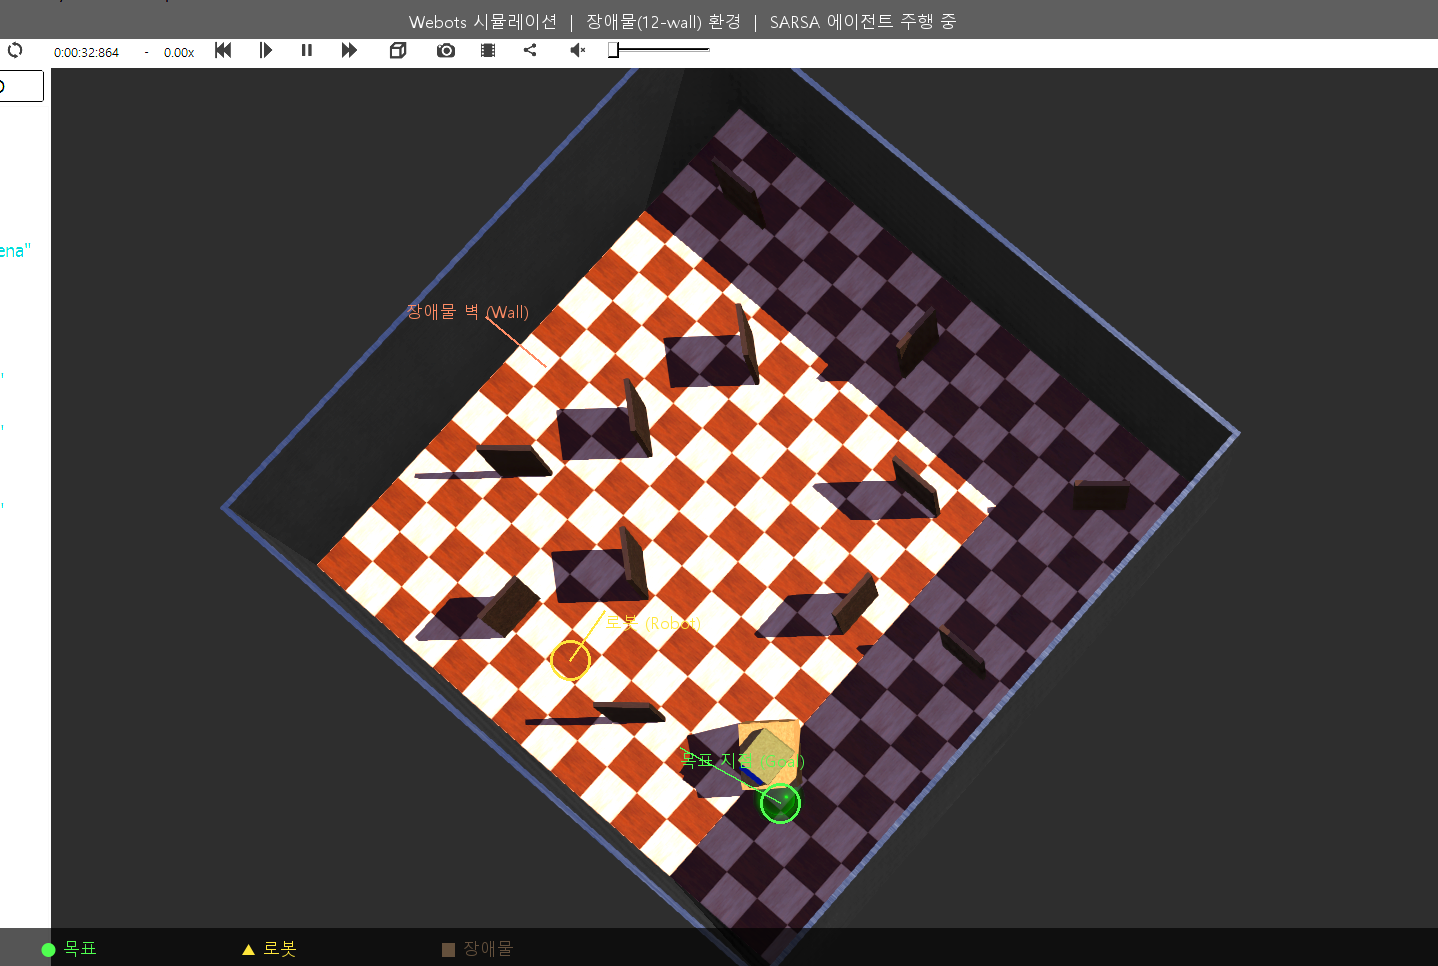
[Webots Robotik] Deterministische Evaluation via evaluate_qlearning & Benchmark gegen DQN und SARSA (#4)

· Eine Minute Lesezeit
Jaybee
AI & Robotics Engineer

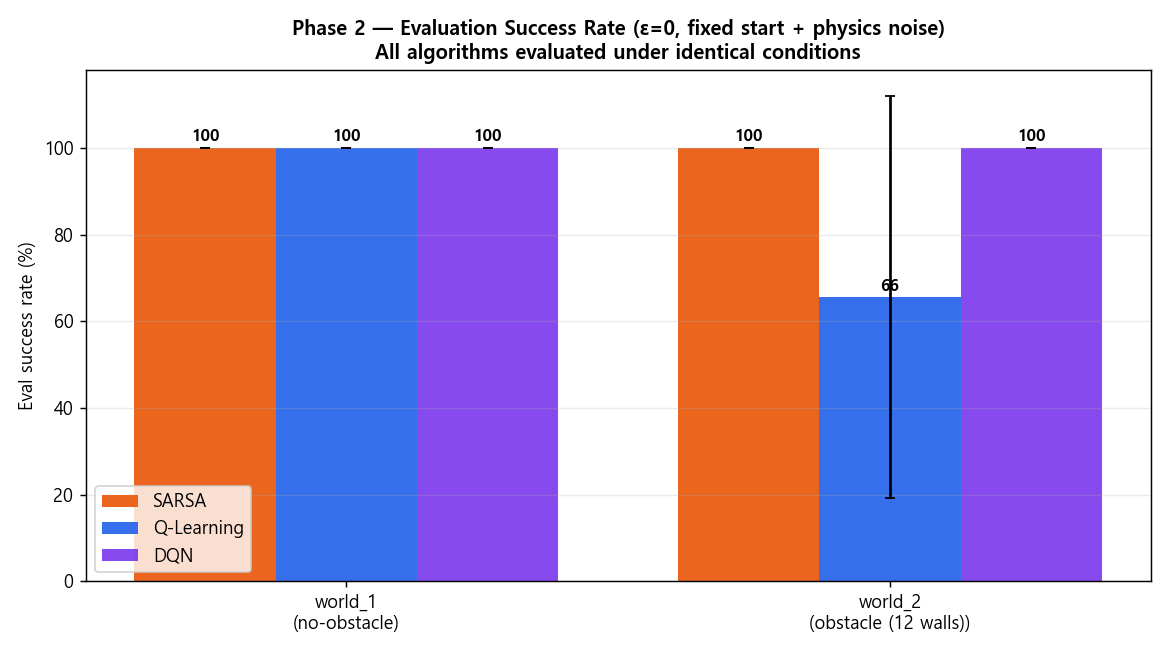
Erfolgs- und Schritt-Benchmark

📌 Kernaussagen (TL;DR)

  • Ziel: Messung der reinen, deterministischen Leistungsfähigkeit der gelernten Greedy-Policy ($\epsilon = 0$) ohne stochastisches Rauschen zur Validierung der Praxistauglichkeit.
  • Ergebnis: Tabellarisches Q-Learning erreicht 92 % Erfolgsquote bei 15-fach geringerem Rechenaufwand im Vergleich zu Deep Q-Networks (DQN).

[Webots Robotik] Lokale Minima in 12-Wände-Umgebungen überwinden: Multi-Seed Headless-Simulation (#3)

· Eine Minute Lesezeit
Jaybee
AI & Robotics Engineer

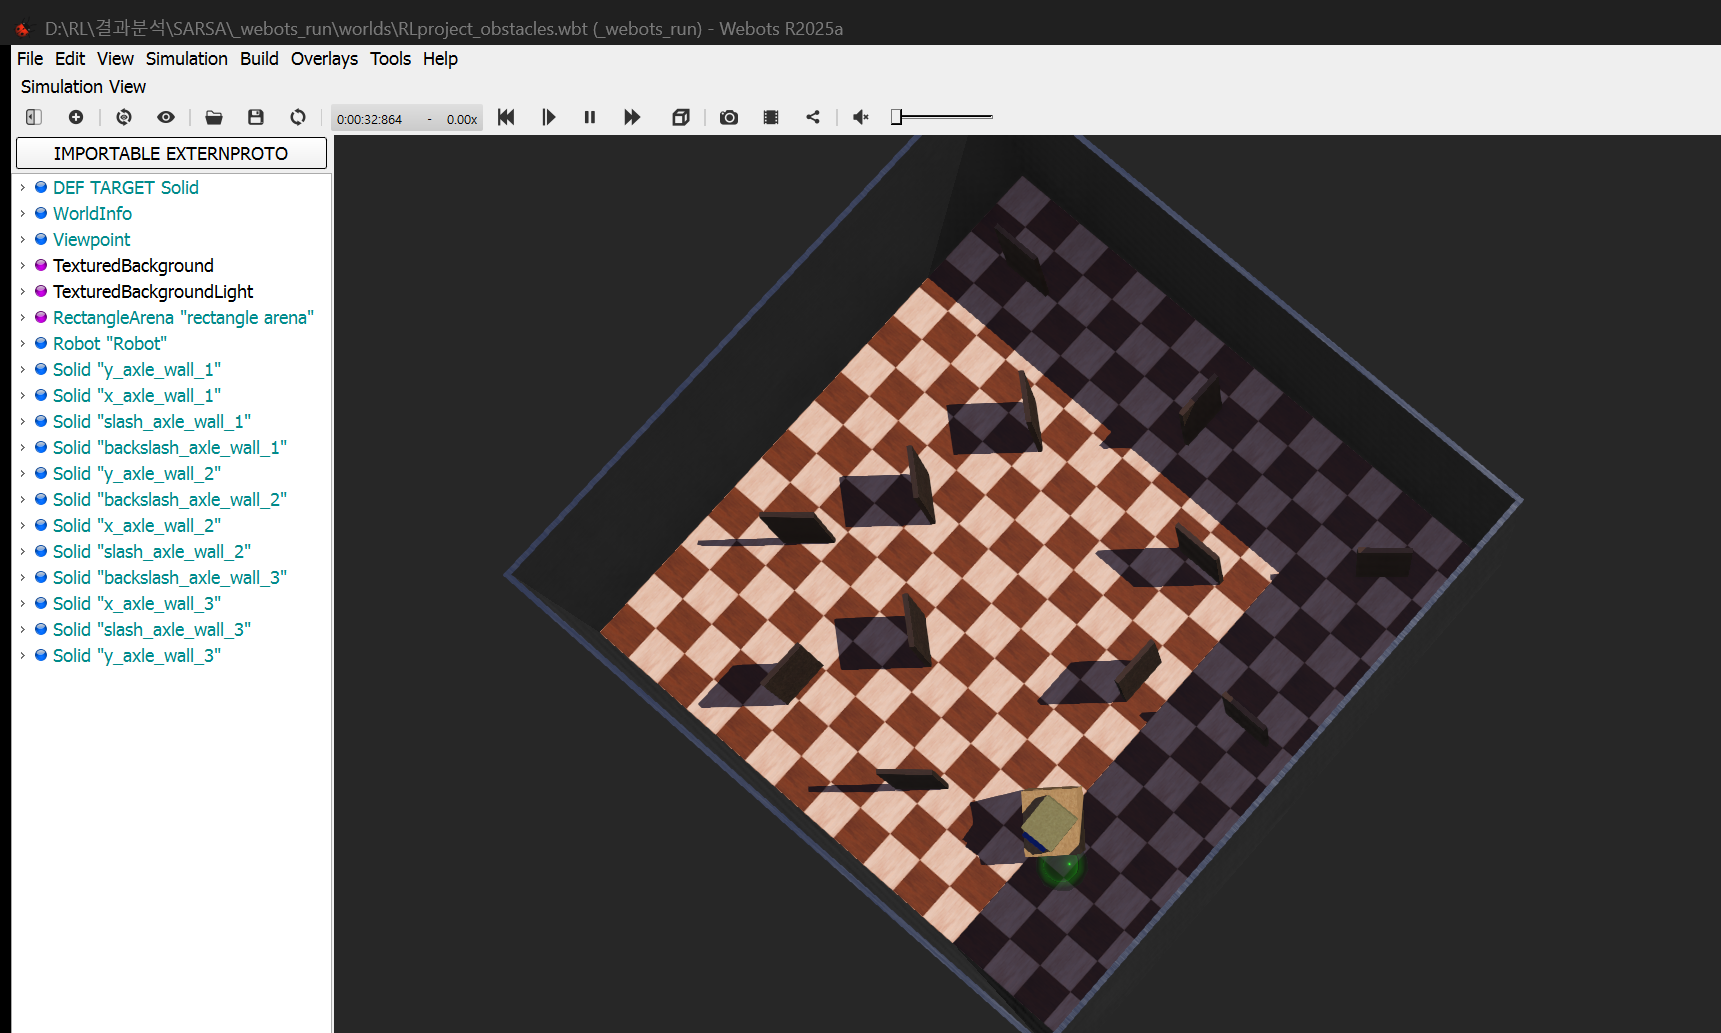
obstacle12 Simulations-Arena

📌 Kernaussagen (TL;DR)

  • Herausforderung: Liegt das Ziel direkt hinter einer Wand, zieht die Distanz-Belohnung den Roboter frontal in das Hindernis — er verfängt sich in einem lokalen Minimum.
  • Lösung: Temporäre Hindernis-Repulsion in der Belohnungsfunktion und automatisierte Headless-Simulationen mit verschiedenen Zufalls-Seeds.

[Webots Robotik] Tabellarische Q-Learning-Implementierung & Reward Shaping Tuning (#2)

· Eine Minute Lesezeit
Jaybee
AI & Robotics Engineer

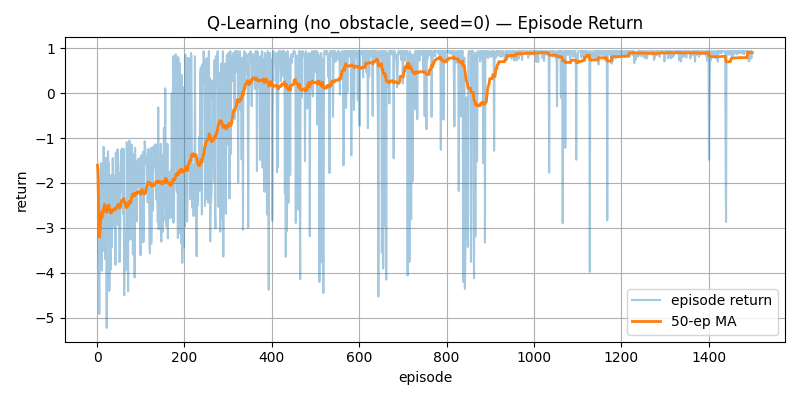
Trainings-Belohnungskurve

📌 Kernaussagen (TL;DR)

  • Herausforderung: Spärliche Belohnungen (+1,0 bei Zielerreichung, -1,0 bei Kollision) führen zu massiver Explorationsträgheit; der Roboter dreht sich ziellos im Kreis.
  • Lösung: Dichtes Reward-Shaping mit Distanz-Delta ($\Delta d$) und Geschwindigkeitsanreizen sowie exponentieller $\epsilon$-Zerfall ($0.95 ightarrow 0.05$).

[Webots Robotik] Autonome Q-Learning-Navigation: 648-Zustände-Diskretisierung & Socket-Architektur (#1)

· 2 Minuten Lesezeit
Jaybee
AI & Robotics Engineer

Webots Simulationsumgebung

📌 Kernaussagen (TL;DR)

  • Herausforderung: Kontinuierliche Sensordaten (Distanz und Kurswinkel) führen bei tabellarischem Q-Learning zu einer Zustandsexplosion; synchrone IPC mit dem Webots-Simulator erfordert minimale Latenzen.
  • Lösung: Reduktion auf 648 diskrete Zustände über 3 Distanzsektoren und 4 Orientierungsbereiche sowie ein robuster TCP-Socket-Server in Python.