[Stanford CS146S #2] Im Inneren von Coding-LLMs & Prompt Engineering: Pre-training, RLHF und das 'Trust but Verify' Schweizer-Käse-Modell

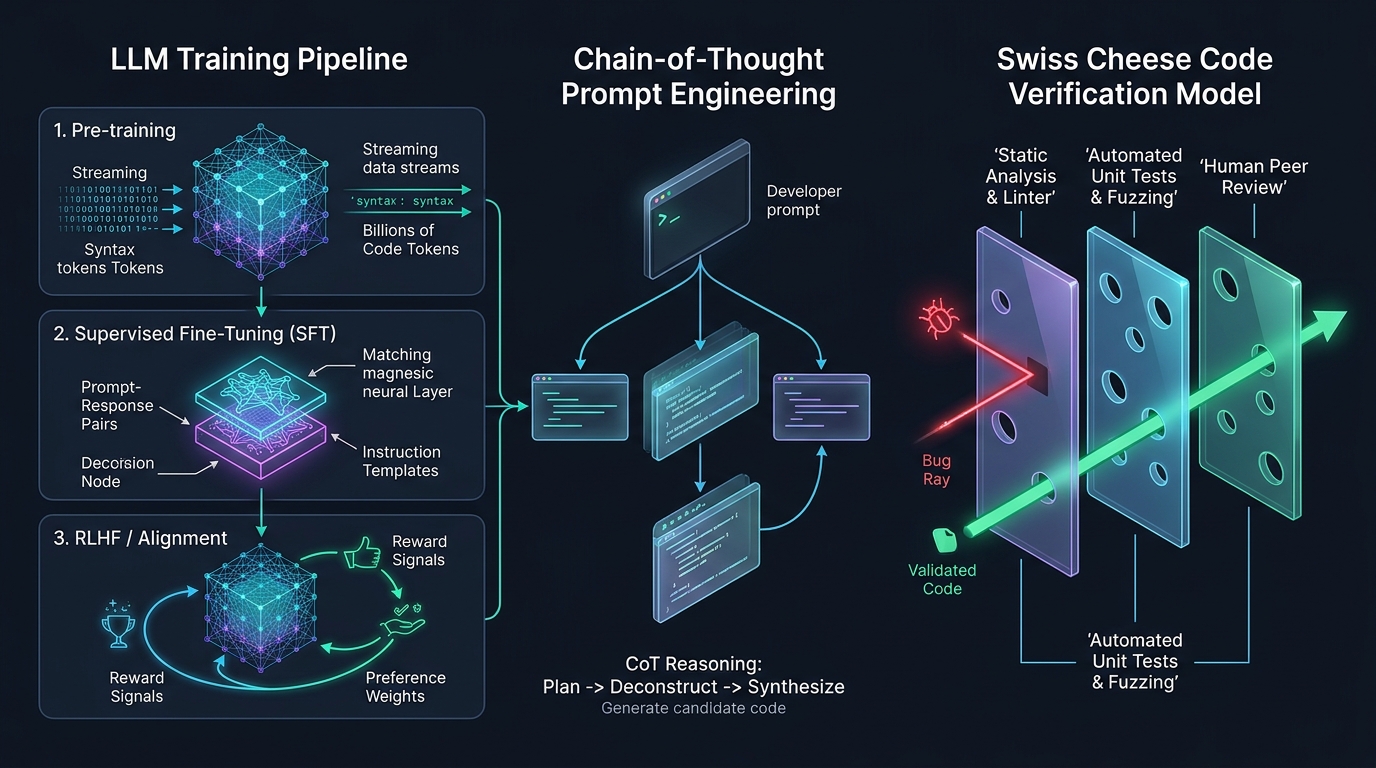
Willkommen zurück zur technischen Analyse der Stanford-Vorlesungsreihe CS146S: The Modern Software Developer.
In Vorlesung 1 haben wir den übergeordneten Paradigmenwechsel vom Tastatur-Typisten zum System-Dirigenten etabliert. In Vorlesung 2 (Woche 1) widmet sich das Curriculum dem rechnerischen Fundament dieser Revolution: großen Sprachmodellen für Code (Coding-LLMs) und der Disziplin des Prompt Engineerings.
Basierend auf Pionierarbeiten von Andrej Karpathy (Deep Dive into LLMs), OpenAI (How OpenAI Uses Codex) sowie aktuellen Prompt-Engineering-Forschungen beleuchtet diese Vorlesung, wie neuronale Netze Programmierfähigkeiten erlernen, warum sie statistische Simulatoren und keine bewussten Wesen bleiben und wie Softwareingenieure das Prinzip „Trust but Verify“ etablieren müssen, um das trügerische Schweizer-Käse-Modell KI-generierten Codes abzusichern.