[Stanford CS329A #3] Robuste Verifikation: Process Reward Models (PRM), Ensembles und skalierbare Aufsicht

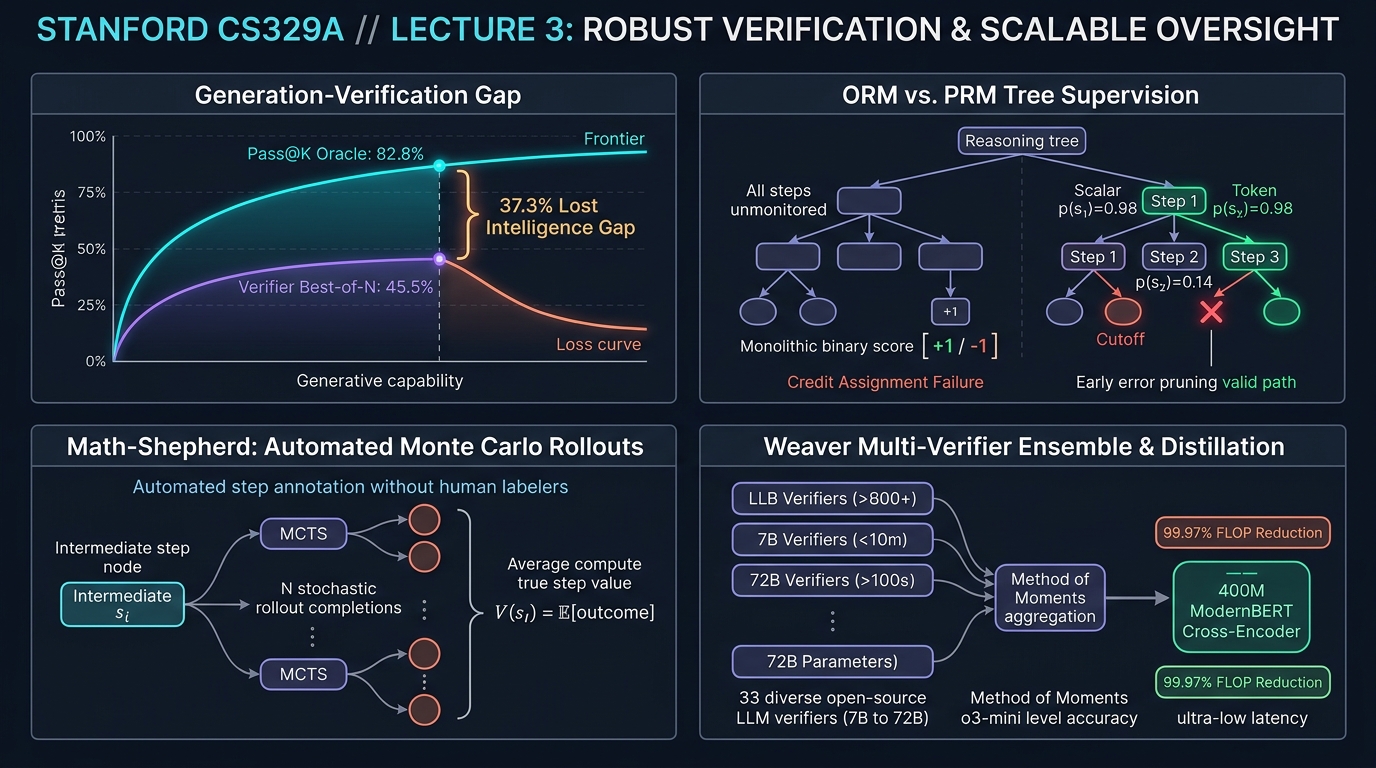
Willkommen zum dritten Teil unserer vertiefenden technischen Analyse des Hauptstudiumskurses der Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025).
In Vorlesung 2 haben wir die Mechanismen der Test-Time-Rechenzeitskalierung untersucht und eine fundamentale Erkenntnis gewonnen: Das Ziehen von Tausenden von Lösungskandidaten ($pass@k$) treibt zwar die theoretische Lösungsabdeckung über 99 %, doch dieses Potenzial bleibt ohne einen hochpräzisen Verifizierer (Verifier) unbrauchbar. Bei naiver Mehrheitsabstimmung (Majority Voting) stagniert die tatsächliche Trefferquote rasch auf einem Plateau.
Heute widmen wir uns dem architektonischen Kernsystem, das diesen Flaschenhals durchbricht: Robuste Verifikation (Robust Verification).
Menschliche Mathematiker und Ingenieure lösen anspruchsvolle Probleme selten in einem ununterbrochenen Vorwärtsdurchlauf; sie notieren einen Zwischenschritt, prüfen dessen algebraische Konsistenz, korrigieren Vorzeichenfehler und vollziehen bei Bedarf ein Backtracking, bevor sie den nächsten Deduktionsschritt wagen. Standardmäßige autoregressive Sprachmodelle generieren Text hingegen ausschließlich vorwärtsgerichtet. Unterläuft ihnen in einer frühen Phase ein logischer Fehler, erfinden sie nachfolgend immer komplexere Halluzinationen, um ihren ursprünglichen Irrtum zu rechtfertigen.
Wie können wir unabhängige Verifizierer konstruieren, die Zwischenschritte analysieren, logische Trugschlüsse isolieren und Agenten zu mathematisch bewiesenen Lösungen leiten – ohne Millionen Dollar für manuelle Annotationen auszugeben?
Anhand der Pionierarbeiten von Cobbe et al. (GSM8K, OpenAI, 2021), der Prozessüberwachung von Lightman et al. (PRM800K, 2023), der automatisierten Monte-Carlo-Schrittannotation (Math-Shepherd, Yu et al., 2023) und des aktuellen Weaver-Ensemble-Frameworks (NeurIPS 2025) erarbeiten wir die Grundlagen der modernen Verifizierer-Technik (Verifier Engineering).
flowchart TD
    subgraph Gap ["Das Kernproblem: Die Generation-Verification-Lücke"]
        direction TB
        G1["Pass@100 Orakel-Obergrenze: 82.8% (Theoretisches Potenzial)"]
        G2["Tatsächliche Mehrheitsabstimmung: 45.5% (Extrahierte Trefferquote)"]
        G1 -.->|"37.3%p verlorene Intelligenz durch Selektionsfehler"| G2
    end

    subgraph Solutions ["Die Evolution der Antwortverifikation in 4 Phasen"]
        direction TB
        S1["Outcome Reward Models (ORM)<br/>• Binäre Bewertung am Ende (+1 / -1)<br/>• Versagen der Kreditzuweisung (Credit Assignment Failure)"]
        --> S2["Process Reward Models (PRM800K)<br/>• Schrittweise Überwachung auf Token-Ebene p(step_i)<br/>• Frühzeitiges Beschneiden von Irrwegen & Produktregel"]
        --> S3["Math-Shepherd (Unüberwachte MCTS-Rollouts)<br/>• Automatisierte Monte-Carlo-Schrittbewertung<br/>• Übertrifft von Menschen annotierte PRMs"]
        --> S4["Weaver Ensemble schwacher Verifizierer<br/>• Momentenmethode (Method of Moments) für 33 schwache Verifizierer<br/>• Destillation in 400M ModernBERT Cross-Encoder (99.97% FLOP-Reduktion)"]
    end

    Gap ==> Solutions