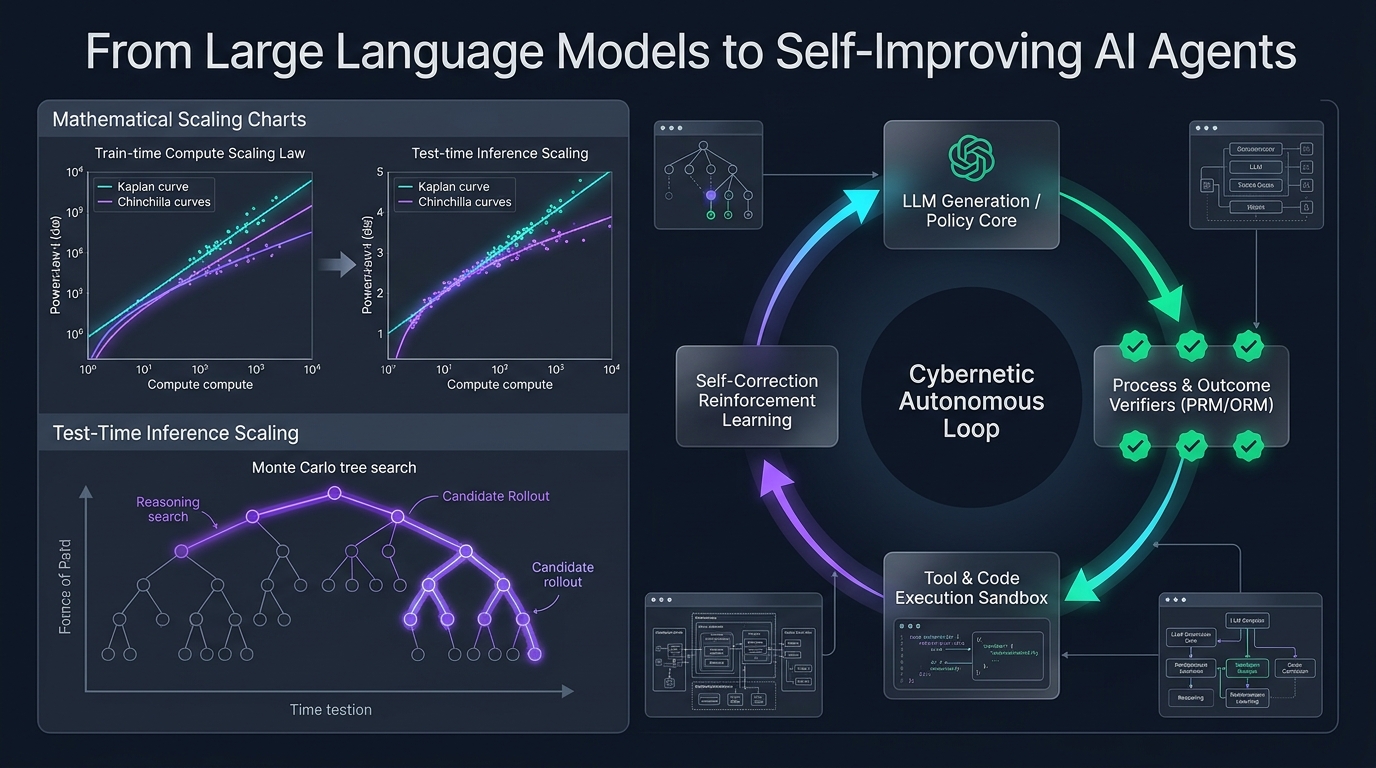
[Stanford CS329A #2] Test-Time Compute Scaling: Jenseits klassischer Skalierungsgesetze zur rechenoptimalen Inferenz

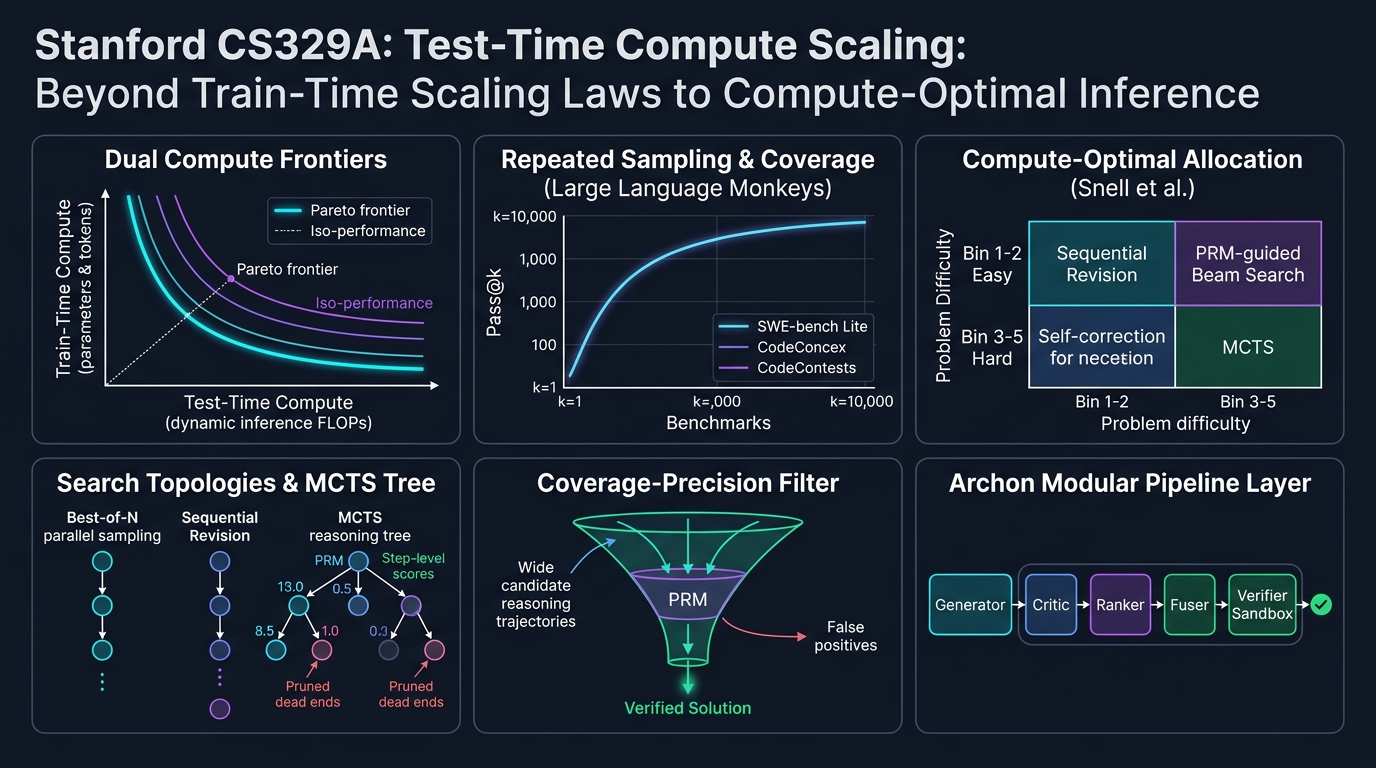
Willkommen zum zweiten Teil unserer fundierten ingenieurwissenschaftlichen Analyse des Hauptstudiums-Kurses der Stanford University, CS329A: Self-Improving AI Agents (Herbst 2025).
In der Einführungsvorlesung haben wir den makroökonomischen Paradigmenwechsel von statischen autoregressiven Next-Token-Prädiktoren hin zu autonomen Agentenschleifen mit Umgebungs-Feedback nachgezeichnet. Heute widmen wir uns dem rechnerischen Fundament dieser Autonomie: Test-Time Compute Scaling (Skalierung der Rechenzeit während der Inferenz).
Über ein halbes Jahrzehnt lang wurde die KI-Forschung von den Skalierungsgesetzen des Pre-Trainings beherrscht (Kaplan et al., Chinchilla): massive GPU-Cluster aufbauen, die Modellparameter N in die Hunderte Milliarden treiben und zig Billionen Web-Tokens D verarbeiten. Doch was geschieht, wenn wir uns nach dem Einfrieren der Modellgewichte θ weigern, eine hastige Greedy-Antwort innerhalb von 50 Millisekunden zu akzeptieren? Was passiert, wenn ein Agent stattdessen 10 Sekunden, 1 Minute oder 10 Minuten investiert, um Argumentationsbäume zu explorieren, Zwischenschritte zu verifizieren und Hypothesen zu revidieren?
Anhand der bahnbrechenden empirischen Resultate von Large Language Monkeys (Brown et al., 2024), Snell et al.s Compute-Optimal Scaling (Stanford/UC Berkeley, 2024) und des modularen Archon-Architektur-Frameworks formalisieren wir mathematisch und systemtechnisch, wie der Austausch von Inferenz-FLOPs gegen Parameterkapazität die moderne KI revolutioniert.
flowchart TD
    subgraph PreTrain ["Klassische Grenze: Skalierung der Trainingsrechenzeit"]
        direction TB
        P1["Billionen Web-Tokens (D)"] --> P2["Massive GPU-Cluster (C_train)"]
        P2 --> P3["Eingefrorenes dichtes Modell (θ)"]
        P3 --> P4["Einmaliger Forward-Pass (O(1) fixe Inferenz)"]
    end

    subgraph TestTime ["CS329A-Grenze: Skalierung der Test-Time-Rechenzeit"]
        direction TB
        T1["Eingefrorene Basisgewichte (θ)"] --> T2["Dynamische FLOP-Allokation während der Inferenz"]
        T2 --> T3{"Adaptive Strategiewahl nach Schwierigkeit"}
        T3 -- "Geringe Schwierigkeit (Bin 1-2)" --> T4["Sequenzielle Revision (Selbstkorrektur)"]
        T3 -- "Hohe Schwierigkeit (Bin 3-5)" --> T5["PRM-geführte Baumsuche (MCTS / Beam Search)"]
        T4 --> T6["Process Reward Model (PRM) Verifizierer"]
        T5 --> T6
        T6 --> T7["Mathematisch & mechanisch verifizierte Lösung"]
    end

    PreTrain -.->|"Wendepunkt: Parametersättigung"| TestTime