[Registro de Desarrollo Maeumjigi #7] Optimización de Generación de Datos Sintéticos (v5) e Integración del Frontend

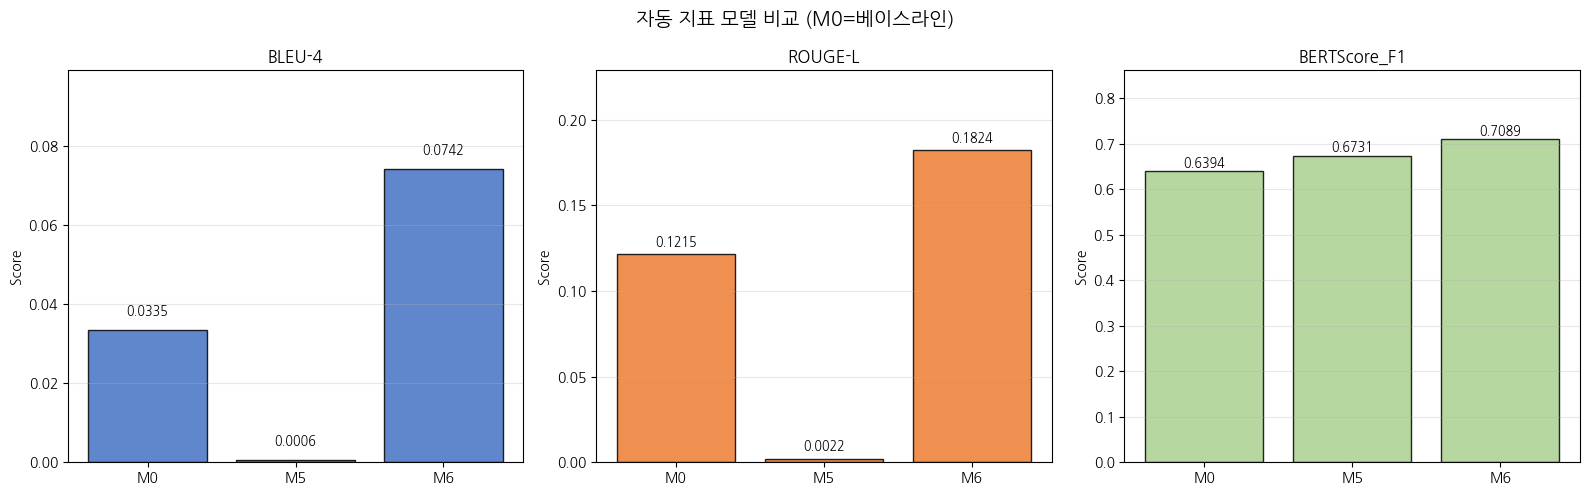
El 7 de abril fue el día en que intentamos la integración ejecutando el código frontend construido por un compañero de equipo en un entorno local, y también el día en que lanzamos un script masivo usando IA para 'sintetizar' 60,000 nuevos datos de asesoramiento.
Llenando los Espacios en Blanco: Generando Datos Sintéticos de IA (v5)
- Problema: Los datos previamente refinados (v4) por sí solos carecían de emociones específicas o escenarios detallados. Para resolver esto, queríamos usar la Interfaz de Programación de Aplicaciones (API) de Claude para generar 60,000 conversaciones virtuales de alta calidad que se ajustaran al formato de entrenamiento Llama 3.1.
- Proceso:
"Queremos crear un conjunto de datos v5 generado íntegramente por Claude. Por favor, haz un plan." "Quiero obtener 60,000 registros de conjuntos de datos generados por Claude en formato jsonl."
- Resultado: Establecimos
v5_plan.mdy comenzamos a generar datos. Sin embargo, el costo de las llamadas a la API se convirtió rápidamente en un obstáculo.
La Guerra Interminable con los Costos: Optimización de Prompts
- Problema: Al tratar de hacer que la IA creara 60,000 puntos de datos, resurgió el problema de costos que experimentamos hace unos días. Durante la ejecución del script, $10 en créditos se evaporaron en un instante.
- Proceso:
"¿Disminuirá el uso de tokens si procedemos exactamente como step8_generate_v5_optimized.py?" "Ya hemos consumido $10 de nuestro crédito y solo estamos en este nivel de progreso."
- Resultado: Instruimos a la IA para realizar ingeniería de prompts y optimización de código para reducir costos, evitando el desperdicio de tokens de salida y agregando lógica para guardar el progreso de manera segura.
Traspaso y Ejecución del Código Frontend del Compañero
- Proceso:
"Este proyecto fue creado por un compañero de equipo; ¿qué debo hacer para ejecutarlo?" "Error durante la migración de la base de datos..." "Ejecución hasta el paso 6 del frontend completada. Dime cómo apagarlo y el procedimiento para ejecutarlo de nuevo."
- Resultado: Tomamos el repositorio creado por un compañero de equipo, lo ejecutamos localmente y resolvimos errores de migración de BD. Ahora, el modelo de IA y el frontend están listos para integrarse.
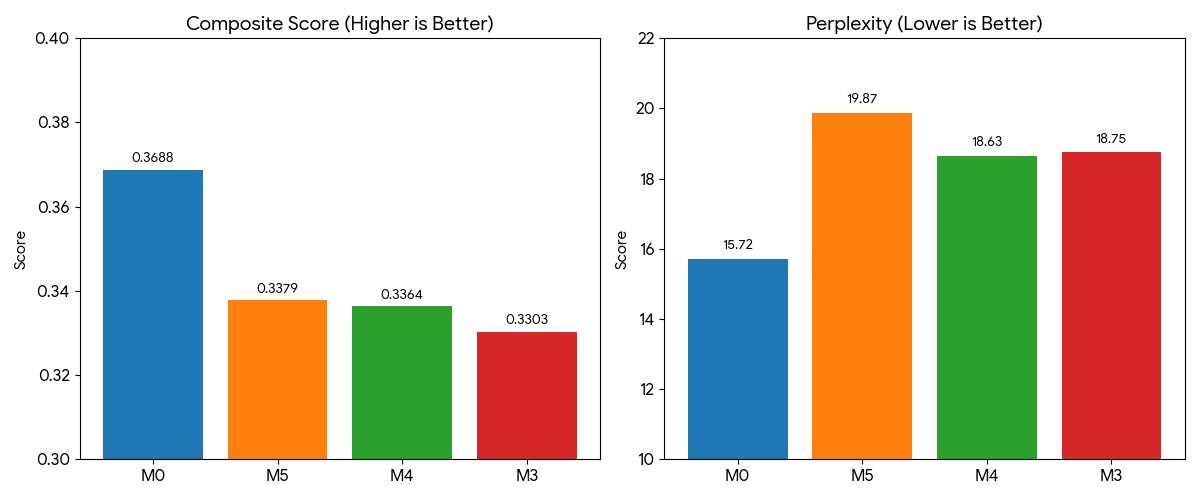
Hoy fue un día significativo donde implementamos la última tendencia de Generación de Datos Sintéticos, haciendo que una IA escriba los libros de texto (datos) para enseñar a otra IA.