[Registro de Desarrollo Maeumjigi #12] Fine-Tuning de Modelos Masivos de 70B y Lucha con la Memoria GPU (OOM)

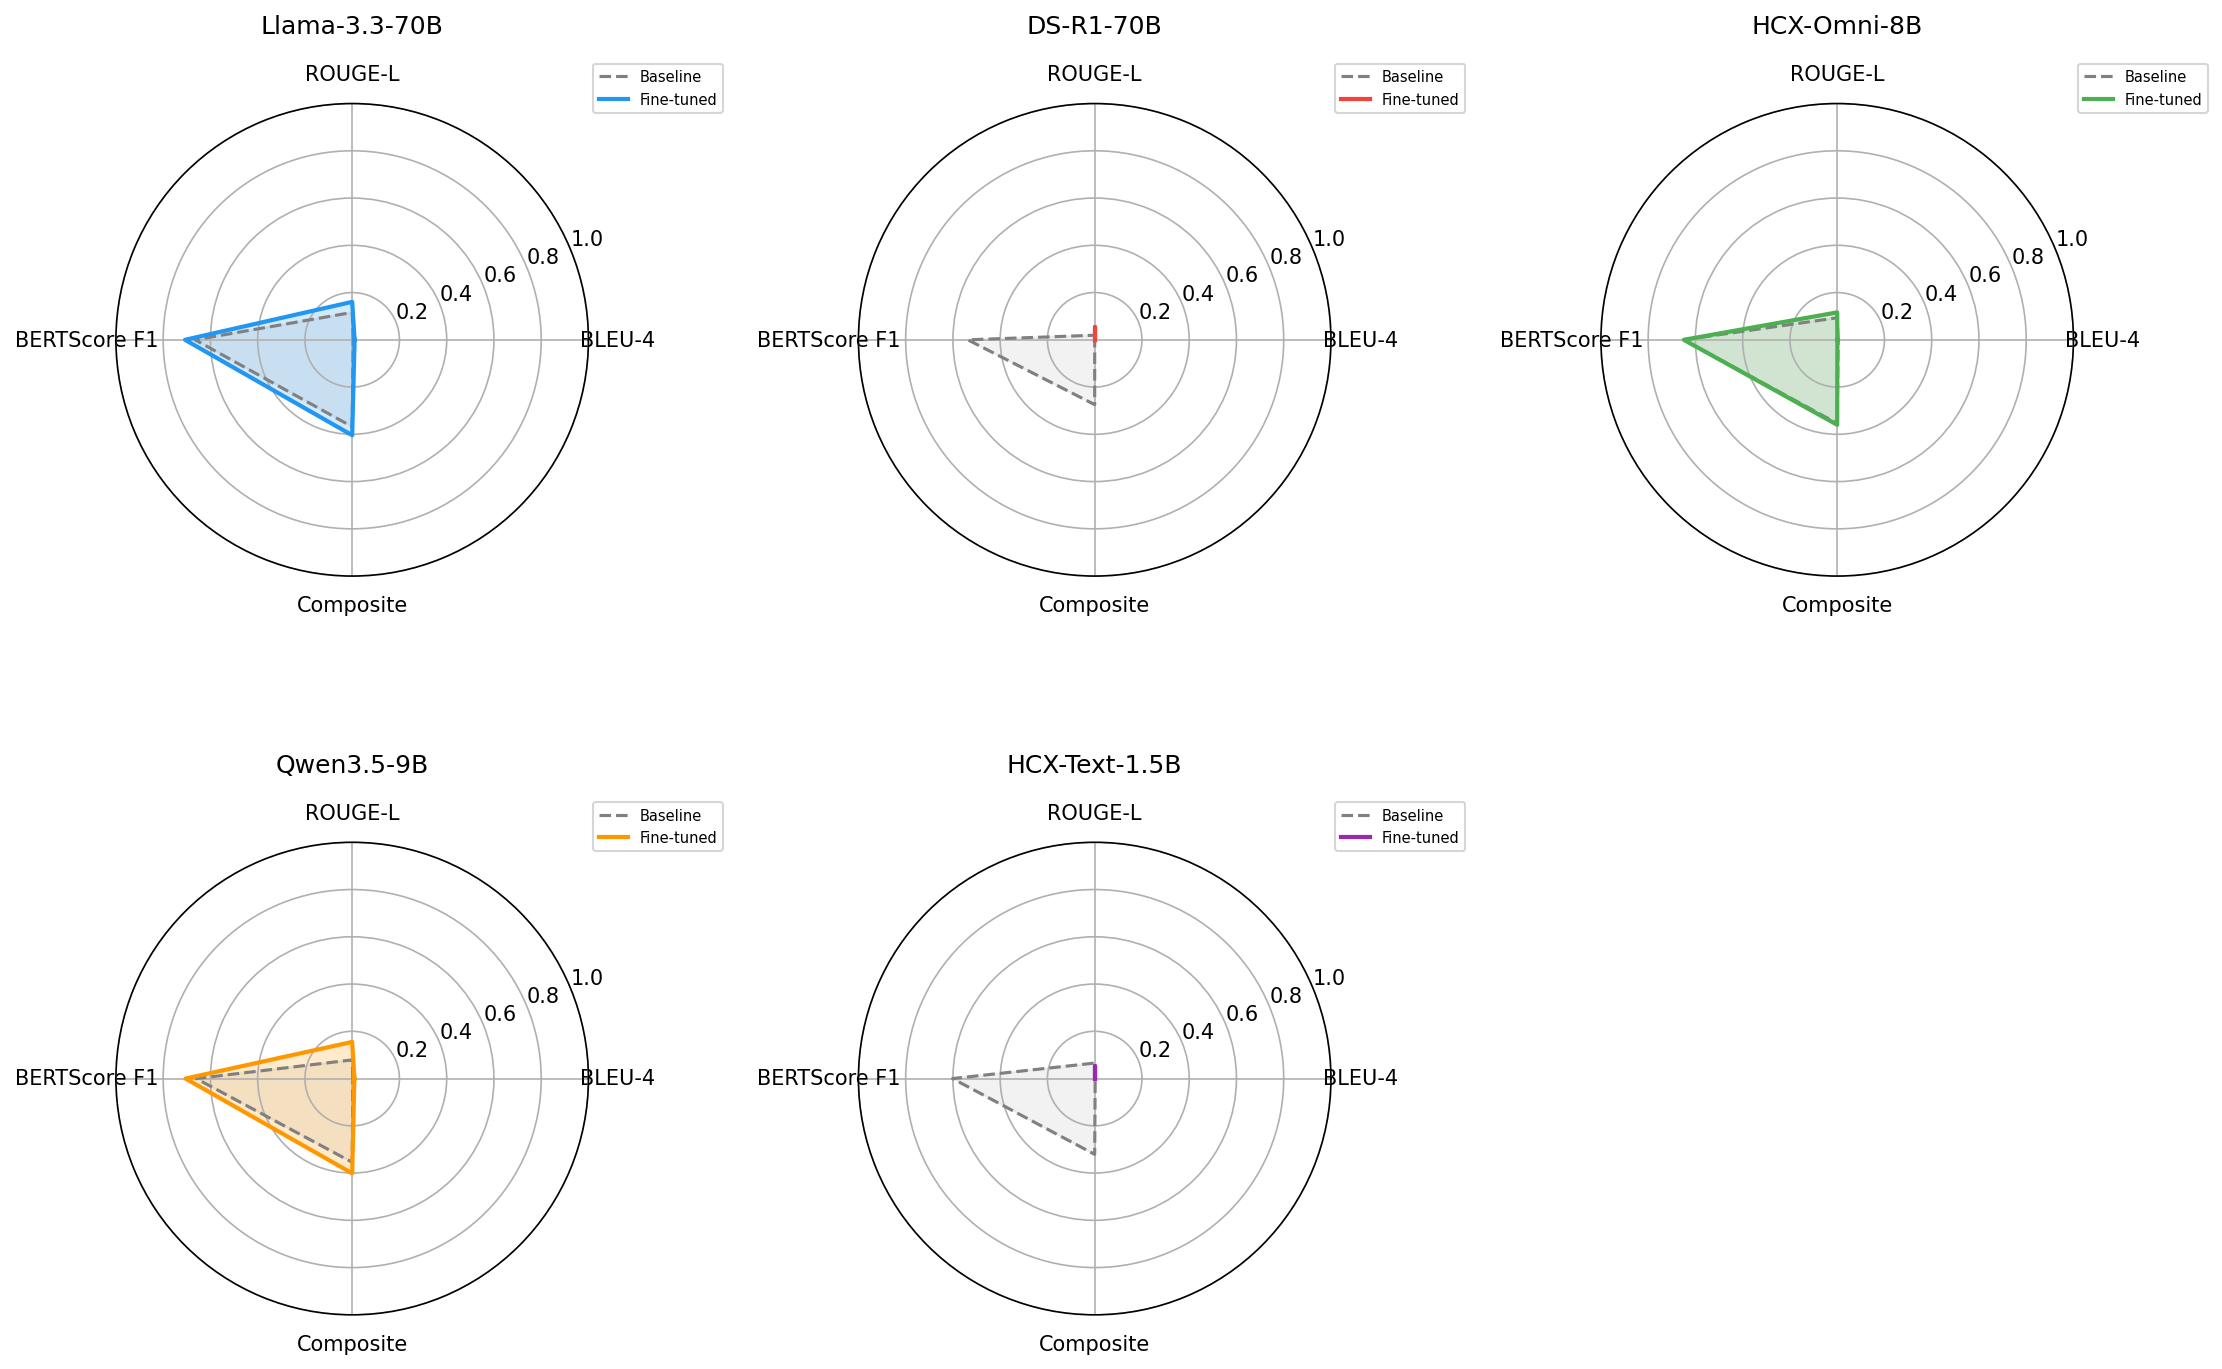
El 3 de mayo, habiendo ganado suficiente experiencia con los modelos 8B, nuestro equipo finalmente desafió a los reyes del rendimiento: el fine-tuning de modelos masivos de 70B (70 mil millones de parámetros). Intentamos entrenar tanto Llama 3.3 70B como DeepSeek-R1 70B, pero chocamos con un muro de recursos de hardware.
Modelos de 70B y el Terror del OOM (Fuera de Memoria)
- Problema: Tan pronto como ejecutamos el código en el servidor, comenzaron a aparecer errores.
- Proceso:
"Copié la carpeta del servidor. Por favor, verifique e identifique la causa del error." "¿No necesitamos modificar el modelo 70B de DeepSeek?"
- Resultado: Nuestro breve momento de relajación analizando los registros fue destrozado cuando los modelos 70B devoraron instantáneamente toda la memoria de la GPU. (¡Ocurrió un error OOM!)
La Operación de Dieta de Memoria GPU
- Problema: "El uso de la memoria GPU ya está al MÁXIMO." Teníamos que reducir el uso de la memoria para que el entrenamiento no se bloqueara.
- Proceso:
"Modificado a save_steps = 50, eval_steps = 50, patience = 10." "Configuré el max_seq_length de ambos modelos a 512, pero nvitop aún muestra el uso de memoria al máximo. ¿Por qué?"
- Resultado: Redujimos drásticamente la longitud del contexto a 512 y modificamos hiperparámetros. Sin embargo, VRAM todavía estaba al límite absoluto. Finalmente, el entrenamiento se congelaba repetidamente en los pasos 100 y 150.
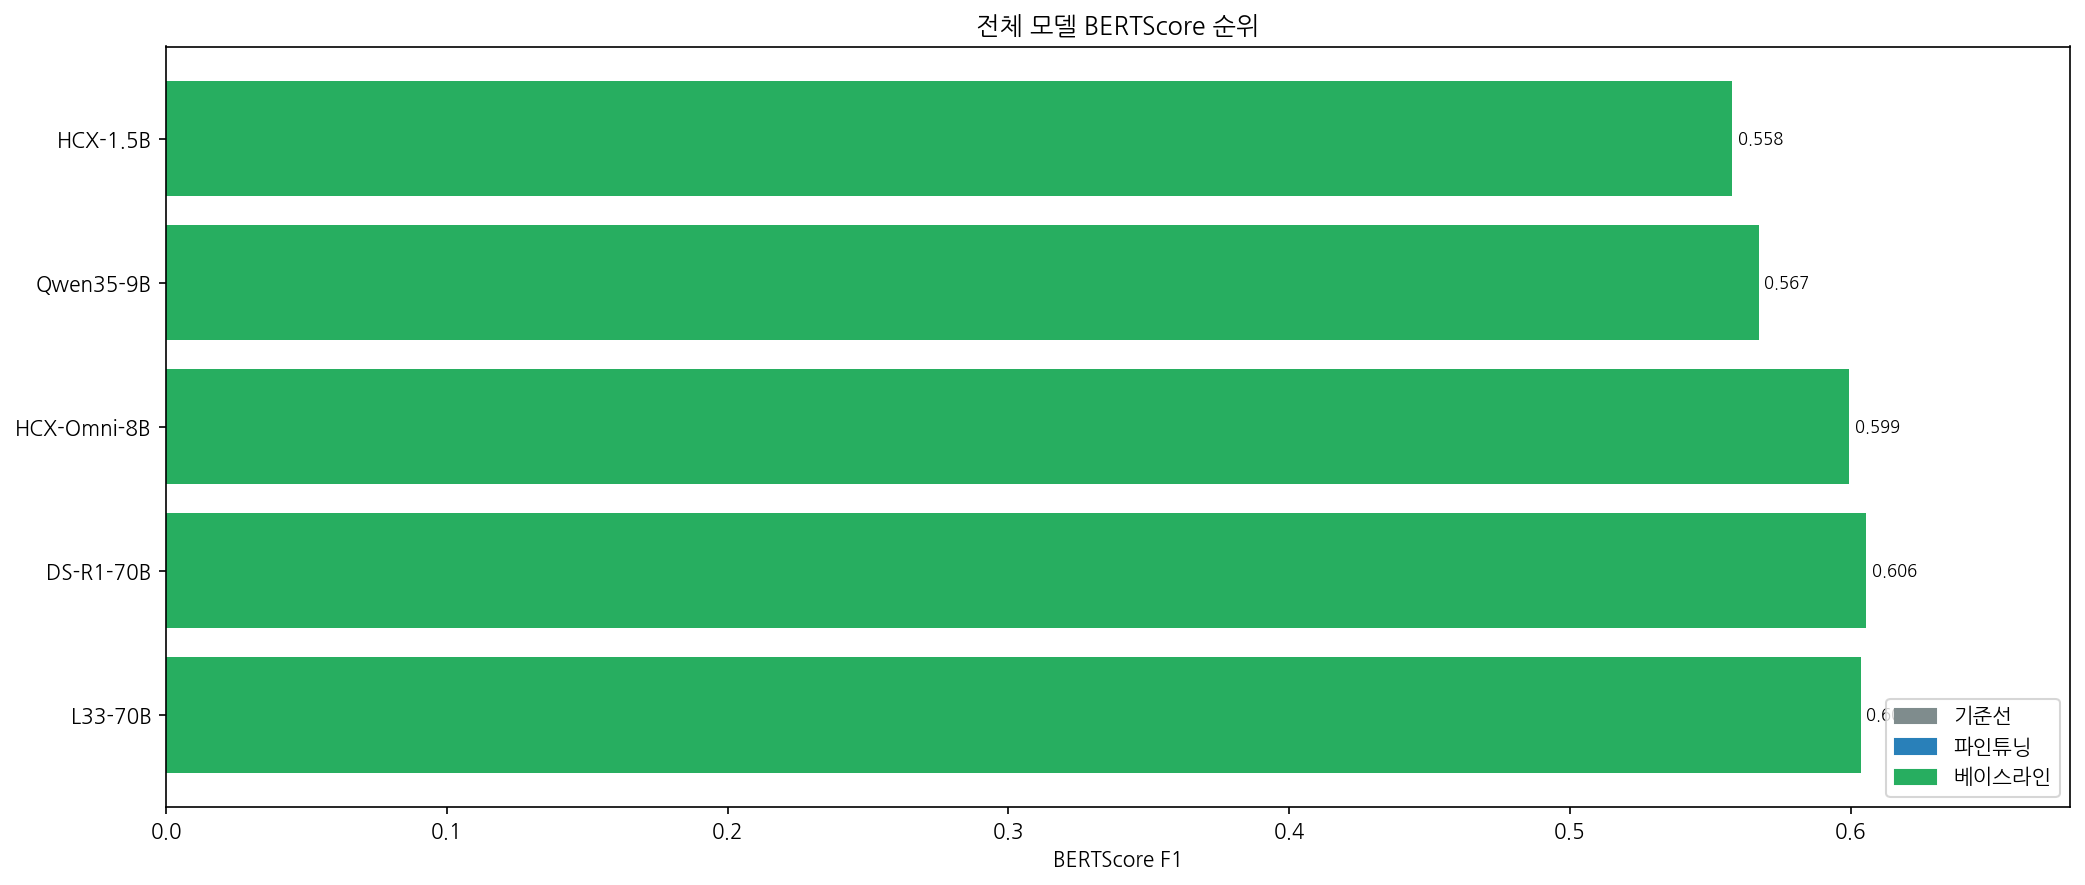
Domesticar una bestia masiva como 70B no es fácil. ¿Lograremos hacer fine-tuning a los modelos de 70B? ¡Continuará!