[Registro de Desarrollo Maeumjigi #14] Fine-Tuning Completado y Pipeline de Inferencia Paralela

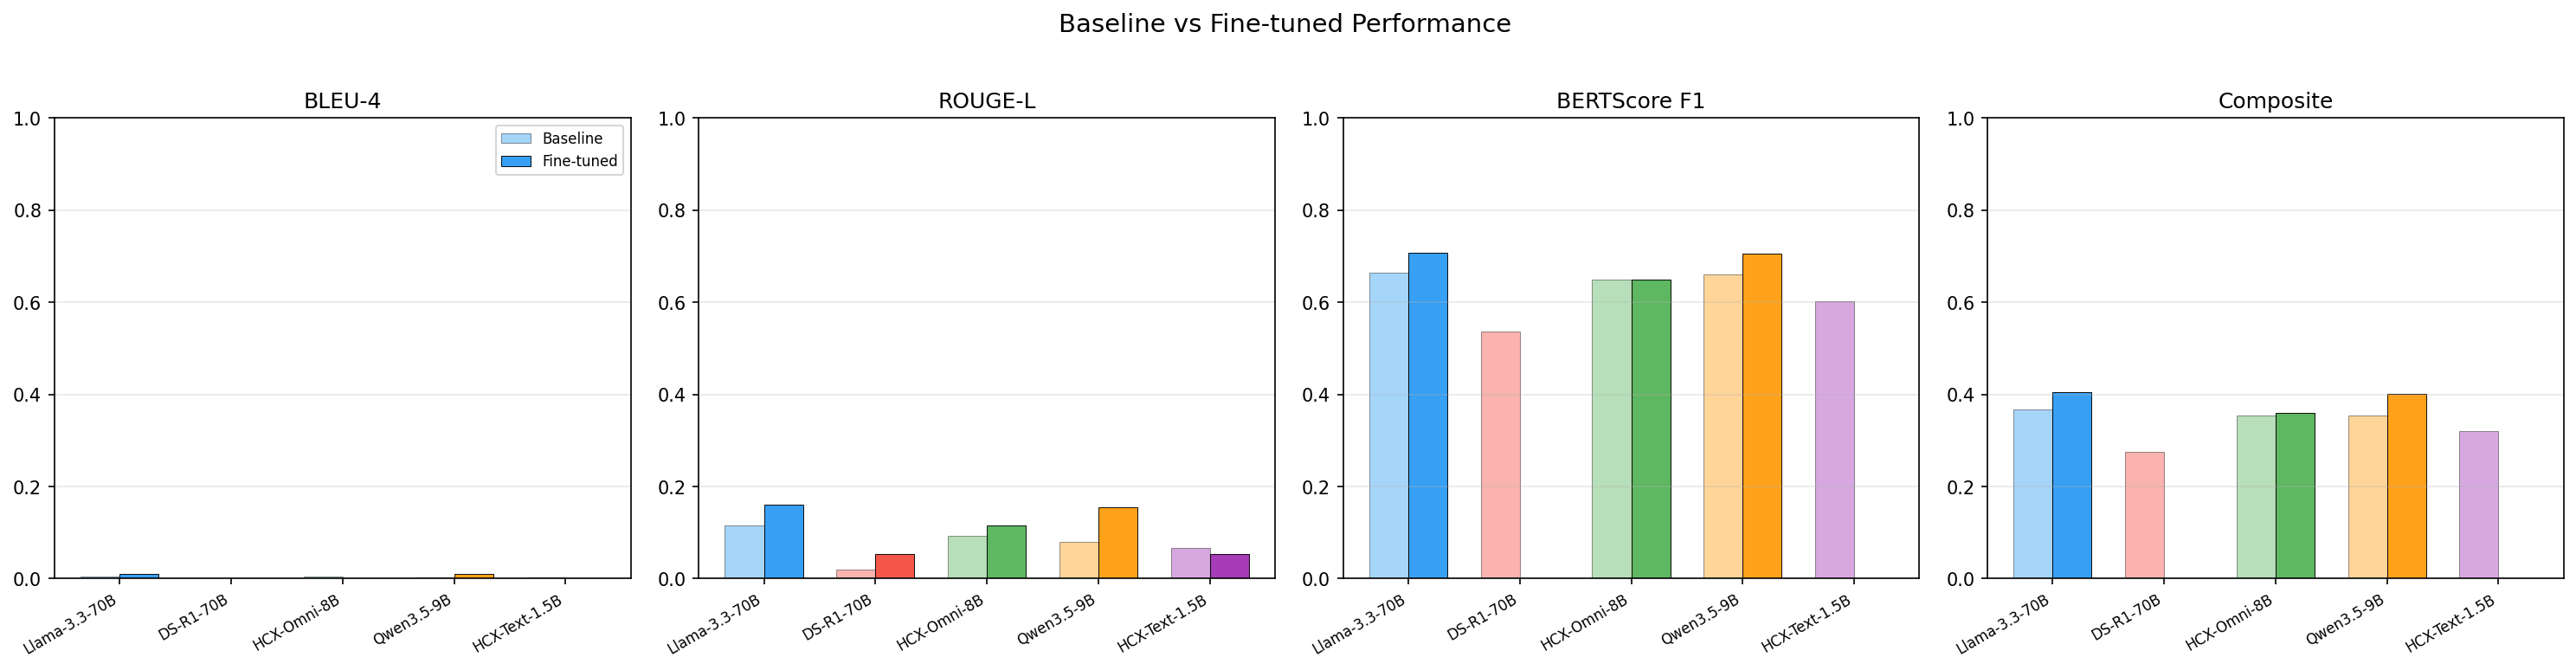
¡El 6 de mayo, finalmente escapamos del largo pantano del fine-tuning! Después de varias noches de trabajo, el entrenamiento de los modelos como HCX-Omni-8B y Qwen35-9B se completó con éxito.
Fine-Tuning Completo y Análisis de Registros
A medida que avanzaba el entrenamiento, pudimos ver cómo los valores de pérdida disminuían de manera estable. Tuvimos un momento de confusión tratando de averiguar si esto era train loss o validation loss, pero como el entrenamiento ya estaba completo, pasamos inmediatamente a la fase de inferencia y evaluación (Eval) utilizando los últimos checkpoints.
Entorno de Inferencia Paralela
Comenzamos las pruebas de generación unificando el max_new_tokens a 1024, preocupándonos por un posible OOM. Sin embargo, la velocidad de inferencia fue mucho más lenta de lo esperado.
"Usamos dos tarjetas gráficas para entrenar, ¿por qué la inferencia solo usa una?"
Para utilizar el 100% de los recursos de la GPU del servidor, escribimos un nuevo script run_eval_parallel.sh para procesar inferencias en paralelo. Esto redujo drásticamente el tiempo de inferencia, y construimos con éxito un pipeline que agrega automáticamente los resultados a un archivo de Excel.
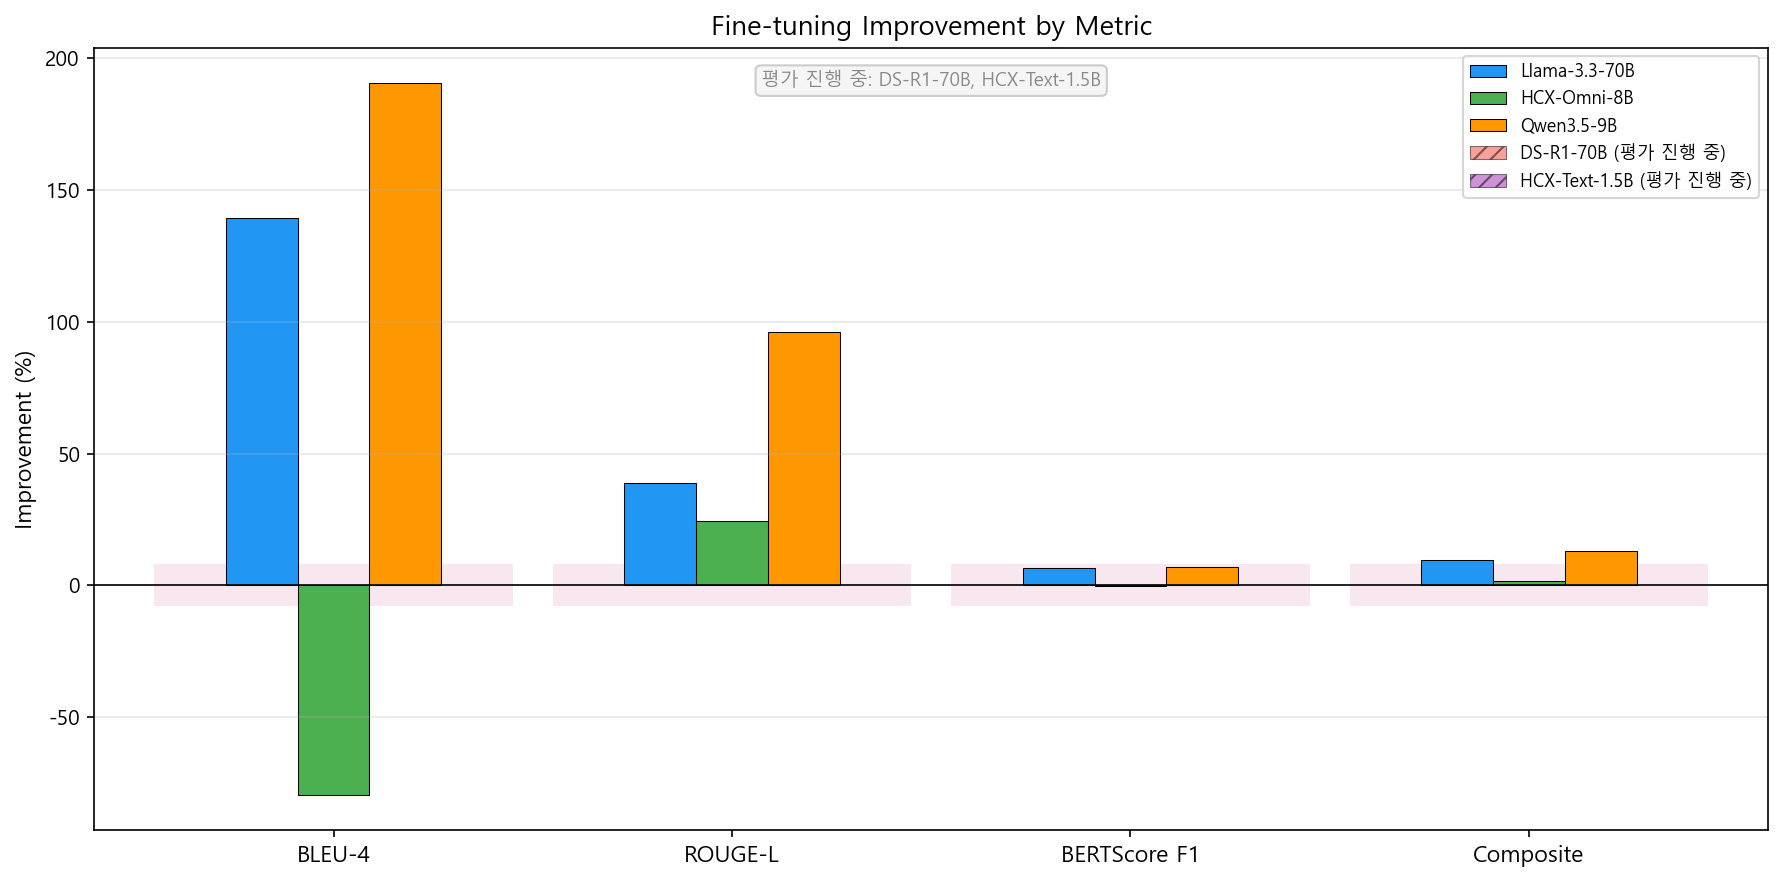
Aunque ocurrió un error porque la VRAM no se liberó correctamente al pasar del DSR1-70B al siguiente modelo, lo resolvimos aislando los entornos con el script paralelo. ¡Ahora es el momento de comparar la calidad de las respuestas!