[Registro de Desarrollo Maeumjigi #18] Expandiendo Tokens de Inferencia y Comparando Resultados

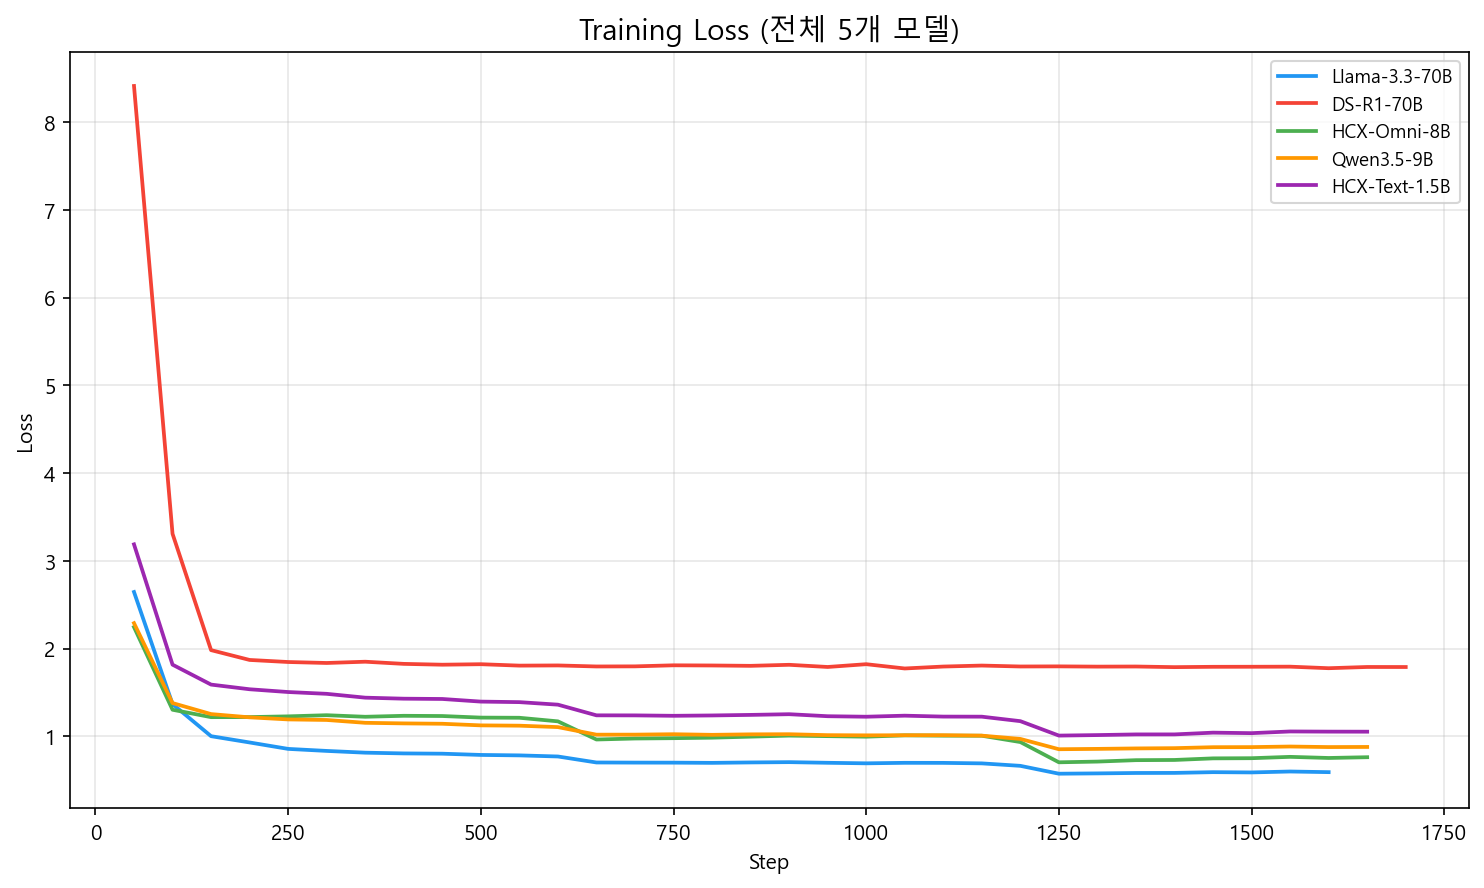
El 13 de mayo, después de corregir los errores, reanudamos las pruebas de inferencia para los modelos del 2do fine-tuning.
Aumentar la Longitud del Token
Revisando los resultados de inferencia, sentí que las respuestas de Llama33-70B_a8 seguían siendo extrañamente cortas.
"Siento que max_seq_length y max_new_tokens son muy pequeños. Mirando la VRAM, ¿cuánto puedo aumentarlos?"
Calculando la VRAM disponible con la IA, aumentamos audazmente max_new_tokens a 384. ¡El resultado fue un gran éxito!
Al simplemente aumentar la asignación de tokens, el modelo comenzó a generar oraciones de empatía mucho más profundas y cálidas. El modelo había estado limitando sus palabras porque estaba atrapado en un recuento de tokens limitado.
Análisis Comparativo del Valor Alfa
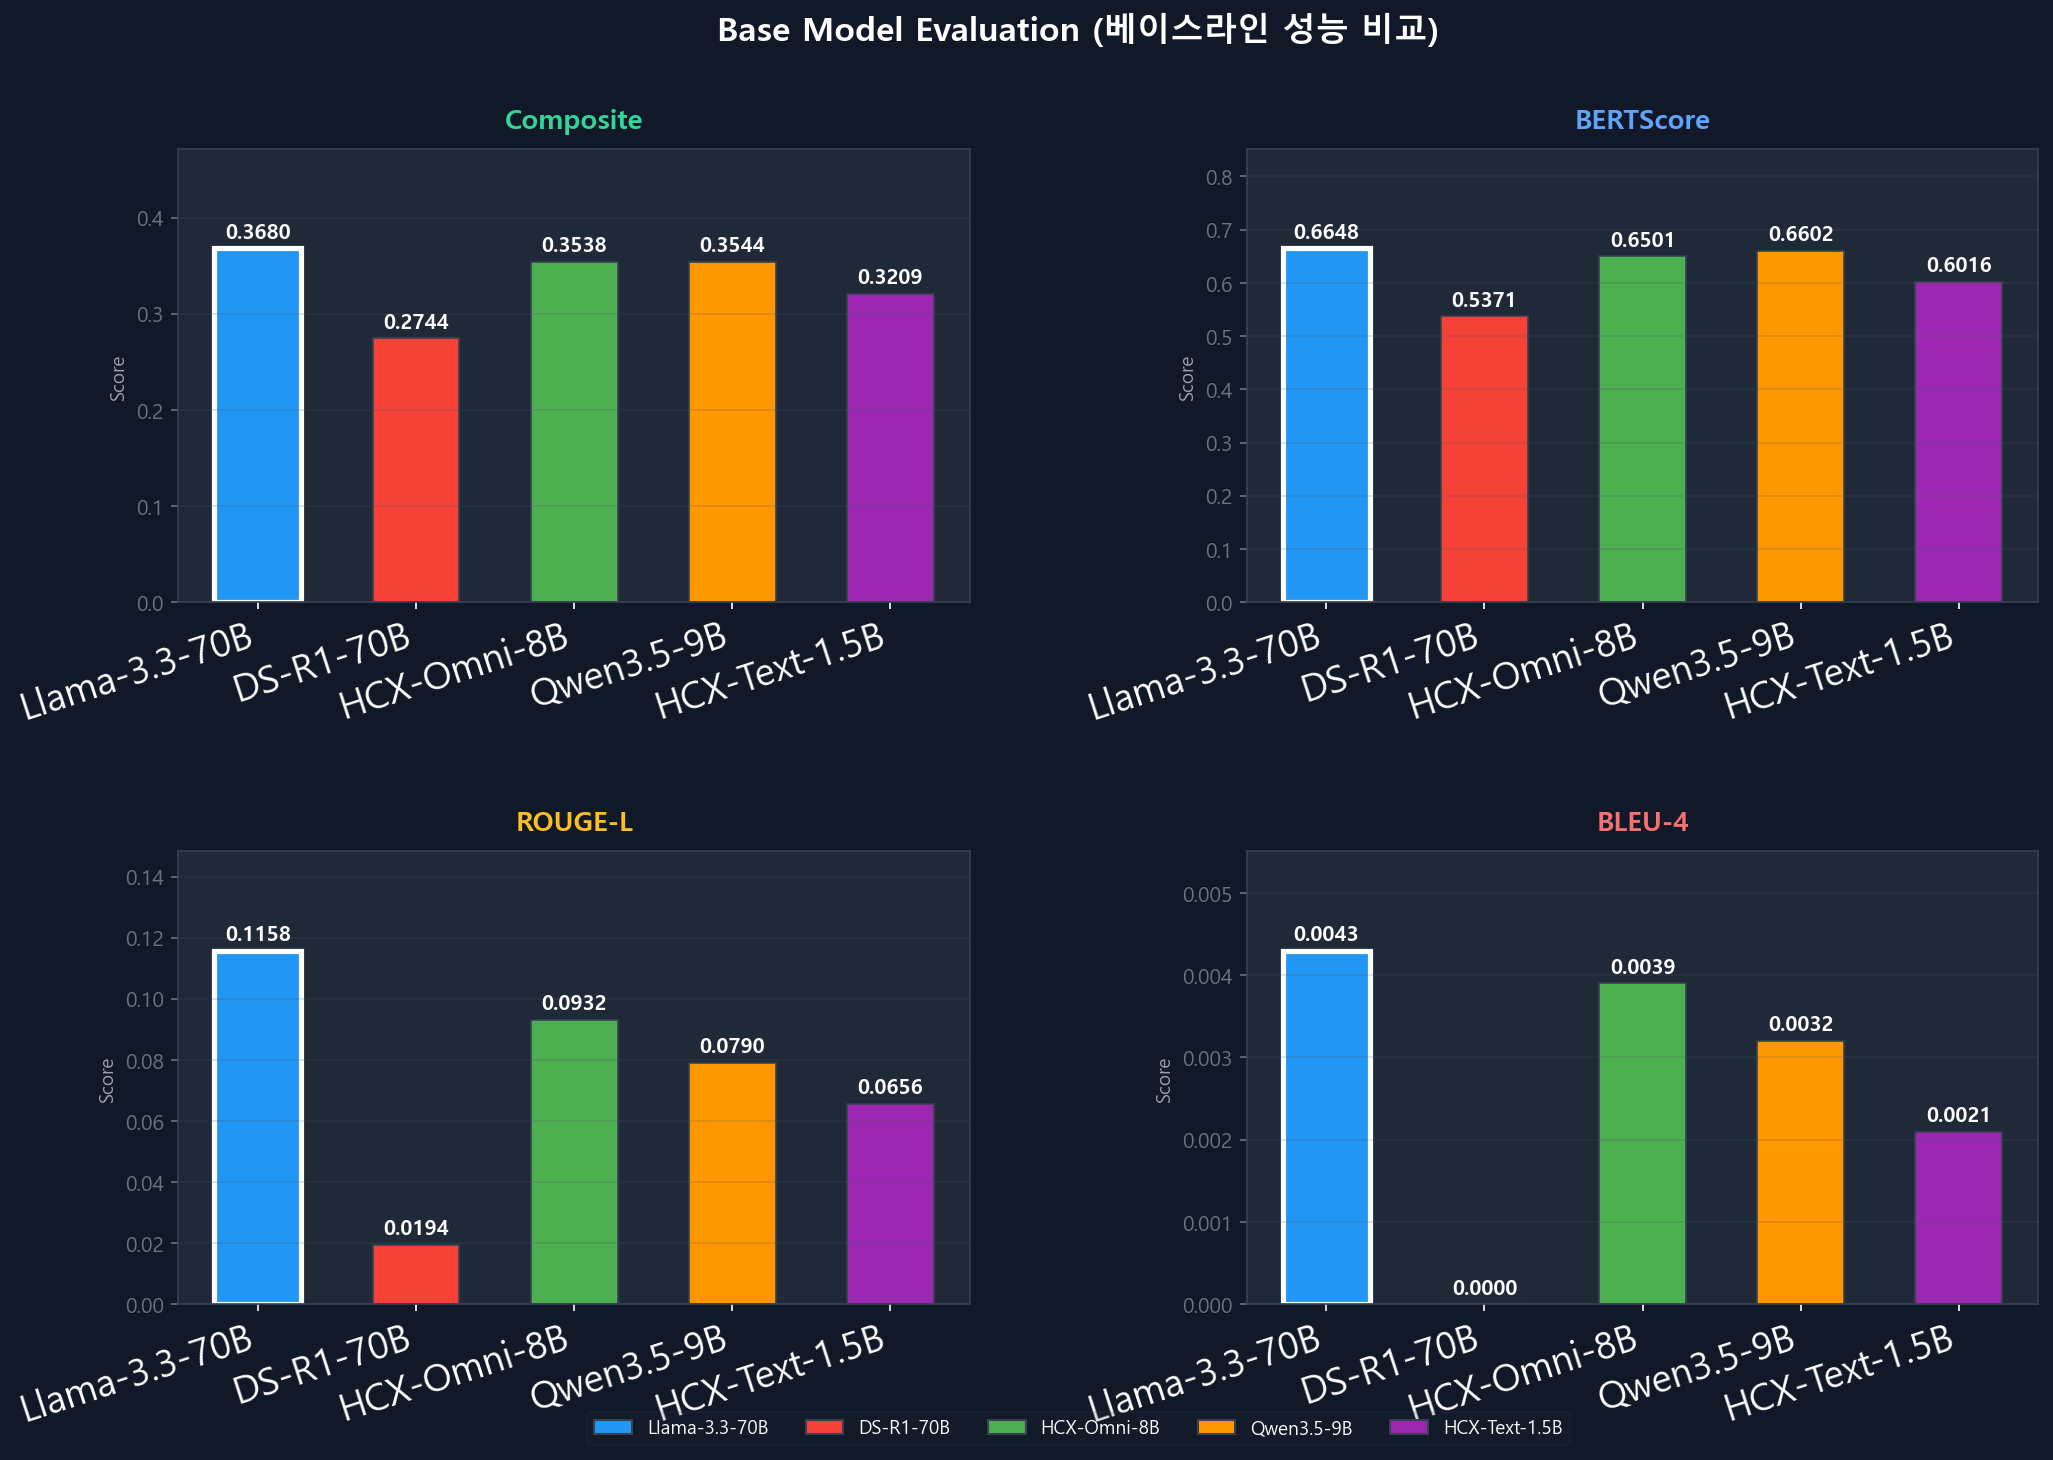
También se obtuvieron los resultados de la diferencia de rendimiento según el hiperparámetro de LoRA alpha. Generamos gráficos como 05_alpha_comparison_daily.png. Con rank=16 fijo, visualizamos claramente cómo diferían los patrones y la calidad final al dar alpha=8 frente a alpha=16.
Los modelos con los parámetros correctos y suficiente longitud de token se estaban acercando al verdadero 'Maeumjigi' que planeamos.