[Robótica Webots] Navegación Autónoma con Q-Learning: Discretización de 648 Estados y Arquitectura de Sockets (#1)

📌 Puntos Clave (TL;DR)
- Problema: Las lecturas continuas de sensores (distancia y orientación) provocan una explosión del espacio de estados para el Q-Learning tabular, y la sincronización con el simulador Webots requiere una comunicación de baja latencia.
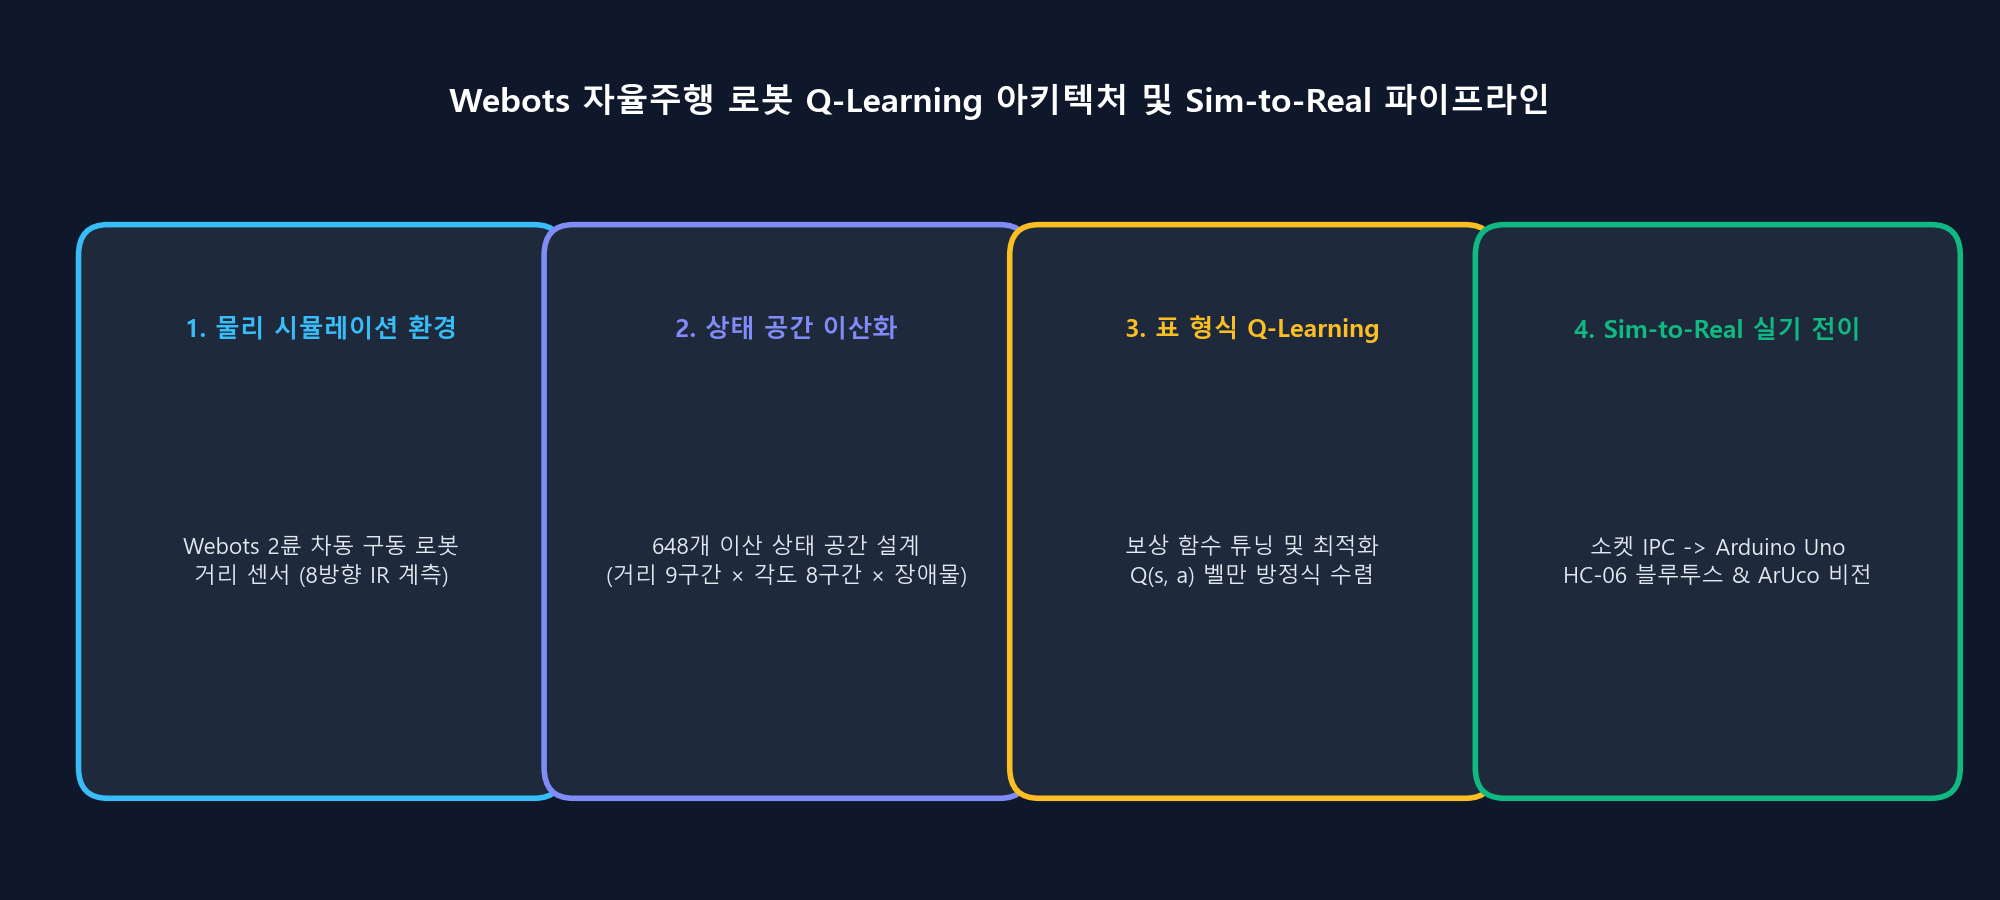
- Solución: Diseño de un mapeador de sensores continuos en 5 dimensiones que produce 3 × 8 × 3 × 3 × 3 = 648 estados discretos (
discretizer.py) y una canalización IPC mediante sockets TCP (puerto 5000, JSON delimitado por líneas).- Resultado: Indexación ultrarrápida de la tabla Q en tiempo O(1) y sincronización física estable en pasos de 32 ms entre el simulador y el agente Python.
1. Contexto del Proyecto: ¿Por qué Webots y Q-Learning?
Permitir que un robot móvil con tracción diferencial navegue en un entorno interior desconocido y alcance un objetivo evitando obstáculos es un desafío clásico de la robótica. Aunque el aprendizaje por refuerzo profundo (DQN, PPO) maneja entradas complejas, demanda grandes recursos de cómputo y carece de interpretabilidad directa.
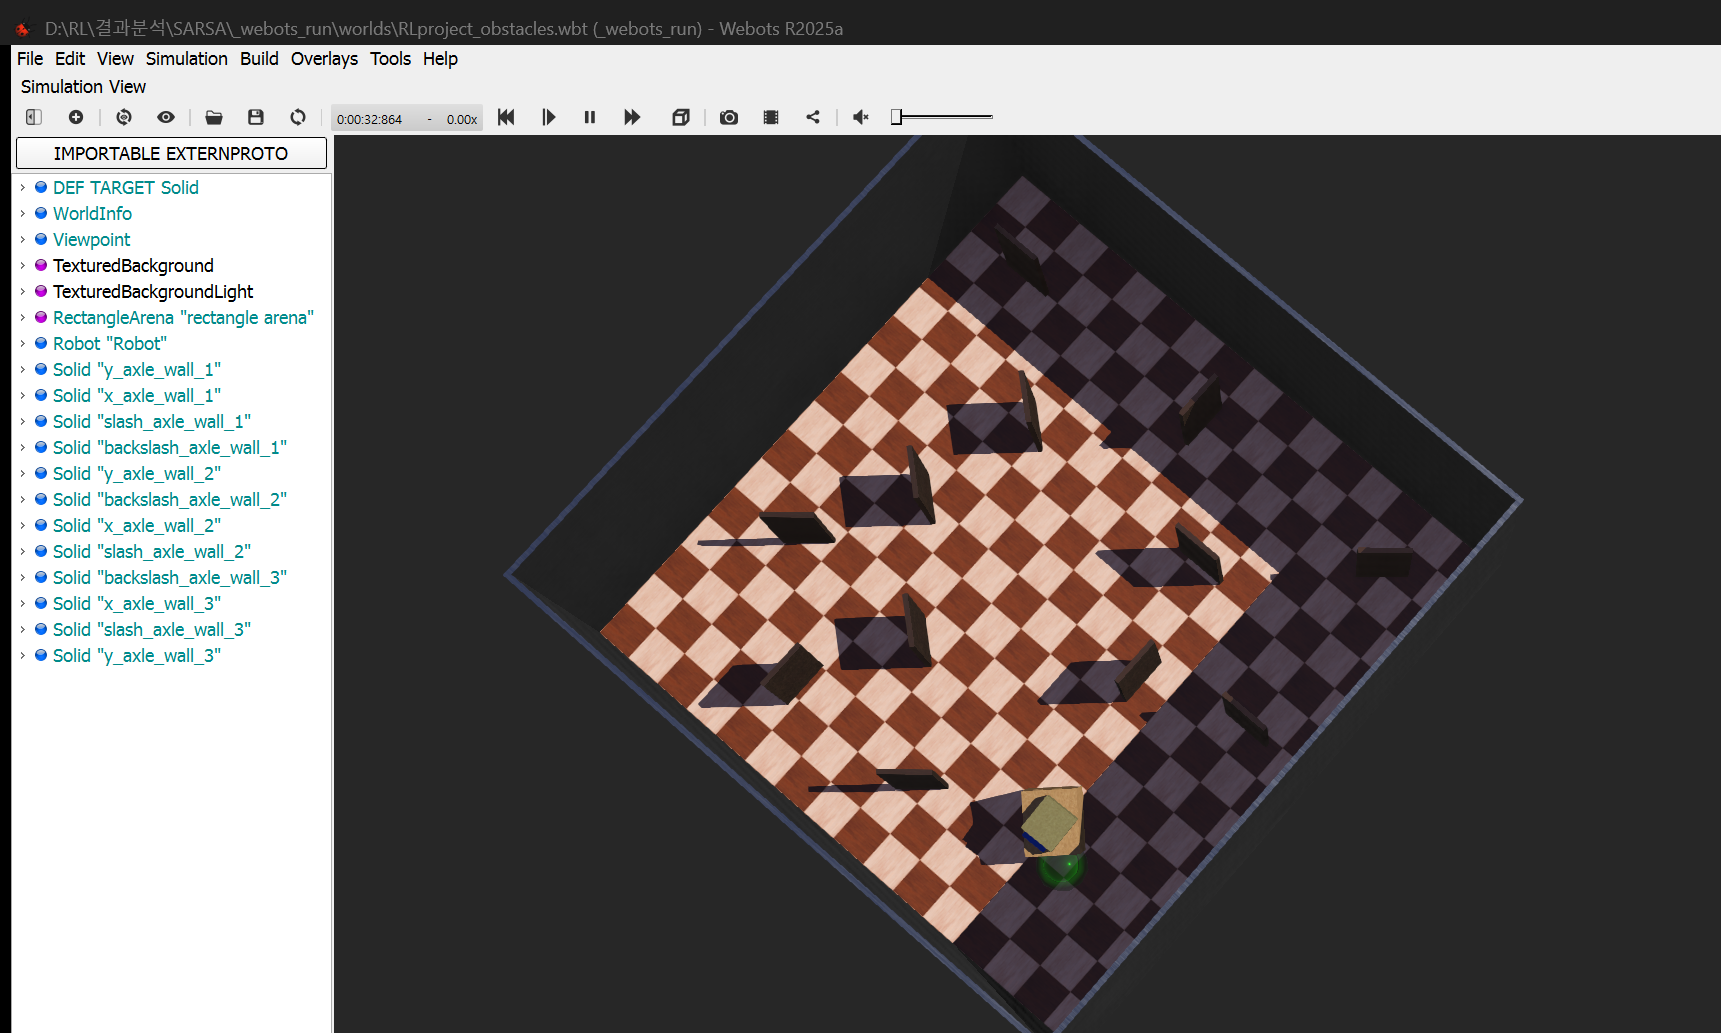
En este proyecto, aplicamos Q-Learning Tabular clásico (Off-policy TD(0)) a un robot móvil en el motor de física 3D Webots, con el objetivo de obtener una política de navegación y evasión de obstáculos verificable matemáticamente en un cuadrilátero interior de 1.2m × 1.2m.
2. Arquitectura del Sistema (Webots ↔ Python IPC)
El sistema está dividido en dos niveles: el servidor de simulación Webots y el cliente de aprendizaje por refuerzo en Python.
flowchart LR
    subgraph Webots["Simulador 3D Webots (localhost:5000)"]
        Robot["Robot Supervisor<br>(Sensor ultrasónico + ruedas)"]
        HeadScan["Mecanismo Head-Scan<br>(Servo rotación izq/der 1.1 rad)"]
        Server["Servidor Socket TCP<br>(JSON delimitado por líneas)"]
        Robot -→ HeadScan -→ Server
    end

    subgraph Python["Motor RL en Python (Cliente)"]
        Env["WebotsEnv (estilo gym)<br>reset() / step()"]
        Disc["Discretizador<br>(Valores continuos → Bins 0~647)"]
        Agent["QLearningAgent<br>(Tabla Q 648x4)"]
        Env -→ Disc -→ Agent
    end

    Server <-→|"petición: {type: step, action: 0..3}<br>respuesta: {state: [...], reward, done}"| Env
- Controlador Webots (
RL_controller.py): Ejecuta acciones durante 480 ms (15 pasos de simulación × 32 ms) y gira el sensor ultrasónico montado en la cabeza hacia la izquierda y la derecha en 1.1 rad ($\approx 63°$) para eliminar puntos ciegos. - Protocolo de Sockets: JSON delimitado por líneas sobre TCP localhost:5000 para minimizar la sobrecarga.
3. Discretización de Sensores Continuos en 648 Estados
Para aplicar Q-Learning tabular, las variables continuas se asignan a 5 factores clave:
| Variable de Observación | Bins | Umbrales (Thresholds) | Significado Físico |
|---|---|---|---|
Distancia al objetivo (goal_distance) | 3 | [0.6m, 1.2m] | Cerca (Near), Medio (Mid), Lejos (Far) |
Orientación relativa (goal_heading) | 8 | [-π, π] (8 sectores de 45°) | Frente, Frente-Der, Der, Atrás-Der, Atrás, Atrás-Izq, Izq, Frente-Izq |
Obstáculo frontal (front_distance) | 3 | [0.15m, 0.30m] | Peligro/Inminente, Precaución, Seguro |
Obstáculo izquierdo (left_distance) | 3 | [0.15m, 0.30m] | Peligro, Precaución, Seguro |
Obstáculo derecho (right_distance) | 3 | [0.15m, 0.30m] | Peligro, Precaución, Seguro |
Número total de estados: N_estados = 3 × 8 × 3 × 3 × 3 = 648
La tabla Q resultante contiene solo 648 × 4 = 2,592 parámetros, permitiendo actualizaciones en submilisegundos en memoria sin requerir GPU.
4. Mecanismo Head-Scan y Criterios de Finalización
- Ejecución del paso: Motores a 3.0 rad/s durante 480 ms.
- Rotación de la cabeza: Barrido a +1.1 rad para medir distancia izquierda, luego -1.1 rad para distancia derecha.
- Centrado: Regreso a 0 rad para refrescar distancia frontal.
- Condiciones de fin de episodio:
- Objetivo alcanzado: Distancia euclidiana ≤ 0.10m → Éxito (
done = True, recompensa $+1.0$). - Colisión con pared: Cualquier distancia ≤ 0.08m → Fallo (
done = True, recompensa $-1.0$).
- Objetivo alcanzado: Distancia euclidiana ≤ 0.10m → Éxito (
5. Próximos Pasos
Con el entorno de Webots, la interfaz IPC por sockets TCP y la discretización en 648 estados listos, el robot puede comenzar su aprendizaje.
En el episodio #2, abordaremos la implementación matemática de Tabular Q-Learning, la política de exploración ε-greedy con decaimiento y el ajuste de la función de recompensa!