Stanford CS329A (Ep 11): Agent Memory — MemGPT, Cartridges, CacheBlend y Arquitectura de Contexto Jerárquico

Cuando los desarrolladores despliegan agentes de IA autónomos como colaboradores de ingeniería a largo plazo, se topan invariablemente con tres cuellos de botella arquitectónicos críticos:
- "El agente olvida por completo decisiones arquitectónicas fundamentales acordadas en la sesión de ayer."
- "Introducir una base de código de 100.000 líneas en una ventana de contexto de un millón de tokens provoca una severa degradación de atención (el fenómeno Lost-in-the-Middle) e incrementa los costos a miles de dólares."
- "Al combinar múltiples fragmentos de documentos (chunks) en sistemas RAG, se invalidan los cachés prefijo de clave-valor (KV), disparando el tiempo hasta el primer token (TTFT) a varios segundos."
La cognición humana resuelve este desafío con extrema elegancia: el cerebro biológico posee una memoria de trabajo severamente limitada (de 4 a 7 fragmentos discretos), pero recupera instantáneamente recuerdos de hace décadas y fusiona conocimientos multidisciplinarios sin parálisis cognitiva.
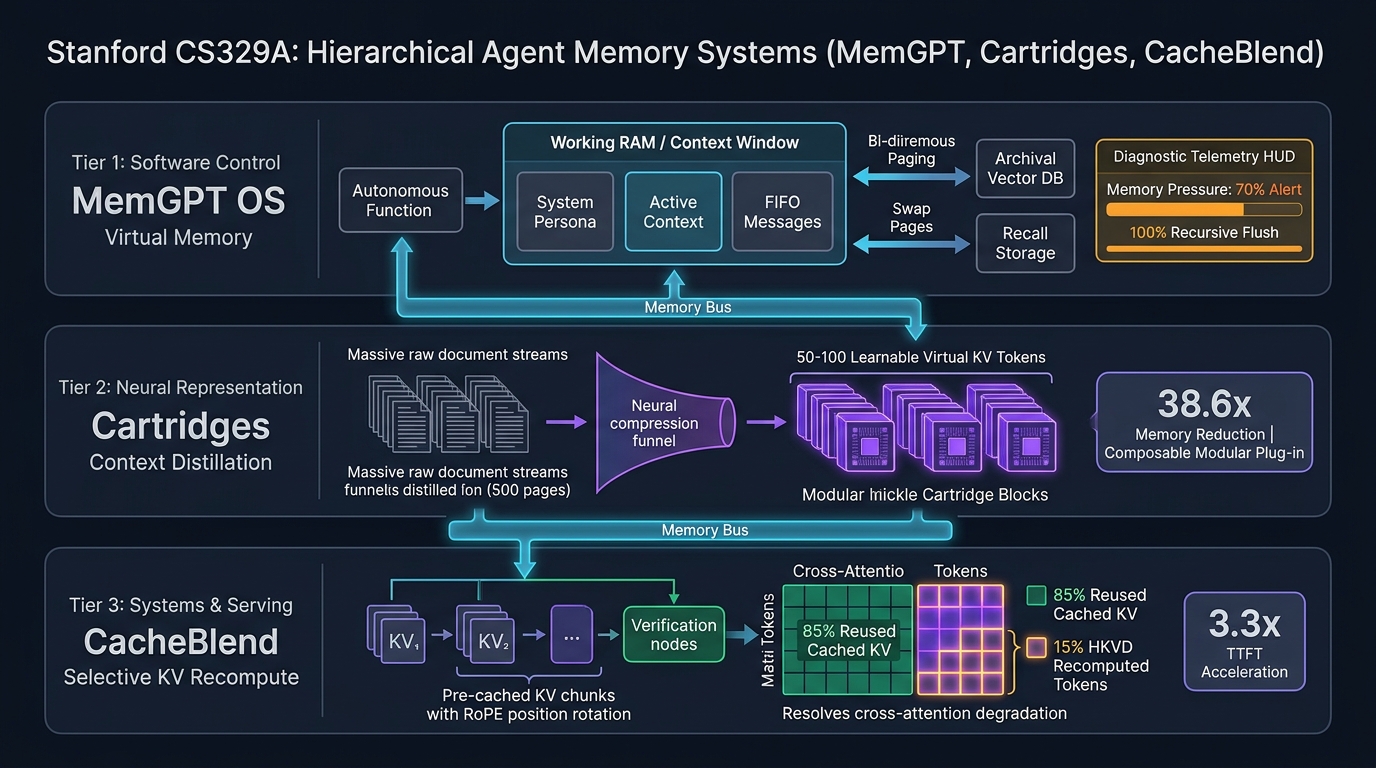
En esta entrega de la Parte 3: Ingeniería de Agentes de Stanford CS329A: Self-Improving AI Agents, exploramos la Agent Memory Architecture — cómo la inteligencia artificial moderna otorga memoria persistente y jerárquica a través de tres capas de abstracción fundamentales:
- Capa de Control de Software (MemGPT, UC Berkeley 2023): Paginación de memoria virtual jerárquica inspirada en sistemas operativos.
- Capa de Representación Neuronal (Cartridges, 2025): Destilación de contexto por autoaprendizaje (Self-Study) que comprime extensos documentos en vectores KV continuos modulares.
- Capa de Infraestructura de Sistemas (CacheBlend, EuroSys 2025): Recálculo selectivo de caché KV que restaura la atención cruzada y reduce la latencia RAG en un factor de 3.3x.
1. El Dilema del Contexto a Largo Plazo y la Memoria Jerárquica
Ampliar por la fuerza bruta la ventana de contexto de un LLM (por ejemplo, de 8k a más de 1M de tokens) no resuelve la memoria del agente. De hecho, introduce graves fallas termodinámicas y algorítmicas:
- Dispersión de Atención y Pérdida Intermedia (Lost-in-the-Middle): La autoatención del transformador aplana su distribución en contextos masivos, ignorando detalles sutiles situados en el centro de las consultas.
- Inviabilidad Económica: Reenviar cientos de miles de tokens en cada turno de diálogo agota los presupuestos computacionales de forma exponencial.
- Volatilidad Estática: Al cerrarse una sesión, las activaciones transitorias desaparecen; el agente no puede actualizar autónomamente su estado interno sin intervención externa.
Para garantizar autonomía continua, los sistemas avanzados desacoplan el Contexto de Trabajo (Working Context) del Almacenamiento a Largo Plazo (Long-Term Storage) mediante una gestión estructurada de Hierarchical Context Management.
┌─────────────────────────────────────────────────────────────────────────┐
│              Las 3 Capas de Abstracción de Memoria para Agentes         │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│ Capa Control de Software │  │Capa Representac. Neuronal│  │  Capa de Infraestructura │
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Paginación virtual SO  │  │ • Destilación Self-Study │  │ • Fusión de chunks RAG   │
│ • Contexto central (RAM) │  │ • Embeddings KV continuos│  │ • Recálculo selectivo 15%│
│ • DB vectorial (Disco)   │  │ • Reducción memoria 38.6x│  │ • Matriz rotacional RoPE │
│ • Desalojo y resumen rec.│  │ • Aumento débit 26.4x    │  │ • Caída 3.3x latencia TTFT│
│ • Recuerdo profundo 92%  │  │ • Modularidad tipo Lego  │  │ • Error de precisión <0.01│
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Capa de Control de Software: MemGPT (UC Berkeley 2023)
Los sistemas operativos dominaron las limitaciones de memoria hace décadas. Un SO moderno proporciona la ilusión de memoria infinita intercambiando páginas de memoria virtual entre la DRAM física y discos de almacenamiento masivo a través de la Unidad de Gestión de Memoria (MMU).
Desarrollado por Packer et al. en UC Berkeley, MemGPT Long-Term Memory traslada este principio clásico a los agentes de lenguaje:
"La ventana de contexto del LLM es la memoria física RAM. Las bases de datos vectoriales y registros SQL externos son el disco duro. Al dotar al modelo de primitivas de llamada a funciones para inspeccionar, editar, desalojar y recuperar información, el agente se convierte en su propio sistema operativo."
    ┌────────────────── [Main Context (RAM: Límite de 8k~128k Tokens)] ──────────────┐
    │ 1. System Instructions : Manual de identidad y gestión de memoria (Solo Lect.) │
    │ 2. Working Context     : Hechos estáticos, perfil de usuario y persona (L/E)   │
    │ 3. FIFO Message Queue  : Diálogo reciente + Bloque de Resumen Recurrente       │
    └────────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
                (Swap-In / Search)                    │ (Swap-Out / Evict & Flush)
                               │                      ▼
    ┌───────────────── [External Context (Disco: Almacenamiento Ilimitado)] ────────┐
    │ 1. Recall Storage   : Historial completo de mensajes con marcas de tiempo      │
    │ 2. Archival Storage : Repositorio profundo de documentos y embeddings (HNSW)   │
    └────────────────────────────────────────────────────────────────────────────────┘
Mecánica de Paginación Autónoma
En lugar de que scripts externos recorten el historial de forma arbitraria, el modelo administra su propia memoria:
- Alerta de Presión de Memoria (Umbral del 70%): Cuando el diálogo ocupa el 70% de la ventana activa, el sistema genera una interrupción silenciosa:
"Alerta: Ventana al 70% de capacidad. Revise el historial reciente y guarde los hechos críticos en
working_contextantes del desalojo." - Resumen Recurrente y Desalojo (Vaciado al 100%):
- Al llegar al 100%, el gestor de la cola FIFO extrae el 50% de los mensajes más antiguos.
- En lugar de eliminarlos, MemGPT ejecuta una rutina de Resumen Recurrente, combinando el resumen histórico existente con los nuevos tokens desalojados para crear un bloque condensado al inicio de la cola.
- Los mensajes originales se transfieren a la base permanente
Recall Storage.
- Recuerdo Autónomo mediante Heartbeat:
- Si el usuario pregunta por un dato de hace meses, el modelo ejecuta
recall_storage.search()y activarequest_heartbeat=true. Esto encadena llamadas de herramientas de manera autónoma, trayendo registros del disco a la RAM antes de emitir la respuesta final.
- Si el usuario pregunta por un dato de hace meses, el modelo ejecuta
Resultados en Benchmarks: Recuerdo Profundo (DMR)
En el benchmark de Deep Memory Recall (DMR) a través de decenas de sesiones conversacionales:
- GPT-4 estándar con ventana estática cayó a un 32.1% de precisión.
- MemGPT alcanzó un 92.5% de precisión, sin sufrir degradación a lo largo de las sesiones.
- En pruebas de recuperación anidada de clave-valor (Nested KV Retrieval), los modelos convencionales colapsaron al 0% a partir de 3 saltos, mientras que MemGPT mantuvo un 100% de consistencia.
3. Capa de Representación Neuronal: Cartridges (2025)
Aunque MemGPT gestiona la memoria eficientemente a nivel de tokens, transferir miles de palabras de texto sigue resultando costoso. Si un agente corporativo necesita consultar un informe financiero de 500 páginas o una biblioteca de código completa, procesar el texto crudo eleva drásticamente la latencia de prefill y el consumo de VRAM.
Presentado en 2025, el proyecto Cartridges Modular Agent Memory plantea un cambio de paradigma radical:
"¿Por qué mantener el conocimiento como texto voluminoso? ¿Y si un LLM pudiera estudiar un documento de 500 páginas fuera de línea (Self-Study) y destilarlo en 50 a 100 vectores de caché KV continuos y entrenables que se conecten al modelo como un cartucho físico?"
[Documento Extenso de 500 Páginas / Base de Código]
             │
             ▼ (Pipeline de Self-Study)
1. Síntesis de Diálogos Diversos (Resumen, Preguntas Profundas, Casos de Uso)
             │
             ▼
2. Destilación de Contexto mediante Divergencia KL:
   Modelo Profesor (Documento completo de 500 pág. + Consulta) ──► P_Profesor(y)
                                                                     │ (Pérdida D_KL)
   Modelo Alumno (Cartucho Z [50 tokens KV] + Consulta) ────────► P_Alumno(y)
             │
             ▼
[Cartucho Z Plug-and-Play (50~100 Vectores KV Continuos)]
(Compresión de Memoria 38.6x, Aceleración de Débito 26.4x, Modularidad Total)
Por qué Fracasa la Predicción del Siguiente Token (NTP)
Cuando los investigadores intentaron entrenar los vectores KV mediante la clásica Predicción del Siguiente Token (NTP), el modelo cayó en el "Síndrome de Memorización Literal":
- Podía recitar párrafos enteros al pie de la letra.
- Sin embargo, al formularle preguntas conceptuales o analíticas sobre el contenido, la precisión colapsaba a cero. El modelo retenía la sintaxis superficial, pero no el significado semántico.
Arquitectura de Self-Study y Destilación de Contexto
Para solucionar este escollo, los autores estructuraron un proceso de dos fases:
- Generación Sintética de Diálogos: El modelo genera miles de pares de preguntas y respuestas sobre el documento en cinco arquetipos: esquemas estructurales, dilemas analíticos, pruebas de límites y aplicaciones prácticas.
- Destilación de Contexto:
- Modelo Profesor: Recibe las 500 páginas completas en el contexto y emite la distribución objetivo
P_Teacher(y | Doc, x). - Modelo Alumno: Recibe únicamente los parámetros del cartucho $Z$ (50-100 tokens virtuales KV) junto con la consulta $x$.
- Los pesos de $Z$ se actualizan mediante descenso de gradiente minimizando la Divergencia Kullback-Leibler (KL):
- Modelo Profesor: Recibe las 500 páginas completas en el contexto y emite la distribución objetivo
========================================================================================
Formulación de Pérdida de Destilación para Cartuchos:
========================================================================================
min_Z  Σ  D_KL( F( · | Documento ⊕ x )  ||  F_Z( · | x ) )

Donde:
  • F( · | Documento ⊕ x ) : Logits del modelo Profesor con contexto completo
  • F_Z( · | x )          : Logits del modelo Alumno condicionado solo por Cartucho Z
  • Z                     : Tensores de caché KV continuos inyectados en las capas
========================================================================================
Resultados Empíricos y Modularidad Tipo Lego
- Reducción de Memoria de 38.6x: En evaluaciones de contexto extenso (LongHealth y QASPER), Cartridges igualó la precisión del modelo completo consumiendo 38.6 veces menos memoria.
- Incremento de Rendimiento de 26.4x: Al eliminar miles de tokens de la fase de prefill, el rendimiento de inferencia aumentó en 26.4 veces.
- Composabilidad Modular Inmediata: Los cartuchos son modulares. Al conectar simultáneamente un Cartucho del informe 10-K de AMD y un Cartucho de PepsiCo, el agente realizó análisis comparativos financieros complejos sin necesidad de reentrenamiento conjunto.
4. Capa de Infraestructura de Sistemas: CacheBlend (EuroSys 2025)
Al profundizar en la infraestructura de computación, encontramos cuellos de botella severos en sistemas RAG y agentes multi-herramienta.
Cuando un agente recupera 10 fragmentos de documentos independientes para responder a un usuario, los motores de servicio actuales enfrentan un conflicto insalvable:
- Prefix Caching (vLLM): Solo el primer fragmento reutiliza la caché previa. Si el orden de los fragmentos cambia, toda la caché descendente queda invalidada, forzando un recálculo total (prefill de 3 a 6 segundos).
- Concatenación Simple de Caché (PromptCache): Precomputar cada fragmento de forma aislada y unirlos directamente ignora la Atención Cruzada (Cross-Attention) entre fragmentos, lo que degrada la precisión de razonamiento hasta en un 50%.
Presentado en EuroSys 2025, CacheBlend KV Cache Merging resuelve este dilema mediante Recálculo Selectivo de KV (Selective KV Recompute):
[Cachés KV Precalculadas de Fragmentos de Documentos A, B y C]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              Pipeline de Recálculo Selectivo Capa por Capa              │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Identificar el 15% Superior de Tokens de Alta Desviación (HKVD)      │
│ 2. Recalcular la Atención ÚNICAMENTE para ese 15% Crítico               │
│ 3. Combinar Directamente el 85% Restante desde la Caché Almacenada      │
│ 4. Aplicar Matriz de Rotación RoPE para Ajustar Coordenadas Absolutas   │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Prefill Ultra-Rápido: TTFT 3.3x Menor, Pérdida de Precisión ΔF1 < 0.01]
El Hallazgo de la Dispersión de Atención
Al examinar las matrices de atención en fragmentos concatenados, los autores descubrieron un fenómeno matemático determinante:
"Al ensamblar múltiples fragmentos de texto en una consulta, menos del 15% de los tokens experimentan alteraciones significativas en sus pesos de atención por la presencia de fragmentos vecinos. Más del 85% de los tokens permanecen prácticamente invariantes."
- Detección de Tokens de Alta Desviación (HKVD): En cada capa, CacheBlend selecciona dinámicamente el 15% de tokens con mayor divergencia cruzada y recalcula únicamente sus estados.
- Ocultación de Latencia por Superposición: Mientras la GPU ejecuta el recálculo del 15% (lo cual toma ~2 ms), un hilo asíncrono de E/S transfiere los tensores de la siguiente capa desde unidades SSD NVMe a la VRAM, ocultando completamente el tiempo de cálculo tras la transferencia.
- Ajuste de Coordenadas RoPE: Concatenar fragmentos altera sus posiciones relativas. CacheBlend aplica una matriz de rotación de Givens 2D a las claves precalculadas, corrigiendo sus coordenadas en microsegundos sin reevaluar la atención.
Métricas de Rendimiento
- Latencia TTFT Reducida en 3.3x: El tiempo para emitir el primer token cayó de 3.450 ms a 1.050 ms en consultas RAG multi-documento.
- Débito del Sistema 5x Mayor: Los clústeres de GPU multiplicaron por 5 las consultas simultáneas atendidas.
- Preservación Total de Exactitud: Frente al recálculo integral, CacheBlend mantuvo una discrepancia de F1 inferior a 0.01.
5. Comparativa Arquitectónica de Paradigmas de Memoria
=============================================================================================================
Dimensión             MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
Capa de Abstracción   Control Software / Paginación Representación Neuronal       Infraestructura de Servicio
Unidad Principal      Tokens de Texto y JSON        Vectores KV Continuos         Tensores KV Precalculados
Capacidad Máxima      Ilimitada (DB Externa)        50-100 Tokens por Documento   RAG Dinámico Multi-Fragmento
Mecanismo de Cambio   Llamadas a Función y Resumen  Destilación Self-Study (KL)   Recálculo Selectivo (15% HKVD)
Impacto en Hardware   Evita Desbordamiento Contexto Reduce Huella VRAM en 38.6x   Reduce Latencia TTFT en 3.3x
Composabilidad        Consultas Relacionales        Apilamiento Matricial Modular Rotación Angular RoPE
=============================================================================================================
6. Preguntas y Respuestas Técnicas (Q&A)
P1: ¿Cómo sabe MemGPT autónomamente CUÁNDO consultar la memoria externa sin intervención humana?
MemGPT opera a través de un contrato cognitivo explícito insertado en las Instrucciones del Sistema (System Instructions) en la parte superior del contexto:
"Eres una inteligencia autónoma dotada de memoria a largo plazo. Ante consultas sobre eventos pasados o preferencias del usuario ausentes en tu contexto de trabajo, NO debes adivinar ni manifestar incapacidad. DEBES invocar primero
recall_storage.search()oarchival_storage.search()."
Cuando el modelo detecta la carencia de información, las capas de atención priorizan la generación del JSON de llamada a herramienta por encima de una disculpa textual. Al retornar el flag request_heartbeat=true, el sistema inyecta el resultado de la búsqueda de inmediato en el contexto, completando un ciclo de recuperación continuo y autónomo.
P2: ¿Por qué la concatenación de fragmentos KV independientes no distorsiona las posiciones RoPE?
En esquemas antiguos de incrustación posicional absoluta, mover un token del índice 0 al 500 obligaba a recalcular toda la secuencia.
Sin embargo, RoPE (Rotary Position Embedding) codifica las posiciones mediante rotaciones en planos 2D:
K_nuevo = R_Theta(p_nuevo - p_antiguo) * K_cache
Debido a que el producto interno depende exclusivamente de la distancia relativa $(m - n)$, CacheBlend traslada un token almacenado desde p_{antiguo} hacia p_{nuevo} simplemente multiplicando el vector clave por la matriz rotacional delta correspondiente. Esta operación se ejecuta en microsegundos y preserva con exactitud el rigor matemático sin modificar los parámetros del modelo.
Resumen y Próxima Lección
La verdadera autonomía de los agentes no puede prosperar sobre un contexto volátil y olvidadizo. A través de MemGPT, comprendimos cómo la paginación de sistemas operativos confiere un horizonte cognitivo ilimitado. Con Cartridges, vimos cómo la destilación vectorial comprime bibliotecas enteras en módulos ligeros y combinables. Mediante CacheBlend, demostramos que el recálculo selectivo acelera la entrega del primer token en un factor de 3.3x.
En la Clase 12, cerraremos la Parte 3 (Ingeniería de Agentes) abordando el estándar definitivo para medir la inteligencia artificial autónoma: Agent Evaluation & Long Tasks: Evaluación de Tareas de Larga Duración y Benchmarks de Valor Económico (Measuring Long Tasks, GDPVal, DeepScholar-Bench).
Puntos Clave
- Desacoplamiento Jerárquico: La memoria debe dividirse en RAM de trabajo ágil (prompt activo) y almacenamiento en disco de gran capacidad (Recall y Archival).
- Destilación Continua frente a Texto Plano: Comprimir documentos en Cartridges reduce el consumo de memoria en 38.6x manteniendo la capacidad de ensamblaje modular.
- Prefill Instantáneo por Dispersión de Atención: En consultas RAG, recalcular únicamente el 15% de tokens divergentes disminuye la latencia TTFT en 3.3x con precisión intacta.