Stanford CS329A (Ep 12): Agent Evaluation & Long Tasks — Horizontes METR, OpenAI GDPval y DeepScholar-Bench

Cuando un equipo de ingeniería desarrolla un agente de programación autónomo y lo presenta a directores ejecutivos o inversores, afirmar que "obtuvo un 92% en el examen MMLU" genera una indiferencia total. Las preguntas que surgen en el mundo empresarial son mucho más concretas e implacables:
- "¿Puede este agente autónomo resolver una tarea compleja de varias horas de duración sin intervención humana continua?"
- "Si un ingeniero sénior tarda 8 horas en implementar una refactorización de código crítica o un análisis financiero, ¿puede el agente entregar una calidad comparable? ¿Y cuál es su valor económico neto en dólares reales?"
Los puntos de referencia tradicionales de opción múltiple (MMLU, GSM8K, HumanEval) están completamente saturados por encima del 90% y comprometidos por la contaminación de datos en la web. Pero, por encima de todo, acertar una pregunta de 5 segundos es radicalmente distinto a resolver Long-Horizon Agent Tasks que exigen cientos de decisiones secuenciales con estado a lo largo de varias horas.
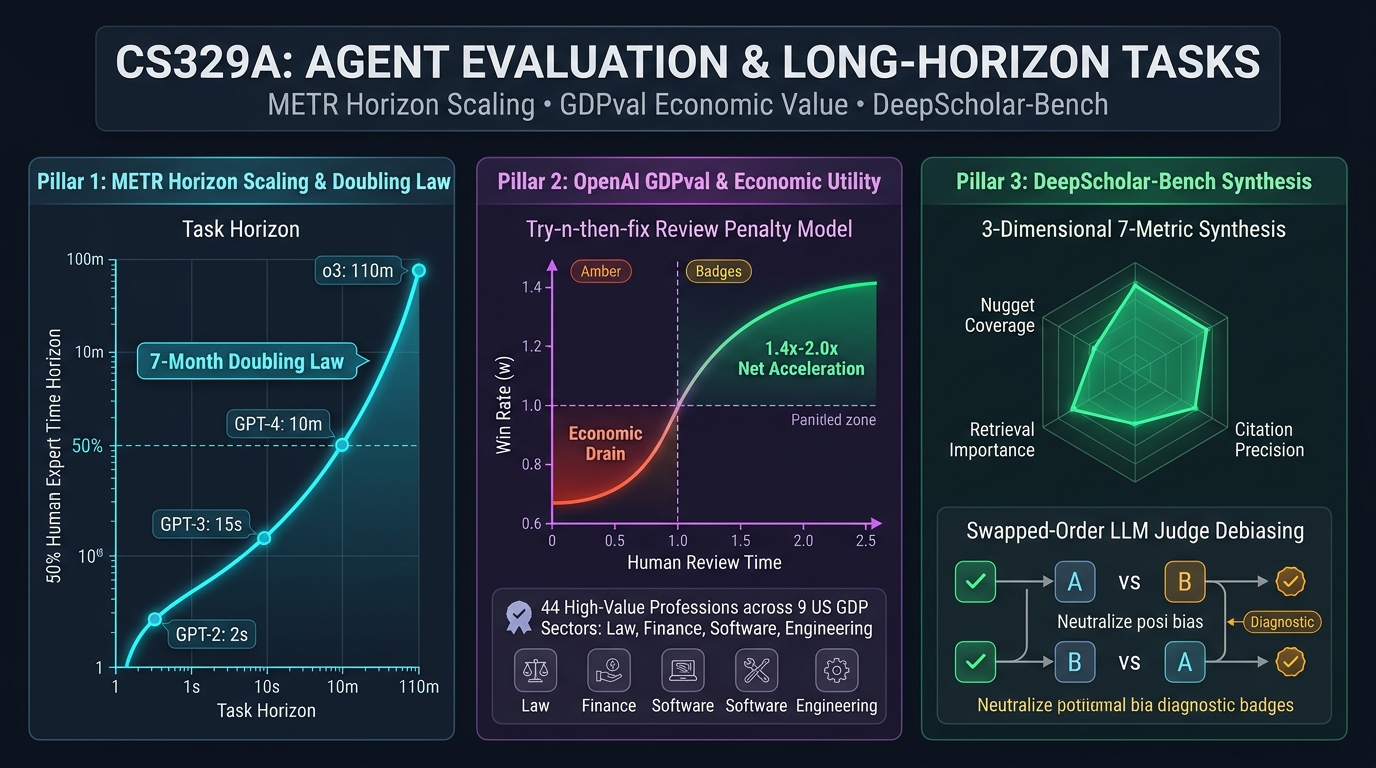
En este cierre de la Parte 3: Ingeniería de Agentes (Lecciones 10 a 12) de Stanford CS329A: Self-Improving AI Agents, profundizamos en la ciencia moderna de los Agent Evaluation Benchmarks — midiendo la inteligencia no mediante porcentajes arbitrarios, sino en unidades físicas de Tiempo Humano y Dólares Económicos ($):
- Escala de Tiempo Humano (METR, 2025): El horizonte de tiempo de éxito al 50% (h_agent) y la ley empírica de duplicación cada 7 meses.
- Valor Económico en el Mundo Real (OpenAI GDPval, 2025): Evaluación de 44 profesiones en los 9 sectores clave del PIB de EE. UU. y la matemática del costo de revisión humana "Try-n-then-fix".
- Evaluación Científica sin Contaminación (DeepScholar-Bench, 2025): Evaluación tridimensional en 7 métricas y eliminación del sesgo posicional en jueces LLM.
1. La Crisis de Evaluación: Por qué Fracasaron las Pruebas de Opción Múltiple
Durante cinco años, la comunidad de IA dependió de conjuntos de datos estáticos de preguntas y respuestas. Sin embargo, evaluar agentes autónomos en producción dejó al descubierto fallas estructurales insalvables:
- Saturación y Contaminación: Los modelos de frontera superaron con creces el 90% en MMLU porque memorizaron los exámenes durante el preentrenamiento en la web.
- Cero Horizonte Temporal: Resolver una pregunta de 4 opciones toma 2 segundos y 1 paso. La ingeniería de producción exige mantener el estado coherente a lo largo de más de 100 llamadas consecutivas a herramientas.
- La Ilusión de la Limpieza: Los exámenes clásicos presentan enunciados prístinos. El trabajo real es inherentemente "sucio" (Task Messiness): requisitos ambiguos, estados dinámicos de red, registros crípticos y acciones destructivas irreversibles.
Por estas razones, los principales laboratorios han descartado los exámenes convencionales en favor de mediciones físicas rigurosas.
┌─────────────────────────────────────────────────────────────────────────┐
│               Los 3 Pilares de la Evaluación Moderna de Agentes         │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│   Horizontes METR        │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Unidad: Tiempo humano  │  │ • Unidad: Dólares reales │  │ • Unidad: Vector 7 métric│
│ • Horizonte al 50% h     │  │ • 44 Profesiones de alto │  │ • Ingesta semanal arXiv  │
│ • Duplicación en 7 meses │  │ • Ecuación Try-n-then-fix│  │ • Cero contaminación     │
│ • Penalización Messiness │  │ • Jueces veteranos 14 a. │  │ • Cobertura Nuggets 39%  │
│ • 2s (GPT-2) -> 110m (o3)│  │ • Umbral de victoria 40% │  │ • Desesgo orden invertido│
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Medir la Inteligencia en Unidades de Tiempo: METR (2025)
Decir que un modelo alcanza el 88% no aporta ninguna información sobre su autonomía temporal. El laboratorio de investigación METR (Model Evaluation and Threat Research) revolucionó la evaluación al calibrar la capacidad sobre el eje del tiempo humano:
"Abandonen los puntajes porcentuales. En su lugar, midan la probabilidad de que un agente complete una tarea que le toma a un profesional humano un tiempo $t$. Definan la inteligencia por el Horizonte Temporal al 50% (h_agent): la duración de la tarea humana que el modelo resuelve con un 50% de éxito."
    [170 Tareas de Ingeniería de Software y ML (Segundos a 8 Horas)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [Tiempo Humano Estándar t]     [Tasa de Éxito del Agente p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [Regresión Logística basada en Teoría de Respuesta al Ítem (IRT)]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [Horizonte Temporal al 50% h_agent: GPT-2 (2s) ──► OpenAI o3 (110m)]
Formulación Logística del Horizonte Temporal
Inspirándose en la Teoría de Respuesta al Ítem (IRT), METR modela la probabilidad de éxito $p$ como una función del tiempo humano de la tarea t_task y la capacidad temporal del agente h_agent:
========================================================================================
Ecuación de Probabilidad de Éxito según el Horizonte Temporal de METR:
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

Donde:
  • t_task  : Tiempo medio que le toma a un experto humano resolver la tarea
  • h_agent : Horizonte temporal al 50% del agente (si t_task = h_agent, p = 0.5)
  • β_agent : Parámetro de pendiente que refleja la caída de éxito con la dificultad
  • σ(z)    : Función sigmoide logística 1 / (1 + exp(-z))
========================================================================================
La Ley de Duplicación cada 7 Meses
Al analizar 16 modelos de frontera entre 2019 y 2025, se reveló una tendencia exponencial asombrosa:
- 2019 (GPT-2): Horizonte de 2 segundos (autocompletado básico).
- 2021 (GPT-3): Horizonte de 15 segundos.
- 2023 (GPT-4): Horizonte de 10 minutos.
- 2025 (OpenAI o3): Horizonte de 110 minutos (~2 horas).
- Tendencia Estadística: El horizonte temporal de éxito al 50% se duplica exactamente cada 7 meses (207 días).
- Proyección: De continuar esta tendencia, entre 2028 y 2030 los agentes alcanzarán un horizonte de éxito al 50% en tareas que demandan un mes completo (160 horas) de trabajo experto humano ininterrumpido.
3. Medir el Valor Económico Real: OpenAI GDPval (2025)
Si METR calibró el tiempo, el benchmark GDPval de OpenAI midió el capital financiero.
OpenAI seleccionó 44 ocupaciones digitales de altos ingresos dentro de los 9 sectores clave del PIB de EE. UU. (finanzas, derecho, ingeniería, software, etc.). Contrataron a especialistas con un promedio de 14 años de experiencia en la industria para diseñar 220 tareas profesionales rigurosas (modelos DCF, análisis de patentes, scripts de procesamiento de datos):
- Tiempo medio de realización humana: 9.5 horas (mediana de 5 horas).
- Costo promedio de mercado por tarea: $398 USD (~550.000 KRW).
Tasas de Victoria Ciegas frente a Especialistas Humanos
Profesionales sénior evaluaron a ciegas las entregas de los modelos comparándolas con las de colegas humanos:
- GPT-4o: Tasa de victoria del 12.5% (muy lejos del estándar profesional).
- OpenAI o3: Tasa de victoria del 35.2%.
- Claude Opus 4.1: Tasa de victoria del 47.6% (Ganó o Empató).
- Los modelos de razonamiento contemporáneos ya entregan resultados que evaluadores expertos consideran indistinguibles o superiores a los humanos en casi la mitad de los casos.
La Falacia de la Velocidad y la Ecuación del Costo de Revisión
Muchos afirman: "¡El agente terminó en 2 minutos lo que tomaba 9 horas, es 270 veces más rápido!" GDPval desmiente esto formalizando la Penalización por Revisión y Corrección Humana (Try-n-then-fix):
========================================================================================
Ecuación Económica de Costo Temporal Real (Try-n-then-fix):
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

Donde:
  • M_T : Tiempo de generación de la máquina (minutos)
  • R_T : Tiempo de revisión minuciosa del humano para auditar el borrador
  • H_T : Tiempo base en que el humano hace todo desde cero tras un fallo
  • w   : Tasa de victoria del modelo (probabilidad de que el borrador sea apto)
  • n   : Intentos permitidos al agente antes de que el humano desista y lo haga él
========================================================================================
El Umbral de Rentabilidad Económica
- Cuando la calidad es baja ($w < 20%$, ej. GPT-4o), el especialista pierde horas auditando errores sutiles para finalmente descartar el borrador y rehacerlo todo. Por consiguiente, incorporar GPT-4o produjo una ralentización del 13% (0.87x respecto al ritmo humano).
- Solo al cruzar el umbral crítico de $w \ge 40%$ (alcanzado por o3 y Opus 4.1) se amortiza el costo de auditoría, generando una auténtica aceleración de productividad de 1.3x a 1.4x.
4. Evaluación Científica sin Contaminación: DeepScholar-Bench (2025)
¿Cómo evaluar agentes de investigación profunda en tareas abiertas donde no existe una única respuesta correcta?
Presentado en agosto de 2025, DeepScholar-Bench diseñó un pipeline en vivo que ingesta artículos semanales recién subidos a arXiv, eliminando de raíz cualquier posibilidad de contaminación de datos previa.
       [Ingesta Semanal Continua de arXiv (Garantía de Cero Contaminación)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               Pila Tridimensional de 7 Métricas de DeepScholar-Bench    │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Síntesis de Conocimiento (Knowledge Synthesis)                       │
│    • Organización y Coherencia (Estructura lógica, claridad y prosa)    │
│    • Cobertura de Nuggets (Porcentaje de hechos atómicos esenciales)    │
│ 2. Calidad de Búsqueda (Retrieval Quality)                              │
│    • Tasa de Relevancia (Afinidad de los artículos citados con el tema) │
│    • Importancia Documental (Capacidad de citar papers seminales clave) │
│ 3. Verificabilidad (Verifiability)                                      │
│    • Precisión de Citas (Verificación de que el texto respalda la fuente)│
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
     [Juez LLM con Inversión de Orden: Eliminación del Sesgo Posicional]
El Baño de Realidad del 30.9%
Incluso modelos punteros de investigación como OpenAI DeepResearch lograron una puntuación media geométrica de apenas 30.9% en las 7 métricas:
- Elocuencia Superficial vs Cobertura Profunda: Los agentes obtuvieron notas altas en redacción y formato (Organization: 85.7%), pero fracasaron en capturar hechos atómicos vitales (Nugget Coverage: 39.2%) y en identificar literatura seminal crucial (Document Importance: 12.4%).
- El Experimento con Retriever Oráculo: Al proporcionar al modelo la lista perfecta de documentos a citar, la nota global solo ascendió al 49%. Esto prueba que el verdadero cuello de botella de los agentes de investigación no radica en buscar en la web, sino en sintetizar ideas complejas tras leer la literatura.
5. Matriz Comparativa de Benchmarks de Evaluación de Agentes
=============================================================================================================
Dimensión             METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
Métrica Principal     Tiempo Humano (Horas/Minutos) Valor Económico Neto ($ USD)  Vector Calidad de 7 Métricas
Ámbito Evaluado       Ingeniería Software y ML      44 Roles Digitales de NegociosSíntesis Académica Abierta
Tipo de Verdad Base   Suites de Pruebas Unitarias   Tasa de Victoria Ciega 14 a.  Nuggets de Información Atómica
Blindaje ContaminaciónTareas Privadas Air-Gapped    Casos de Negocio Confidenc.   Ingesta Dinámica Semanal arXiv
Costeo de Revisión    No Modelado (Paso/Fallo)      Ecuación Try-n-then-fix       Juez LLM con Orden Invertido
Cúspide Actual        o3: 110 Minutos (Éxito al 50%)Opus 4.1: 47.6% Victoria      DeepResearch: 30.9% Media Geom
=============================================================================================================
6. Preguntas y Respuestas Técnicas (Q&A)
P1: ¿Qué mide la "Complejidad/Suciedad de la Tarea" (Task Messiness) en METR y cómo afecta el rendimiento?
La métrica Task Messiness cuantifica 16 fricciones del mundo real ausentes en problemas de programación limpios:
- Entorno Dinámico: El sistema cambia mientras el agente opera (latencias de red, bloqueos en bases de datos).
- Acciones Irreversibles: Comandos destructivos (un
DROP TABLEerróneo o un push no autorizado) que impiden el retroceso simple (backtracking). - Búsqueda Activa: El agente no recibe los datos directamente; debe usar comandos de terminal y analizar logs para reconstruir el contexto.
Según los análisis de METR, por cada punto que aumenta la escala de suciedad de la tarea, la tasa de éxito del agente cae un 8.1% de forma directa. La superioridad de un agente radica en resistir este ruido ambiental, no solo en emitir sintaxis impecable.
P2: ¿Cómo elimina el "Promedio de Orden Invertido" (Swapped-Order) el sesgo posicional en los jueces LLM?
Al pedirle a un juez LLM que compare dos entregas $(A)$ y $(B)$, el modelo exhibe un marcado Sesgo Posicional, prefiriendo sistemáticamente la opción $(A)$ simplemente por ser presentada en primer lugar (con un sesgo basal del 60% al 70%).
Para cancelar algebraicamente este sesgo, DeepScholar-Bench aplica el Promedio de Orden Invertido (Swapped-Order Averaging):
- Pase 1: Se presentan las opciones como $(A, B)$ y se registra el vector de puntuación $S_1 = [s(A), s(B)]$.
- Pase 2: Se invierten las opciones como $(B, A)$ y se registra el vector $S_2 = [s(B), s(A)]$.
- Se calcula la media aritmética:
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
Al evaluar ambas permutaciones bajo idénticos parámetros de temperatura, la preferencia por el orden de lectura se cancela de forma matemática y exacta.
Conclusión y Cierre de la Parte 3
La Parte 3 (Ingeniería de Agentes) nos ha proporcionado una comprensión exhaustiva de los sistemas autónomos:
- En la Clase 10, exploramos la reparación de código con SWE-Agents y la optimización de GPU con KernelBench.
- En la Clase 11, conquistamos la memoria a largo plazo con MemGPT, Cartridges y CacheBlend.
- En la Clase 12, fundamentamos la utilidad de los agentes en magnitudes físicas: Tiempo Humano (METR) y Valor Económico (GDPval).
Ahora contamos con el arsenal de ingeniería completo para construir, desplegar, optimizar y medir sistemas autónomos avanzados.
Próxima Parada: Parte 4 · Las Fronteras
En la sección culminante de nuestro curso, Part 4 · Frontiers (Clases 13 a 17), nos adentraremos en el mayor desafío de la inteligencia artificial contemporánea: La Naturaleza del Razonamiento en Máquinas.
Inauguraremos la Parte 4 en la Clase 13 con: 《LLM Reasoning: Los Fundamentos del Razonamiento, Chain-of-Thought y Escalabilidad Cognitiva Emergente》, examinando las contribuciones fundamentales de Denny Zhou en Google DeepMind.
Conclusiones Principales
- Mida Tiempo, No Porcentajes: La métrica reina es el horizonte temporal al 50% de éxito (h_agent), que se ha duplicado cada 7 meses desde 2 segundos (GPT-2) hasta 110 minutos (o3).
- El Costo de Revisión Determina el ROI: Si un agente no supera un ~40% de tasa de victoria, el costo de auditoría humana deviene en pérdidas económicas.
- La Síntesis es la Frontera: En investigación abierta, recuperar enlaces es un problema resuelto; extraer y entrelazar hechos atómicos verificados sigue siendo el gran reto pendiente.