Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — Verificación formal, Lean 4, AlphaGeometry y Gemini Deep Think

En la lección anterior sobre Razonamiento en LLMs, analizamos cómo la técnica de Cadena de Pensamiento (Chain-of-Thought, CoT) y la decodificación por Autoconsistencia (Self-Consistency) encendieron la chispa del razonamiento causal multietapa en redes neuronales. Sin embargo, en fronteras críticas —como la verificación de protocolos criptográficos, software de control orbital o demostraciones matemáticas de élite mundial— el texto en lenguaje natural adolece de una debilidad intrínseca:
"Por más elocuente y convincente que parezca una cadena de razonamiento en lenguaje natural generada por un LLM, sigue siendo una secuencia estocástica de tokens probabilísticos. Un único error sutil de signo, una premisa circular o un lema alucinado desmorona por completo el sistema. En las matemáticas rigurosas, una demostración correcta al 99% equivale a una demostración correcta al 0%."
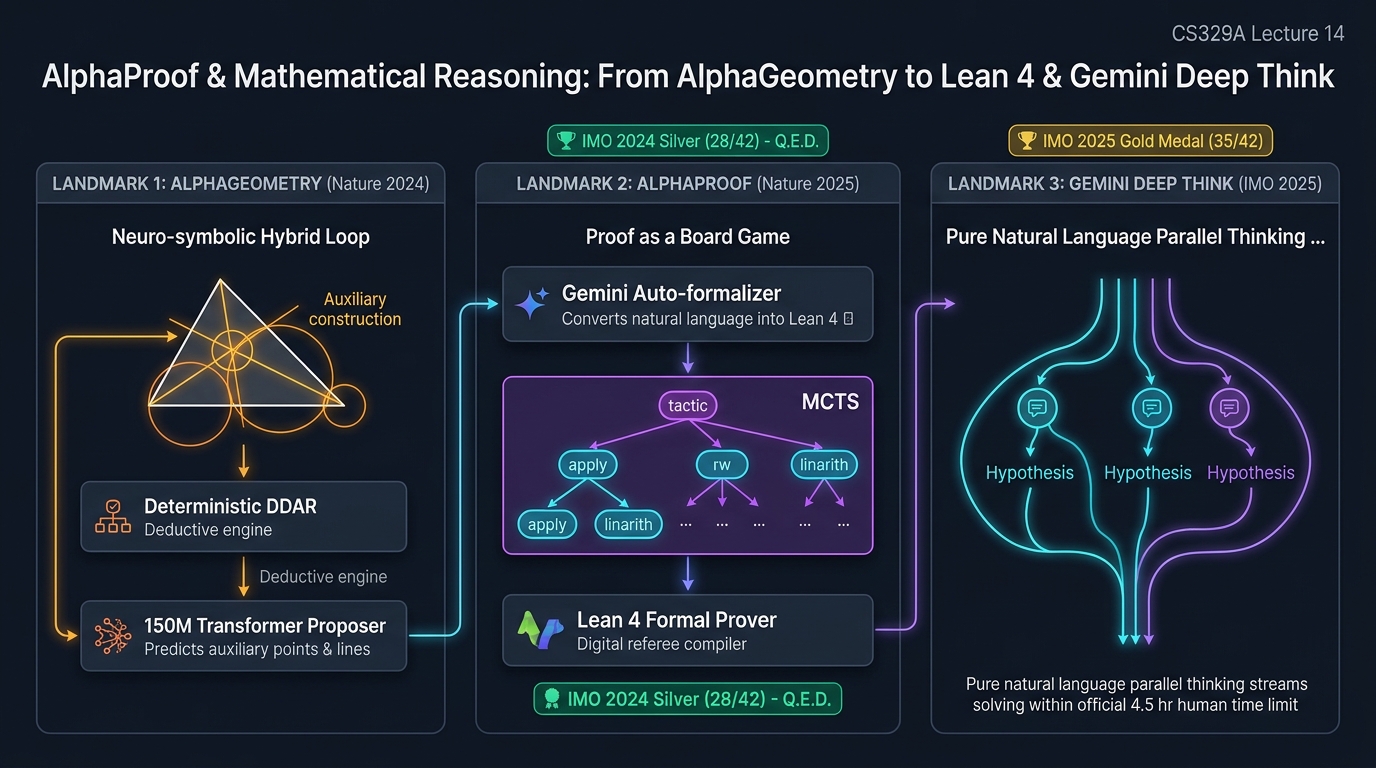
Bienvenidos a la Lección 14 de Stanford CS329A: Self-Improving AI Agents, correspondiente a la Parte 4: Fronteras (Frontiers in Reasoning & Autonomy). Inspirados en los avances pioneros dirigidos por el Dr. Thang Luong (Director Sénior de Investigación en Google DeepMind), examinamos cómo la inteligencia artificial trascendió la predicción estocástica de palabras para transformarse en deducción matemática mecánica e infalible, culminando en históricas medallas en la Olimpiada Internacional de Matemáticas (IMO):
- AlphaGeometry (Nature 2024): Síntesis neuro-simbólica que fusiona motores deductivos deterministas con transformadores generativos para construcciones geométricas auxiliares.
- AlphaProof (DeepMind, Nature 2025): Redefinición de la demostración formal de teoremas como un juego de tablero estilo AlphaZero utilizando Lean 4, autoformalización y Aprendizaje por Refuerzo en Tiempo de Prueba (TTRL).
- Gemini Deep Think (IMO 2025): Triunfo del razonamiento puro en lenguaje natural y pensamiento paralelo (Parallel Thinking), obteniendo la primera Medalla de Oro oficial en la IMO (35/42) dentro del límite humano de 4.5 horas.
- Verificación formal en LLMs y razonamiento matemático: Comparación técnica entre núcleos formales compilados por máquina y modelos de lenguaje basados en refuerzo no restringido.
1. Las matemáticas: El banco de pruebas supremo para la inteligencia artificial
¿Por qué las matemáticas son consideradas unánimemente como el "banco de pruebas supremo (Litmus Test)" para los agentes cognitivos autónomos? Mientras que las pruebas de código (SWE-bench) y las tareas conversacionales permiten soluciones heurísticas y toleran cierta imprecisión, las matemáticas formales imponen tres restricciones estructurales categóricas:
┌──────────────────────────────────────────────────────────────────────────┐
│          Por qué las matemáticas son la prueba de fuego de la IA         │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Verificabilidad mecánica│  │  Recompensa extrema     │  │ Espacio combinatorio    │
│ objetiva (0% alucinación)│ │  dispersa (Sparsity)    │  │ masivo e infinito       │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Lógica formal estricta│  │ • Cientos de pasos con  │  │ • Ramificación infinita │
│   (Lean 4, Coq, Isabelle)│   cero recompensa hasta el│    en el espacio de lemas  │
│ • Compilador verificador│    cierre final (Q.E.D.)   │  │ • Invención de líneas y │
│   determinista          │  │ • La recompensa solo se │    puntos auxiliares exige │
│ • Verdad binaria: 0 o 1 │    emite con éxito total   │    verdadera creatividad   │
│ • Tolerancia a fallas:0 │  │ • Asignación de crédito │  │ • Imposible mediante    │
│   (Sin crédito parcial) │    extremadamente difícil  │    fuerza bruta ingenua    │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- Verificabilidad mecánica objetiva (Objective Mechanical Verifiability): A diferencia de ensayos literarios o dictámenes legales, las matemáticas formales son verificadas con un 100% de rigor determinista por un programa compilador (como el comprobador de tipos de Lean 4).
- Recompensa extremadamente dispersa (Extreme Reward Sparsity): En una demostración de nivel olímpico con cientos de inferencias tácticas, el agente recibe cero recompensa positiva hasta cerrar el objetivo final (
Goal Solved). Un intento correcto al 99% que falla en la última igualdad recibe recompensa cero. - Espacio de búsqueda combinatorio colosal (Massive Combinatorial Search Space): A diferencia del ajedrez (factor de ramificación $\approx 35$) o el Go ($\approx 250$), el espacio de lemas matemáticos, definiciones y construcciones auxiliares es infinito ($b \to \infty$).
2. Síntesis neuro-simbólica: AlphaGeometry (Trinh et al., Nature 2024)
Los problemas de geometría euclidiana en la IMO representan un desafío formidable incluso para los competidores más brillantes. Aunque un estudiante memorice todos los axiomas, no puede avanzar sin realizar una construcción auxiliar (Auxiliary Construction) creativa —como trazar una circunferencia circunscrita sobre tres puntos no evidentes o bajar una perpendicular auxiliar.
Históricamente, la IA se dividía en dos escuelas aisladas:
- Motores simbólicos deductivos (DDAR): Rápidos, 100% precisos y libres de errores de cálculo, pero carentes de intuición creadora. Cuando las reglas estándar agotan sus conclusiones inmediatas, el motor se detiene por completo.
- Redes neuronales profundas (Transformers): Gran intuición y reconocimiento de patrones, pero propensas a alucinaciones de coordenadas, errores de redondeo y conjeturas infundadas.
AlphaGeometry fusionó ambos mundos en una arquitectura simbiótica y asimétrica:
               +-------------------------------------------+
               |      Problema de Geometría Euclidiana     |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |  Motor Simbólico (DDAR)    | <---------+
                        |  - Base Deductiva (DD)     |           |
                        |  - Razonador Algebraico(AR)|           |
                        +--------------+-------------+           |
                                       |                         |
                         [¿Meta de prueba alcanzada?]            |
                           /                   \                 |
                        (Sí)                   (No / Bloqueado)  |
                         /                       \               |
                        v                         v              |
             +--------------------+    +-----------------------+ |
             | Demostración Final |    | Transformer de 150M   | |
             | (Texto Legible)    |    | Propositor Auxiliar   | |
             +--------------------+    +-----------+-----------+ |
                                                   |             |
                                      [Predecir Elementos      | |
                                       Auxiliares Clave]       | |
                                                   +-------------+
Motor de síntesis con 100 millones de datos
El principal obstáculo radicaba en la escasez de datos: en toda la historia olímpica existían menos de 1,000 demostraciones geométricas formalizadas. DeepMind ideó una solución sintética:
- Generación de grafos aleatorios: Muestrearon 1,000 millones de configuraciones aleatorias de puntos, segmentos y circunferencias.
- Rastreo deductivo: El motor DDAR dedujo sistemáticamente más de 100 millones de teoremas y trayectorias válidas a partir de dichas figuras aleatorias.
- Aislamiento por dependencia auxiliar: Filtraron 9 millones de demostraciones donde el teorema solo era demostrable si y solo si se incorporaba una construcción auxiliar específica.
- Destilación supervisada: Entrenaron un Transformer de 150M parámetros para sugerir exactamente esas construcciones indispensables cuando el motor deductivo se bloquea.
Resultados en la IMO
En un conjunto de 30 problemas históricos de geometría de la IMO:
- El método simbólico líder previo (método de Wu) resolvió solo 10 problemas.
- AlphaGeometry resolvió 25 de los 30 problemas dentro del límite de tiempo oficial, igualando el nivel de medallistas de oro humanos.
- En el Problema 1 de la IMO 2004, AlphaGeometry descubrió que una premisa exigida por los autores era matemáticamente innecesaria, extendiendo el teorema a una versión más general.
3. La demostración como juego de tablero: AlphaProof (Nature 2025)
La geometría, sin embargo, es solo una rama de las matemáticas. Para conquistar teoría de números, álgebra abstracta y combinatoria, un agente debe manipular enunciados formales mediante deducciones rigurosas.
En julio de 2024, el equipo del Dr. Thang Luong presentó AlphaProof, un sistema que replanteó la demostración formal como un juego de suma cero contra un compilador estricto.
┌──────────────────────────────────────────────────────────────────────────┐
│                   Arquitectura de AlphaProof                             │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Autoformalizador Gemini  │                   │ Red de Búsqueda AlphaZero │
├──────────────────────────┤                   ├───────────────────────────┤
│ • Entrada matemática NL  │                   │ • Transformer de 3B params│
│ • 100M problemas brutos  │                   │ • Política de tácticas:   │
│ • Validación bidireccional                   │   apply, rw, linarith     │
│ • Código formal Lean 4   │                   │ • Cabeza de valor:        │
│ • 80M teoremas válidos   │                   │   Distancia a meta Q.E.D. │
└────────────┬─────────────┘                   └─────────────┬─────────────┘
             │                                               │
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Kernel Formal de Lean 4  │
                      ├─────────────────────────────┤
                      │ • Verificador de tipos      │
                      │ • Bucle de retroalimentación│
                      │ • Verificación binaria (0/1)│
                      │   - Táctica compilada con OK│
                      │   - Habitación de tipo Q.E.D│
                      └─────────────────────────────┘
El entorno Lean 4: El tablero de ajedrez infinito
Lean 4 es un lenguaje funcional puro basado en el Cálculo de Construcciones Inductivas (CIC). Mediante la correspondencia de Curry-Howard:
- Una Proposición matemática equivale a un Tipo.
- Una Demostración matemática equivale a un Término (Programa) que habita ese tipo.
- El Compilador de Lean actúa como árbitro supremo: si el código compila, el teorema está matemáticamente verificado al 100%.
En cada paso, la red de AlphaProof observa el estado actual (Goal) y emite tácticas formales como induction, ring, rw [mul_comm] o linarith.
Autoformalización: Construcción de 80 millones de teoremas
Menos de 1,000 matemáticos en el mundo dominan Lean 4. DeepMind utilizó modelos Gemini para traducir automáticamente millones de problemas de libros de texto a especificaciones formales en Lean 4, creando una biblioteca de 80 millones de enunciados formalizados.
Aprendizaje por Refuerzo en Tiempo de Prueba (TTRL)
Frente al Problema 6 de la IMO 2024 (un problema de combinatoria extrema resuelto por solo 5 de 609 competidores), la red base no encontró el camino. DeepMind activó el TTRL:
[Entrada: Problema 6 de la IMO 2024]
         │
         ▼
[Sintetizador automatizado de problemas Gemini]
         │
         ├──> Sintetizar 400,000 variaciones estructurales del problema
         │    (Parámetros reducidos, lemas auxiliares, casos límite)
         ▼
[Clúster de miles de chips TPU v5e]
         │
         ├──> Ejecutar auto-juego AlphaZero sobre las 400,000 variaciones
         ├──> Actualizar pesos sinápticos dinámicamente durante 3 días
         ▼
[Red neuronal especializada generada en tiempo de prueba]
         │
         ▼
[¡Demostración formal en Lean 4 del Problema 6 completada y verificada!]
AlphaProof resolvió 4 de 6 problemas, obteniendo 28 de 42 puntos: Medalla de Plata oficial en la IMO (a solo 1 punto del Oro).
4. Razonamiento puro en lenguaje natural: Gemini Deep Think (IMO 2025)
A pesar del éxito de AlphaProof, persistían dos desafíos prácticos:
- La necesidad de traducir enunciados a Lean 4 requería un complejo proceso de formalización.
- El bucle TTRL requería 3 días de supercómputo TPU, superando el límite humano de 4.5 horas diarias.
En julio de 2025, DeepMind presentó Gemini Deep Think, demostrando que el lenguaje natural puro puede alcanzar la cumbre olímpica sin compilación intermedia:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think: Pensamiento Paralelo                │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Rama Hipotética A       │  │ Rama Hipotética B       │  │ Rama Hipotética C       │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Sustitución algebraica│  │ • Inversión geométrica  │  │ • Cotas combinatorias   │
│ • Progreso: 4 pasos     │  │ • Bloqueo en Lema 3     │  │ • Deriva límite asintótico│
│ • Autoevalúa contradicción│ • Poda limpia de la rama │  │ • Integrada en hipótesis A│
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
Gemini Deep Think implementa Pensamiento Paralelo (Parallel Thinking):
- Explora simultáneamente decenas de ramas analíticas y algebraicas.
- Cuando una vía se estanca, rescata invariantes parciales y los transfiere a las ramas activas.
- Trabajando dentro del límite oficial de 4.5 horas, resolvió 5 de 6 problemas (35 de 42 puntos), logrando la primera Medalla de Oro oficial en la IMO para la IA.
5. Comparativa arquitectónica: Verificación formal vs RL en lenguaje natural
+-----------------------+----------------------------------+----------------------------------+
| Eje de Comparación    | Verificación Formal (AlphaProof) | RL en Lenguaje Natural (DeepThink)
+-----------------------+----------------------------------+----------------------------------+
| Motor de Verificación | Comprobador de tipos de Lean 4   | LLM multi-agente y autocrítica   |
| Riesgo de Alucinación | Exactamente 0% (Garantía formal) | > 0% (Riesgo de fallas lógicas)  |
| Tiempo de Búsqueda    | Horas a días (MCTS + TTRL)       | 4.5 horas (Inferencia en vivo)   |
| Dominio Principal     | Software crítico, criptografía   | Ciencia abierta, estrategia      |
| Infraestructura       | Ecosistema Lean 4, Mathlib       | Infraestructura RL distribuida   |
+-----------------------+----------------------------------+----------------------------------+
6. Conclusiones y lecciones de ingeniería
- Los datos sintéticos impulsan el razonamiento de frontera: AlphaGeometry demostró que ante la falta de datos reales, los motores simbólicos pueden sintetizar cientos de millones de demostraciones para entrenar la intuición neural.
- La verificación formal erradica la alucinación: En misiones críticas, los agentes deben fundamentar su inferencia en compiladores formales como Lean 4.
- El cómputo en inferencia (TTRL) es la nueva frontera: Generar variaciones de problemas y entrenar pesos en tiempo de prueba desbloquea soluciones fuera del alcance de modelos estáticos.
- El pensamiento paralelo natural compite con la velocidad humana: Gemini Deep Think evidenció que la exploración paralela permite alcanzar nivel de oro olímpico en tiempo real.
En nuestra próxima lección, Lección 15: Sistemas Autónomos y Confiabilidad, nos adentraremos en cómo los agentes autónomos gestionan entornos caóticos de producción mediante autorreparación (Self-Healing), sandboxes de seguridad y salvaguardas operativas. ¡Nos vemos en la siguiente entrega!