Stanford CS329A (Ep 16): Multimodal & Embodied Agents — Modelos de visión-lenguaje-acción (VLA), RT-2, OpenVLA y π₀

En la lección previa sobre Sistemas Autónomos y Confiabilidad, analizamos cómo los agentes de software operan en entornos virtuales protegidos mediante sandboxes y protocolos de control de IA. Sin embargo, en la comunidad de inteligencia artificial persiste una interrogante ineludible:
"¿Puede una inteligencia confinada exclusivamente a terminales digitales, que genera texto y ejecuta código, considerarse una verdadera Inteligencia Artificial General (AGI)? Nuestra realidad no se rige por instrucciones de shell; está moldeada por la gravedad, la fricción, la geometría tridimensional euclidiana y las interacciones físicas entre objetos rígidos y deformables."
¿Qué ocurre cuando dotamos a un modelo fundacional de un cuerpo físico: dos ojos RGB de alta resolución (cámaras) y un brazo articulado de acero con siete grados de libertad (manipulador robótico)?
- Tomar un huevo crudo sin quebrar la cáscara y depositarlo suavemente en una sartén;
- Ordenar por colores los juguetes dispersos en el suelo de una sala de estar dentro de sus respectivas cajas;
- Insertar con precisión submilimétrica diminutos conectores electrónicos en una línea de montaje industrial.
Bienvenidos a la Clase 16 de Stanford CS329A: Self-Improving AI Agents, el cuarto capítulo de la Parte 4: Fronteras (Frontiers in Reasoning & Autonomy). De la mano de las investigaciones pioneras del Dr. Danny Driess (Investigador fundador en Physical Intelligence, exinvestigador principal en Google DeepMind Robotics), diseccionamos la arquitectura de los modelos de Visión-Lenguaje-Acción (VLA, Vision-Language-Action):
- Las acciones como tokens lingüísticos (RT-2, DeepMind 2023): La transformación de señales cinemáticas continuas de 7DoF en 256 tokens discretos integrados en el vocabulario de un VLM de 55B parámetros.
- La vanguardia del código abierto (OpenVLA, 2024): Superar a modelos cerrados de 55B con una arquitectura de 7B gracias a la fusión de visión dual SigLIP + DINOv2, discretización por cuantiles y ajuste fino LoRA en GPUs comerciales.
- Control continuo y políticas de difusión ($\pi_0$): Superar las microvibraciones de la discretización para dominar la manipulación de materiales deformables como doblar ropa o ensamblar cajas de cartón.
- Arquitectura de seguridad corporizada: Blindaje dual que combina el recorte de velocidad por software con bucles de reflejo por sensores de fuerza-par por hardware.
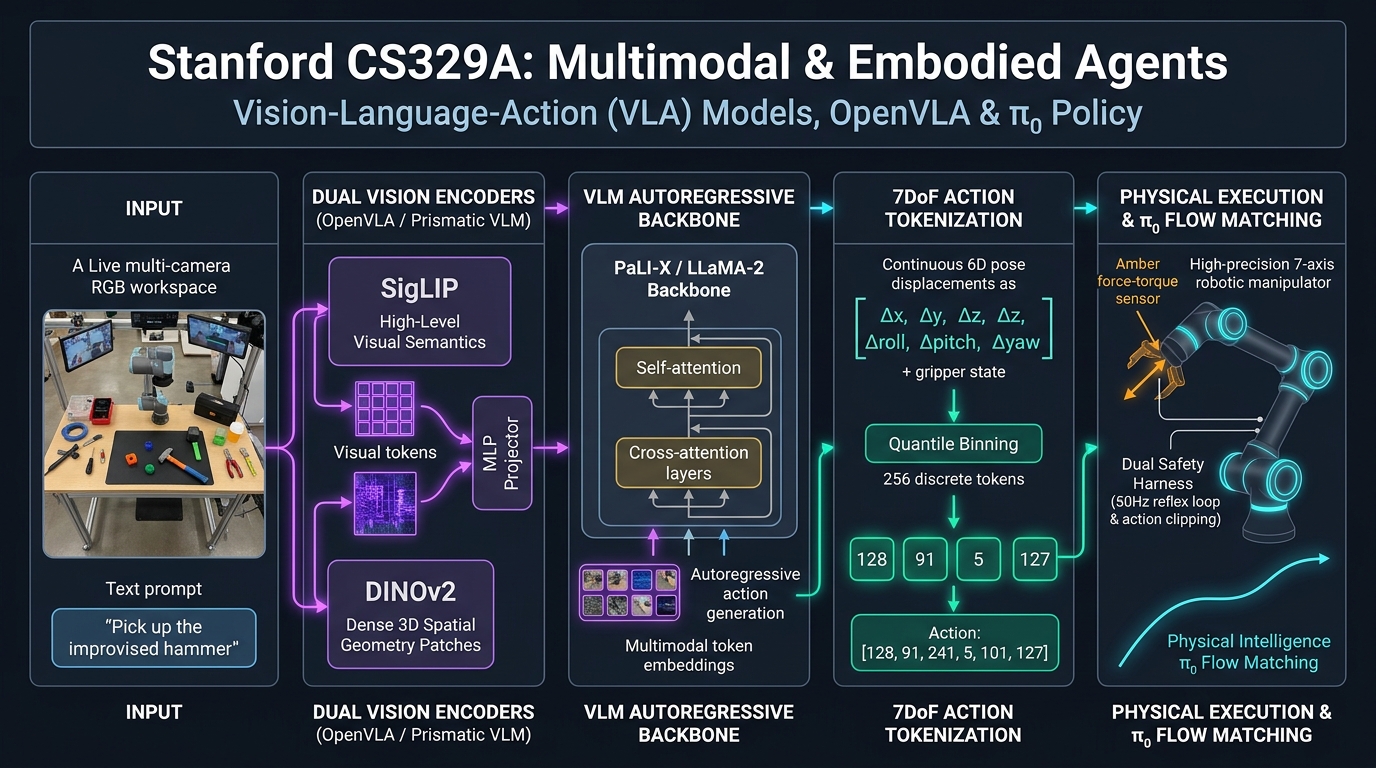
1. La frontera física: Rompiendo la sequía de datos en robótica
Durante décadas, la investigación en robótica estuvo lastrada por una severa escasez de datos. Mientras los modelos de lenguaje se entrenaban con billones de tokens de la web, los datos de interacción física eran extremadamente costosos y escasos:
- Exigían operar costosos brazos robóticos en entornos físicos bajo control de expertos humanos.
- Una flota de 13 robots de Google operando durante 17 meses recolectó apenas unas 130.000 demostraciones.
- En consecuencia, las políticas robóticas tradicionales sufrían de una fragilidad extrema: un cambio del 10% en la iluminación o un desplazamiento de 5 cm en la posición de un objeto provocaba que el manipulador errara el agarre.
El Dr. Danny Driess y el equipo de DeepMind formularon una propuesta revolucionaria para trasladar la inteligencia de la web al mundo físico:
"No entrenes una política robótica desde cero con datos físicos reducidos. Toma un modelo fundacional de Visión-Lenguaje (VLM) preentrenado con miles de millones de imágenes y textos de internet, y enséñale a emitir movimientos articulares como si las acciones físicas fuesen simplemente otro idioma extranjero."
┌──────────────────────────────────────────────────────────────────────────┐
│              Cambio de paradigma hacia los modelos VLA                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ Políticas robóticas tradicionales│   │ Modelos VLA                      │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • Pequeñas CNN/ResNet entrenadas │   │ • Backbone multimodal de 7B a 55B│
│   con unos miles de datos de lab │   │ • Preentrenados en toda la web   │
│ • Generalización semántica del 0%│   │ • Razonamiento de sentido común: │
│ • Falla si el objeto varía 5 cm  │     "Una piedra sirve de martillo"   │
│ • Requiere código nuevo por tarea│   │ • Generalización zero-shot a     │
│ • Silos cerrados e inconexos     │     nuevos objetos y entornos reales │
└──────────────────────────────────┘   └──────────────────────────────────┘
2. Acciones como palabras: RT-2 (Brohan et al., DeepMind 2023)
En julio de 2023, Google DeepMind presentó Robotic Transformer 2 (RT-2), transformando modelos masivos de visión y lenguaje (PaLI-X 55B y PaLM-E 12B) en controladores robóticos integrales de extremo a extremo.
[Entrada: Imagen RGB] + [Instrucción: "Mueve el balón de fútbol junto a la foto de Messi"]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             Backbone VLA masivo (PaLI-X de 55B)               │
     │  • Conocimiento de la web: Reconoce el rostro de Lionel Messi │
     │  • Razonamiento espacial: Deduce las coordenadas 3D relativas │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (Generación autorregresiva de tokens)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ Cierre de pinza (127)
                     │       │  │   │   └──┴───┴───── Rotación 3D (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── Desplazamiento 3D (Δx, Δy, Δz)
                     └─────────────────────────────── Bandera de continuación
El espacio de acción de 7DoF y la discretización uniforme en 256 bins
Los brazos robóticos manipulan objetos en un espacio continuo de 7 grados de libertad (7DoF):
- Desplazamiento traslacional ($\Delta x, \Delta y, \Delta z$): Movimiento del efector final en el espacio 3D.
- Desplazamiento rotacional ($\Delta roll, \Delta pitch, \Delta yaw$): Cambio de orientación de la muñeca.
- Estado de la pinza ($gripper$): Acción de apertura o cierre del actuador final.
Para transformar estos vectores de punto flotante en tokens discretos asimilables por el transformador, RT-2 empleó la discretización uniforme:
- Se divide el rango operativo
[a_min, a_max](por ejemplo,[-30cm, +30cm]) en 256 intervalos uniformes (bins):
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad \text{acotado en } [0, 255]
- Se seleccionan 256 tokens infrecuentes del vocabulario del VLM y se asignan a estos índices de motor.
- Durante la inferencia se aplica una máscara de restricción de salida (Output Constraint Mask), obligando al modelo a emitir exclusivamente estos 256 tokens de acción válidos.
Transferencia de sentido común físico
Al preservar el conocimiento general de internet, RT-2 demostró una plasticidad asombrosa:
- Aunque jamás vio un martillo en su entrenamiento físico, al ordenarle "Recoge un objeto que sirva de martillo improvisado", escogió una piedra en lugar de un borrador.
- Ejecutó instrucciones relativas complejas como "Empuja la lata de refresco más cercana a la manzana", triplicando la tasa de éxito de generalización respecto al modelo previo (RT-1).
Co-ajuste fino (Co-Fine-Tuning) contra el olvido catastrófico
Si un VLM de 55B se ajusta exclusivamente con datos robóticos, sufre de olvido catastrófico (Catastrophic Forgetting), perdiendo su razonamiento semántico general. RT-2 resolvió esto mediante co-ajuste fino:
- Cada lote de entrenamiento mezcla trayectorias robóticas con pares estándar de texto-imagen de la web.
- Esto mantiene activas las representaciones semánticas del mundo mientras aprende el control de motores.
3. Democratización y código abierto: OpenVLA (2024)
Pese al éxito de RT-2, sus 55B parámetros requerían clusters de TPU en la nube y permanecía como un sistema cerrado e inaccesible para la comunidad científica.
En 2024, investigadores de Stanford y UC Berkeley lanzaron OpenVLA, un modelo VLA universal de 7B de código abierto, entrenado sobre el conjunto Open X-Embodiment (970.000 demostraciones en 22 configuraciones robóticas).
               +-------------------------------------------+
               |              Entrada de Cámara RGB        |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   Codificador      |     |   Codificador      |
             |   SigLIP (Semántica|     |   DINOv2 (Geometría|
             |   Visual Superior) |     |   Espacial 3D)     |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (Concatenación por canales)
                                     v
                        +----------------------------+
                        |    Proyector MLP de 2 capas|
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |  Backbone Llama-2 de 7B    |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        | 256 Tokens de Cuantiles    |
                        +----------------------------+
1. Fusión de visión dual: SigLIP + DINOv2 (Prismatic VLM)
La manipulación física requiere tanto comprensión semántica ("¿Qué es esto?") como geometría milimétrica ("¿Dónde está el borde de la taza con 2 mm de precisión?"):
- SigLIP: Especializado en enlazar conceptos lingüísticos con regiones visuales.
- DINOv2: Extrae características espaciales de alta resolución, profundidad y aristas.
- La concatenación de ambos vectores de características mejoró la precisión del agarre en más de un 20% respecto al uso de SigLIP por separado.
2. Discretización por cuantiles (Quantile Binning)
El reparto uniforme de RT-2 presentaba un defecto: en tareas reales, el 90% de los movimientos son microajustes subcentimétricos, mientras que los giros bruscos representan menos del 1%.
- OpenVLA dividió los 256 intervalos calculando los cuantiles empíricos de las 970.000 trayectorias:
\text{Límites de Bin: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- Esto concentra la resolución de los tokens en los movimientos milimétricos delicados, reduciendo drásticamente las fallas de agarre.
3. Ajuste fino LoRA en una única RTX 4090
- Congelando la visión y aplicando LoRA en apenas el 1.4% de los parámetros de Llama-2, OpenVLA se adapta a nuevos robots en menos de 15 horas.
- Gracias a la cuantización a 4 bits (NF4), el modelo opera en 7GB de VRAM, alcanzando una frecuencia de control en tiempo real de 6Hz en una sola GPU doméstica (RTX 4090).
- En 29 pruebas físicas, superó al gigante RT-2-X de 55B con una tasa de éxito un 16.5% superior, siendo 7 veces más ligero.
4. Control continuo y políticas de difusión: Physical Intelligence $\pi_0$ (2024)
A pesar de sus logros, la tokenización discreta presenta limitaciones físicas:
- La cuantización en 256 niveles genera microvibraciones (jittering) indeseadas en frecuencias superiores a 50Hz.
- Operaciones con objetos deformables —como doblar ropa, manipular cables o armar cajas de cartón— requieren trayectorias continuas y suaves.
El Dr. Danny Driess y el equipo de Physical Intelligence desarrollaron $\pi_0$ (pi-zero) mediante Flow Matching:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Arquitectura Physical Intelligence π₀                  │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Planificador VLM         │                   │ Política de Difusión /    │
├──────────────────────────┤                   │ Flow Matching Continuo    │
│ • Análisis de la escena  │                   ├───────────────────────────┤
│ • Planificación temporal │ ── Vectores Meta ─► • Inferencia a 50Hz         │
│ • Seguimiento de metas   │                   │ • Campo vectorial continuo│
└──────────────────────────┘                   │ • Cero microvibraciones   │
                                               └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [Trayectoria Continua Suave]
                                               (Dobla ropa y ensambla cajas)
$\pi_0$ emplea el VLM para fijar metas semánticas, mientras que el módulo de control genera trayectorias continuas mediante eliminación de ruido en tiempo real, logrando ejecutar con un único modelo tareas tan complejas como sacar prendas de un cesto de ropa sucia y doblarlas con delicadeza.
5. Comparativa arquitectónica de modelos fundacionales en robótica
+-----------------------+----------------------------------+----------------------------------+
| Característica        | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| Tamaño del Modelo     | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Backbone Llama-2)            |
| Codificador Visual    | ViT único                        | Fusión dual (SigLIP + DINOv2)    |
| Discretización Acción | 256 Bins uniformes               | 256 Bins por cuantiles           |
| Hardware Necesario    | Clúster de TPUs en la nube       | GPU doméstica (RTX 4090 de 24GB) |
| Eficiencia de Ajuste  | Fine-tuning completo             | LoRA al 1.4% + cuantización 4-bit|
| Disponibilidad        | Propietario / Código cerrado     | 100% Pesos y código abiertos     |
+-----------------------+----------------------------------+----------------------------------+
6. Seguridad corporizada: El arnés de reflejo en dos niveles
Los robots físicos ejercen fuerzas mecánicas reales que pueden dañar el entorno o lesionar a humanos. Los sistemas en producción incorporan un arnés de seguridad dual:
[Salida de Acción del Modelo VLA: Delta 7DoF]
                 │
                 ▼
[Nivel 1: Recorte de Velocidad y Espacio de Trabajo por Software]
  ├── Limitar velocidad máxima: ||Δpos|| <= 5 cm por ciclo
  └── Restringir el movimiento a la caja virtual de seguridad
                 │
                 ▼
[Nivel 2: Bucle de Reflejo por Sensor de Fuerza-Par en Hardware (1000 Hz)]
  ├── Si la fuerza de contacto F_contacto > 20 Newtons:
  └── Anular orden VLA -> Parada de emergencia / Amortiguación pasiva
- Recorte de acción por software: Si el incremento articular propuesto por el modelo supera los umbrales seguros (ej. más de 5 cm de traslación por ciclo), el controlador de bajo nivel recorta automáticamente la orden.
- Reflejo por sensor de fuerza-par en hardware: Operando a 1.000 Hz en los actuadores, si el sensor detecta una resistencia imprevista (como un choque contra una persona), desactiva los motores al instante de forma refleja e independiente del modelo superior.
7. Conclusiones y lecciones de ingeniería
- La acción física es una modalidad del lenguaje: Tratar el movimiento continuo como tokens discretos permite transferir el sentido común adquirido en internet al control de motores.
- La visión dual es indispensable en robótica: Acoplar la semántica de SigLIP con la geometría densa 3D de DINOv2 es el factor decisivo para lograr precisión submilimétrica.
- Los cuantiles resuelven el desequilibrio motor: Concentrar la resolución de los tokens en los movimientos finos reduce de forma drástica los fallos de agarre.
- La difusión continua es el futuro de la manipulación: Técnicas de Flow Matching como $\pi_0$ eliminan vibraciones y abren las puertas al manejo de materiales deformables.
En nuestra última sesión, Clase 17 (GRAND FINALE): Direcciones Futuras de Investigación, resumiremos las 17 lecciones de Stanford CS329A y analizaremos las grandes preguntas abiertas hacia la verdadera inteligencia artificial autorregenerativa y los enjambres de agentes. ¡Nos vemos en la gran final!