Stanford CS329A (Ep 8): Búsqueda e Investigación Profunda — Búsqueda en el Espacio de Programas (AlphaCode) y en el Espacio del Conocimiento con Search-o1

En la ingeniería de software y la investigación científica de frontera, la verdadera pericia nunca se evalúa por la memorización estática. Incluso el ingeniero de software más legendario es incapaz de escribir un sistema distribuido y concurrente de miles de líneas sin un solo error en su primera pulsación de teclas. Ningún científico laureado con el Nobel formula la síntesis de un fármaco innovador basándose exclusivamente en su memoria biológica sin consultar literatura técnica externa.
El poder del intelecto humano reside en su capacidad sistemática de exploración:
"La habilidad de explorar millones de hipótesis plausibles, podar agresivamente callejones sin salida, consultar activamente fuentes de conocimiento externas para subsanar vacíos cognitivos y sintetizar información dispersa en conclusiones verificables."
En esta octava lección de Stanford CS329A: Self-Improving AI Agents (Agentes de IA Autoevolutivos), analizamos cómo el concepto de Búsqueda (Search) multiplica el rendimiento de la inteligencia artificial en dos dimensiones fundamentales:
- Búsqueda en el Espacio de Programas (Program Space Search): Generación masiva de código y agrupamiento por firmas de comportamiento en tiempo de ejecución con AlphaCode Competitive Programming (Programación Competitiva AlphaCode) de Google DeepMind.
- Búsqueda en el Espacio del Conocimiento (Knowledge Space Search): Integración de razonamiento de cadena larga con recuperación activa de datos a través de Search-o1 Autonomous Investigation (Investigación Autónoma Search-o1) y Self-Reflective Search Loops (Bucles de Búsqueda Autorreflexivos).
- Flujos de Agentes de Investigación Profunda (Deep Research Workflows): La arquitectura del Information Synthesis Agent (Agente de Síntesis de Información), que descompone consultas complejas, investiga recursivamente en la web y redacta informes técnicos exhaustivos.
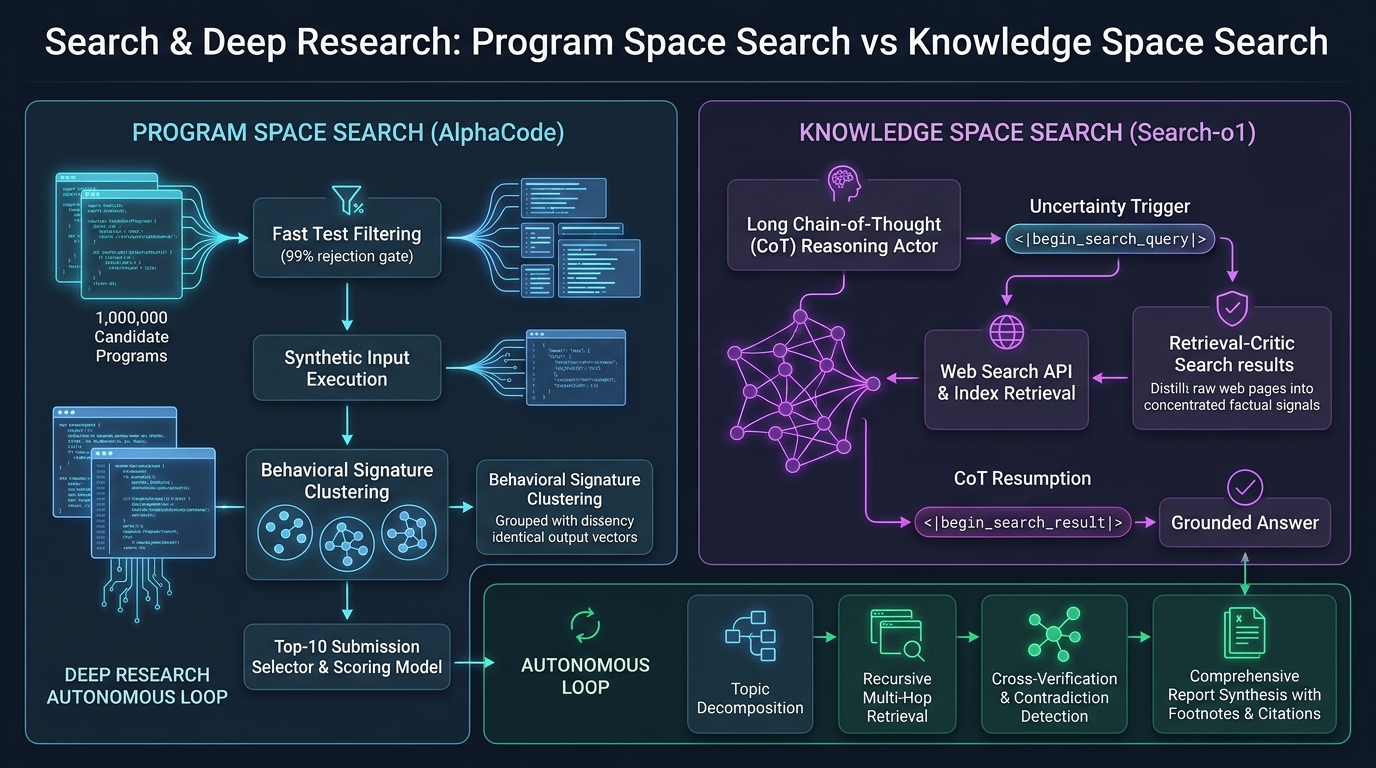
1. La Doble Dimensión de la Búsqueda Agéntica
En la IA clásica, la búsqueda se restringía a espacios discretos (como la búsqueda de caminos A* o minimax en ajedrez). En los agentes autónomos modernos, la búsqueda se expande hacia espacios continuos de probabilidades de tokens y entornos web abiertos:
                          ┌─────────────────────────────────────┐
                          │   Las Dos Fronteras de la Búsqueda   │
                          └──────────────────┬──────────────────┘
                                             │
             ┌───────────────────────────────┴───────────────────────────────┐
             ▼                                                               ▼
┌─────────────────────────────────────────┐     ┌─────────────────────────────────────────┐
│     Búsqueda en Espacio de Programas    │     │    Búsqueda en Espacio de Conocimiento  │
├─────────────────────────────────────────┤     ├─────────────────────────────────────────┤
│ • AlphaCode 1 y 2 (Google DeepMind)     │     │ • Search-o1 y RAG Agéntico              │
│ • Recompensas binarias dispersas        │     │ • Conocimiento web abierto e ilimitado  │
│ • 1.000.000 de programas candidatos     │     │ • Detección de vacíos de conocimiento   │
│ • Firmas de comportamiento en ejecución │     │ • Filtrado "Reason-in-Documents"        │
│ • Agrupamiento por invariantes de salida│     │ • Exploración recursiva e informes      │
└─────────────────────────────────────────┘     └─────────────────────────────────────────┘
El desafío central en ambos dominios radica en el Compromiso entre Precisión y Cobertura (Precision-Recall Tradeoff) bajo Presupuesto de Cómputo:
- En síntesis de programas, muestrear millones de candidatos eleva la probabilidad teórica de encontrar la solución ($pass@k$), pero las normas de las competencias solo permiten 10 envíos oficiales ($10@k$).
- En investigación abierta, buscar en la web genera miles de tokens de HTML sin estructurar, publicidad y afirmaciones contradictorias que pueden distorsionar la atención del modelo si se inyectan sin depuración (Context Pollution).
2. Búsqueda en el Espacio de Programas: AlphaCode (Science, 2022)
Las competencias de algoritmos en plataformas como Codeforces constituyen un desafío cognitivo monumental. Exigen interpretar especificaciones complejas, derivar invariantes matemáticos y escribir código en C++ que respete límites estrictos de tiempo ($O(N \log N)$) y memoria ($256\text 256 MB$) ante casos de prueba ocultos y adversarios.
AlphaCode de Google DeepMind superó esta barrera demostrando que un cómputo masivo de inferencia complementado con agrupamiento semántico podía situar a una IA en el 54% superior de los programadores humanos.
                  [Especificación del Problema en Lenguaje Natural]
                                         │
                                         ▼
           1. Muestreo Diverso Masivo (1.000.000 de Programas C++/Python)
              (Etiquetas de dificultad aleatorias, DP/Grafos; Temperatura: 0.25)
                                         │
                                         ▼
           2. Filtrado por Pruebas de Ejemplo (Ejecución en Casos Base)
              (Elimina >99% de código sintácticamente incorrecto o fallido)
                                         │
                                         ▼
           3. Entradas Sintéticas y Agrupamiento por Firmas de Comportamiento
              (Generación de 10 entradas aleatorias; vector de salidas)
                                         │
                                         ▼
           4. Selección de Representantes de los 10 Clústeres Principales
              (Extracción de 1 candidato por cada uno de los 10 clústeres)
                                         │
                                         ▼
                     [10 Envíos Oficiales a la Competencia]
                  (Clasificado en el 54.3% superior de programadores)
El Principio del Agrupamiento por Firmas de Comportamiento
Tras superar las pruebas de ejemplo iniciales, ¿cómo seleccionar los 10 mejores programas entre 5.000 supervivientes para superar los casos de prueba ocultos?
Agrupar por similitud textual o sintáctica (BLEU o incrustaciones de CodeBERT) fracasa estrepitosamente:
- Dos programas sintácticamente idénticos al 99% pueden diferenciarse por un operador relacional (
<frente a<=), convirtiendo una solución óptima en un bucle infinito. - Por el contrario, un enfoque iterativo y uno recursivo pueden tener estructuras completamente distintas y ejecutar la misma lógica matemática exacta.
DeepMind aplicó el principio de que el código debe evaluarse por su comportamiento en ejecución:
- Un modelo auxiliar genera 10 entradas aleatorias válidas según las especificaciones del problema.
- Los 5.000 programas ejecutan estas 10 entradas en un entorno aislado (sandbox).
- Cada programa genera un vector de firmas con sus resultados:
Signature(P_i) = [ P_i(input_1), P_i(input_2), ..., P_i(input_10) ]
- El Invariante Fundamental: Los programas erróneos fallan de formas diversas y dispersas, mientras que todos los programas con lógica algorítmica correcta devuelven las mismas salidas exactas, convergiendo en el clúster más voluminoso.
- AlphaCode selecciona un representante de los 10 clústeres más grandes para los envíos finales.
AlphaCode 2: Eficiencia de Muestreo Mejorada en 10.000x con Gemini
A finales de 2023, DeepMind presentó AlphaCode 2, impulsado por Gemini Pro:
- Incorporó un Modelo de Puntuación (Scoring Model) especializado para evaluar elegancia y complejidad dentro de los clústeres.
- Elevó la tasa de resolución del 25% al 43%, alcanzando el percentil 85 (nivel Candidate Master).
- Logro sobresaliente: AlphaCode 2 igualó el rendimiento de AlphaCode 1 con solo 100 muestras frente a 1.000.000, una mejora de 10.000x en eficiencia de muestreo, confirmando que modelos con mayor capacidad de razonamiento reducen drásticamente el espacio de búsqueda requerido.
3. Búsqueda en el Espacio del Conocimiento: Search-o1 (2025)
Al analizar modelos de razonamiento en cadena larga (Long CoT como o1 o DeepSeek-R1), se observa que términos de incertidumbre ("tal vez", "espera", "es probable") aparecen un promedio de 30.4 veces por respuesta científica compleja. El RAG clásico recupera información únicamente al inicio del mensaje, siendo incapaz de resolver vacíos fácticos imprevistos en etapas avanzadas de razonamiento.
Search-o1 resolvió esta deficiencia mediante la Recuperación Dinámica Autorreflexiva:
sequenceDiagram
    autonumber
    participant LLM as Actor de Razonamiento (QwQ-32B)
    participant Engine as Controlador de Búsqueda
    participant Web as API de Búsqueda Web
    participant Critic as Crítico de Recuperación (Reason-in-Docs)

    LLM->>LLM: Generando cadena de razonamiento CoT...
    Note over LLM: Vacío detectado: "¿Cuál es la secuencia de aminoácidos del CXCR4?"
    LLM->>Engine: Emite etiqueta: <|begin_search_query|> human CXCR4 sequence <|end_search_query|>
    Note over LLM: Razonamiento en pausa (Estado retenido en KV Cache)
    Engine->>Web: Ejecuta búsqueda web en tiempo real
    Web-->>Engine: Devuelve 10 documentos HTML (50.000 tokens)
    Engine->>Critic: Transfiere HTML crudo + Paso de razonamiento
    Critic->>Critic: Depura ruido y condensa el hecho clave (Reason-in-Docs)
    Critic-->>Engine: "CXCR4 es un GPCR de 352 aminoácidos; residuo 28 enlaza el ligando."
    Engine->>LLM: Inyecta hecho: <|begin_search_result|> Resumen factual <|end_search_result|>
    Note over LLM: Razonamiento reanudado
    LLM->>LLM: Completa la deducción bioquímica con base factual validada
Mecanismos Clave de Search-o1
- Actor de Razonamiento (Reasoning-Actor): Cuando el modelo detecta baja certidumbre en sus pesos internos, emite etiquetas delimitadoras (
<|begin_search_query|>), suspende su ejecución y preserva el estado en su memoria caché de claves y valores (KV Cache). - Crítico de Recuperación ("Reason-in-Documents"): Evita inyectar páginas web enteras en la ventana de contexto. Un modelo evaluador secundario analiza los documentos y sintetiza únicamente las 2 o 3 líneas esenciales requeridas para el paso de razonamiento en curso.
Resultados en GPQA Diamond (Razonamiento Científico de Nivel Doctoral):
========================================================================================
Arquitectura                 Precisión Global   Química         Biología        Física
----------------------------------------------------------------------------------------
Expertos Humanos con PhD        65.4%             48.9%          37.2%           39.9%
Modelo Base (QwQ-32B)           58.1%             45.2%          41.5%           43.2%
Agente RAG Estático Estándar    61.6%             51.0%          44.8%           47.0%
Search-o1 (Búsqueda CoT Activa) 63.6% (+5.5p)     56.4% (+7.5p)  50.2% (+13.0p)  52.8% (+12.9p)
========================================================================================
En la evaluación GPQA Diamond, Search-o1 no solo superó a los sistemas RAG convencionales, sino que rebasó el promedio de los doctores humanos especialistas en química, biología y física.
4. Arquitectura del Agente de Deep Research
Combinando la poda sistemática de AlphaCode y la recuperación activa de Search-o1, se articula el flujo de trabajo de los agentes modernos de Deep Research Agent LLM:
                       [Solicitud Compleja de Investigación]
                                         │
                                         ▼
                   ┌──────────────────────────────────────┐
                   │    Descomposición Jerárquica del Plan│
                   │ (Divide la consulta en 5-8 subtemas) │
                   └──────────────────┬───────────────────┘
                                      │
          ┌───────────────────────────┼───────────────────────────┐
          ▼                           ▼                           ▼
┌──────────────────┐        ┌──────────────────┐        ┌──────────────────┐
│  Subhipótesis A  │        │  Subhipótesis B  │        │  Subhipótesis C  │
│  Búsqueda Prof.  │        │  Búsqueda Prof.  │        │  Búsqueda Prof.  │
└─────────┬────────┘        └─────────┬────────┘        └─────────┬────────┘
          │                           │                           │
          └───────────────────────────┼───────────────────────────┘
                                      │
                                      ▼
                   ┌──────────────────────────────────────┐
                   │   Crítico de Contradicciones Cruzadas│
                   │ (Detecta discrepancias entre fuentes)│
                   └──────────────────┬───────────────────┘
                                      │
                                      ▼
                   ┌──────────────────────────────────────┐
                   │    Informe Técnico Basado en Pruebas │
                   │  (15 páginas con citas y fuentes URL)│
                   └──────────────────────────────────────┘
Fases de la Investigación Autónoma Profunda
- Descomposición de Hipótesis: Divide preguntas amplias en subpreguntas técnicas verificables.
- Exploración Recursiva Multidireccional: Sigue enlaces citados en documentos primarios para acceder a normativas, patentes y artículos fuente.
- Resolución de Contradicciones: Compara datos divergentes entre declaraciones corporativas e investigaciones independientes, asignando niveles de fiabilidad.
- Atribución Trazable: Asocia enlaces URL directos a cada afirmación empírica para garantizar la verosimilitud y eliminar alucinaciones.
5. Comparativa de Paradigmas de Búsqueda
=========================================================================================================
Dimensión              RAG Estático Convencional      AlphaCode (Espacio Código) Search-o1 (Conocimiento CoT)
---------------------------------------------------------------------------------------------------------
Espacio de Búsqueda    Base Vectorial Fija            Espacio de Tokens C++      Web Abierta y APIs Vivas
Mecanismo de Disparo   Única vez al inicio            Muestreo masivo inferencia Detección de incertidumbre
Criterio de Poda       Similitud Coseno Top-K         Firmas de comportamiento   Filtro Reason-in-Docs
Anclaje de Validación  Distancia de Incrustación      Salida en sandbox          Lógica formal y fuentes
Principal Limitación   Degradación en pasos múltiples Alto coste de cómputo      Latencia en llamadas web
=========================================================================================================
6. Preguntas y Respuestas Técnicas
P1: ¿Por qué el agrupamiento por firmas de comportamiento es superior al análisis sintáctico en AlphaCode?
La sintaxis no determina la corrección funcional. Dos programas con árboles sintácticos (AST) coincidentes al 99% pueden arrojar resultados totalmente divergentes por un simple error en los límites de un bucle. Inversamente, dos estructuras de código disímiles pueden converger en la misma función matemática. Agrupar por vectores de salida garantiza que los programas matemáticamente válidos converjan en un único clúster dominante.
P2: ¿Cómo previene "Reason-in-Documents" la contaminación del contexto en razonamientos extensos?
Inyectar páginas web completas satura la atención del modelo con información irrelevante (menús, publicidad, avisos legales). El patrón "Reason-in-Documents" emplea un agente extractor secundario que aísla únicamente los hechos estrictamente necesarios para responder a la duda puntual, manteniendo el contexto primario limpio y enfocado.
Resumen y Próxima Lección
La búsqueda convierte a los modelos de lenguaje de sistemas estáticos en agentes exploradores activos. Mediante AlphaCode, observamos cómo la exploración del espacio de código conquista la programación competitiva; mediante Search-o1 e Investigación Profunda, confirmamos cómo la recuperación activa permite superar barreras científicas de nivel doctoral.
En la Lección 9, concluiremos la Parte 2 (Entrenamiento y Evolución) con una mirada integral: Post-Training Evolution — La Transición de Chatbots a Flotas de Agentes Autónomos (SFT, RLHF, Tool Grounding y Alineación Sistémica).
Conclusiones Principales
- Cómputo de Búsqueda Óptimo: Invertir cómputo en inferencia con filtros de poda rigurosos (AlphaCode) rinde resultados superiores a la generación directa.
- Comportamiento sobre Sintaxis: Los programas deben agruparse por su ejecución real y no por su apariencia léxica.
- Recuperación Dinámica en Razonamiento: Resolver lagunas de conocimiento durante la cadena de pensamiento (Search-o1) neutraliza el problema de las alucinaciones fácticas.