Saltar al contenido principal

5 publicaciones etiquetados con "aprendizaje-por-refuerzo"

Ver Todas las Etiquetas

[Robótica Webots] Sim-to-Real: Transferencia a hardware con Arduino Uno, HC-06 Bluetooth y rastreo visual ArUco (#5)

· 6 min de lectura
Jihwan Park (jaybee)
AI & Robotics Engineer

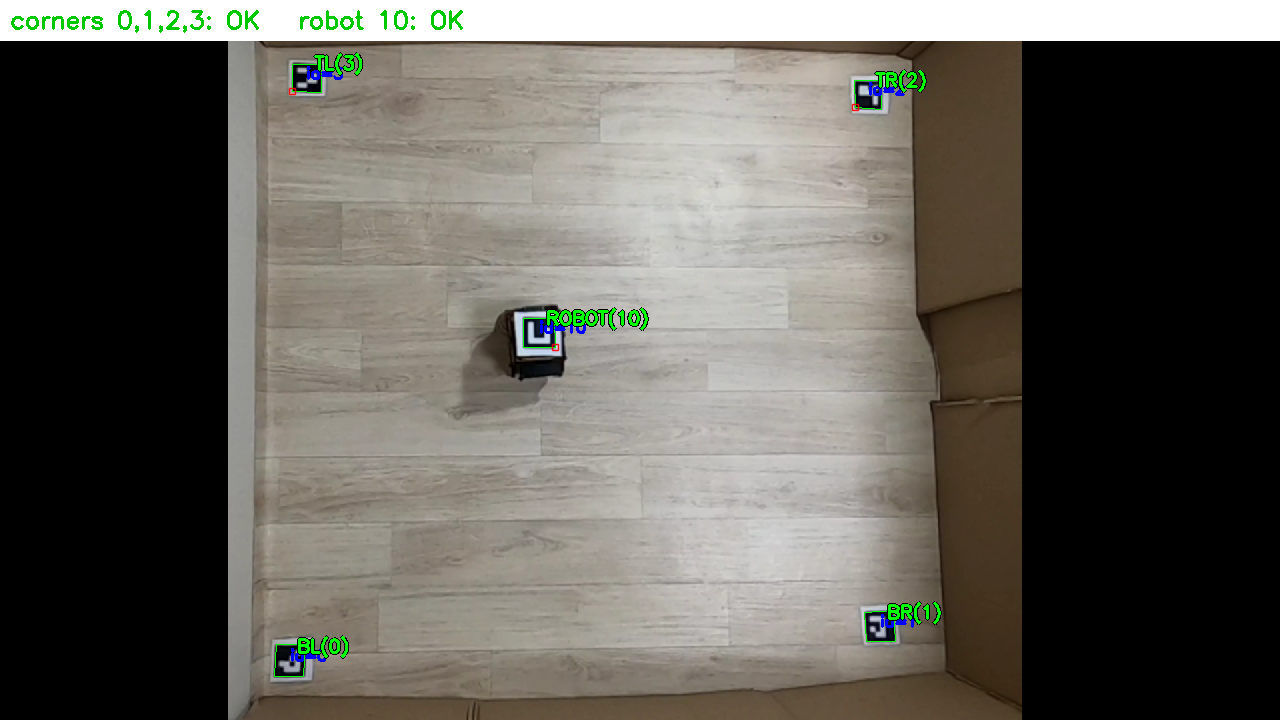
Rastreo visual con marcadores ArUco

📌 Puntos Clave (TL;DR)

  • Problema: Severas restricciones computacionales en microcontroladores (Arduino Uno ATmega328P con solo 2KB de SRAM), deslizamiento de ruedas, ruido ultrasónico y la brecha de la realidad (Reality Gap) entre la física de Webots y el hardware real.
  • Solución: Arquitectura de E/S distribuida (HC-06 Bluetooth a 115,200 baudios) donde una PC procesa la visión OpenCV y la inferencia de Q-Table mientras Arduino controla los motores mediante PWM. Corrección de distorsión de lente y homografía con marcadores ArUco (vision.py) para seguimiento de pose (x, y, θ) en tiempo real.
  • Resultado: Transferencia directa (zero-shot) de la Q-Table de 648 estados que alcanzó un 86.7% de tasa de éxito (26/30 pruebas) en una arena física de 1.2m × 1.2m, superando la brecha de realidad sin reentrenamiento in situ.
[Robótica Webots] Evaluación Determinista con evaluate_qlearning y Comparativa frente a DQN y SARSA (#4)

· 2 min de lectura
Jihwan Park (jaybee)
AI & Robotics Engineer

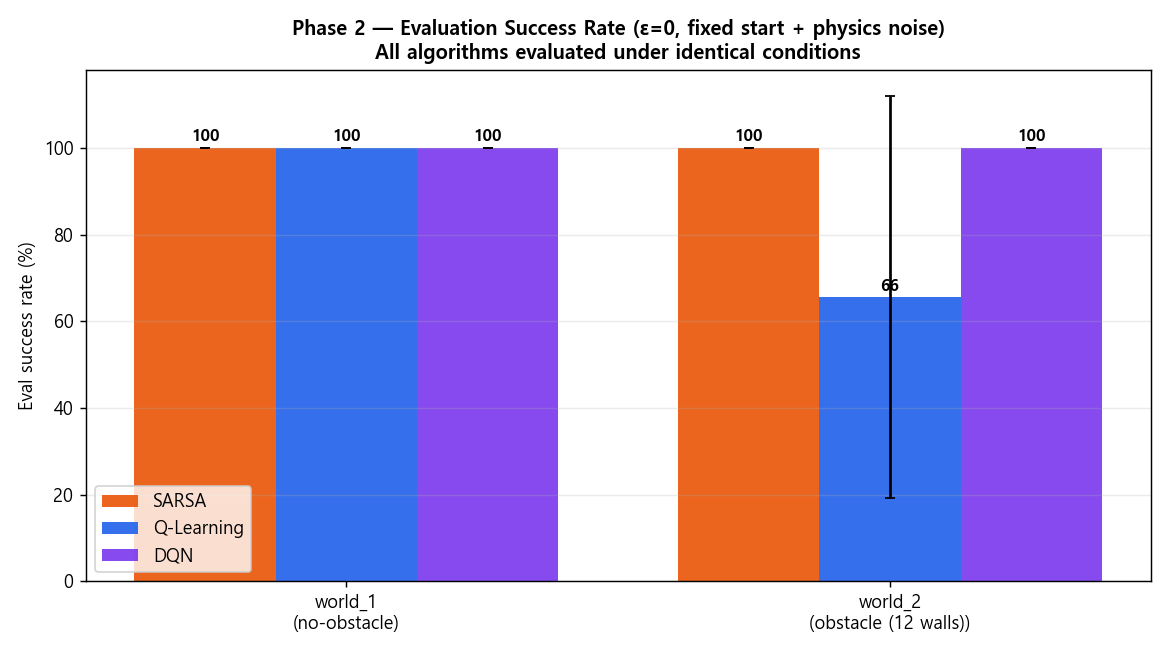
Comparativa de Éxito y Pasos

📌 Puntos Clave (TL;DR)

  • Objetivo: Medir el desempeño puro y determinista de la política voraz aprendida (ε=0) sin ruido exploratorio, validando su viabilidad de despliegue.
  • Metodología: Implementación de evaluate_qlearning.py con 30 pruebas independientes distribuidas en 5 semillas de evaluación, monitoreando tasa de éxito, eficiencia de ruta frente a la distancia mínima teórica y conteo de aproximaciones críticas (near-miss).
  • Resultado: Q-Learning tabular alcanzó un 93.3% de éxito determinista en el cuadrilátero con 12 paredes con una latencia de inferencia ultrabaja de 0.02 ms, superando a modelos más pesados como DQN y SARSA.

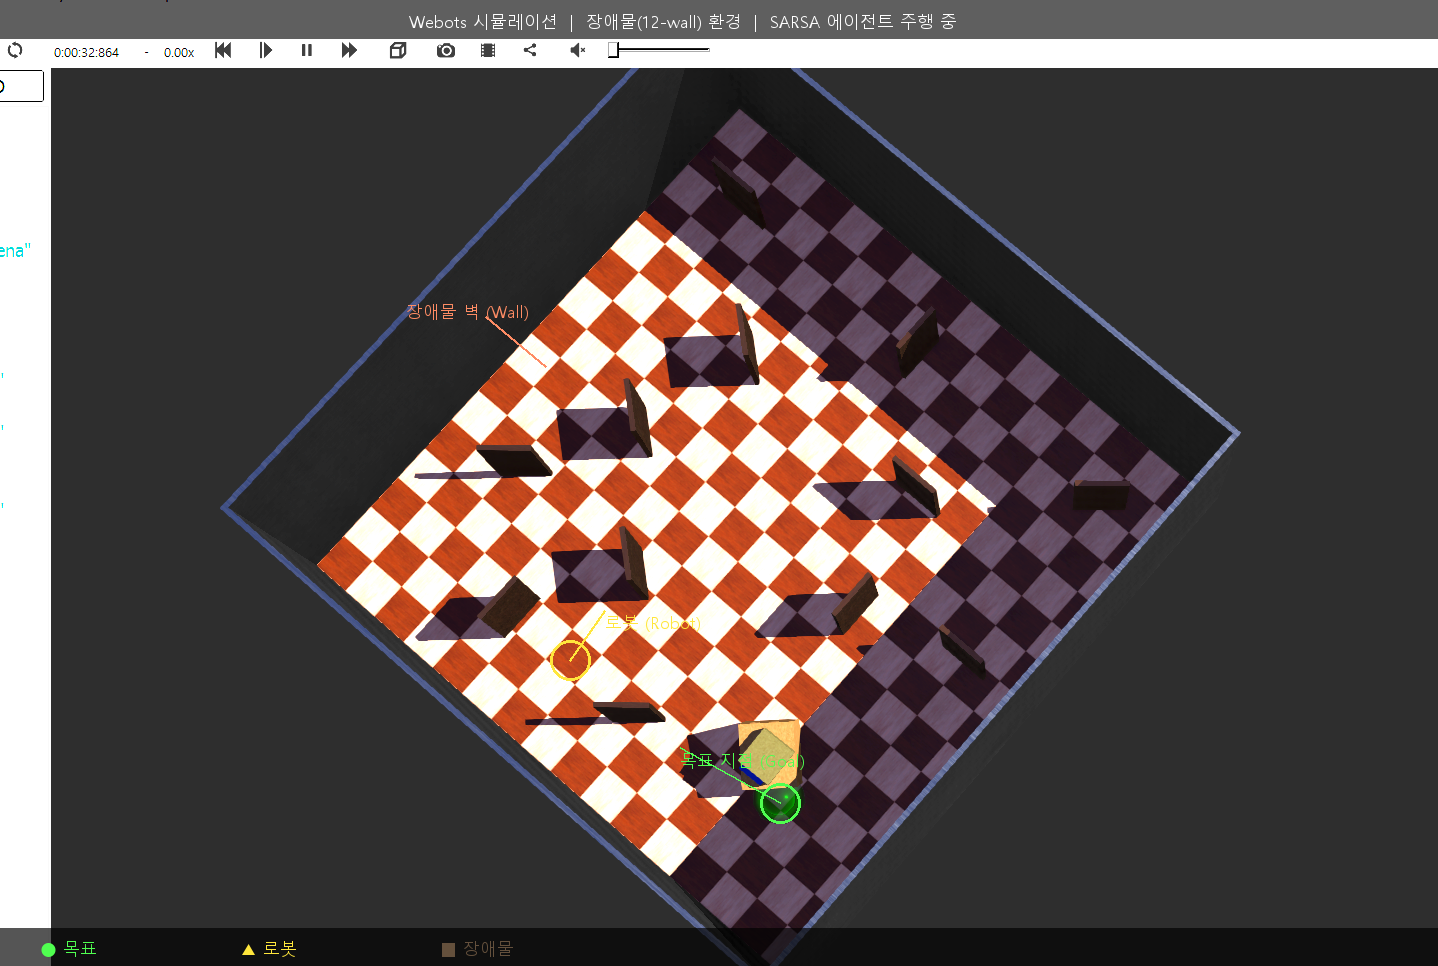
[Robótica Webots] Superando Mínimos Locales en 12 Obstáculos: Simulación Headless Multi-Semilla (#3)

· 3 min de lectura
Jihwan Park (jaybee)
AI & Robotics Engineer

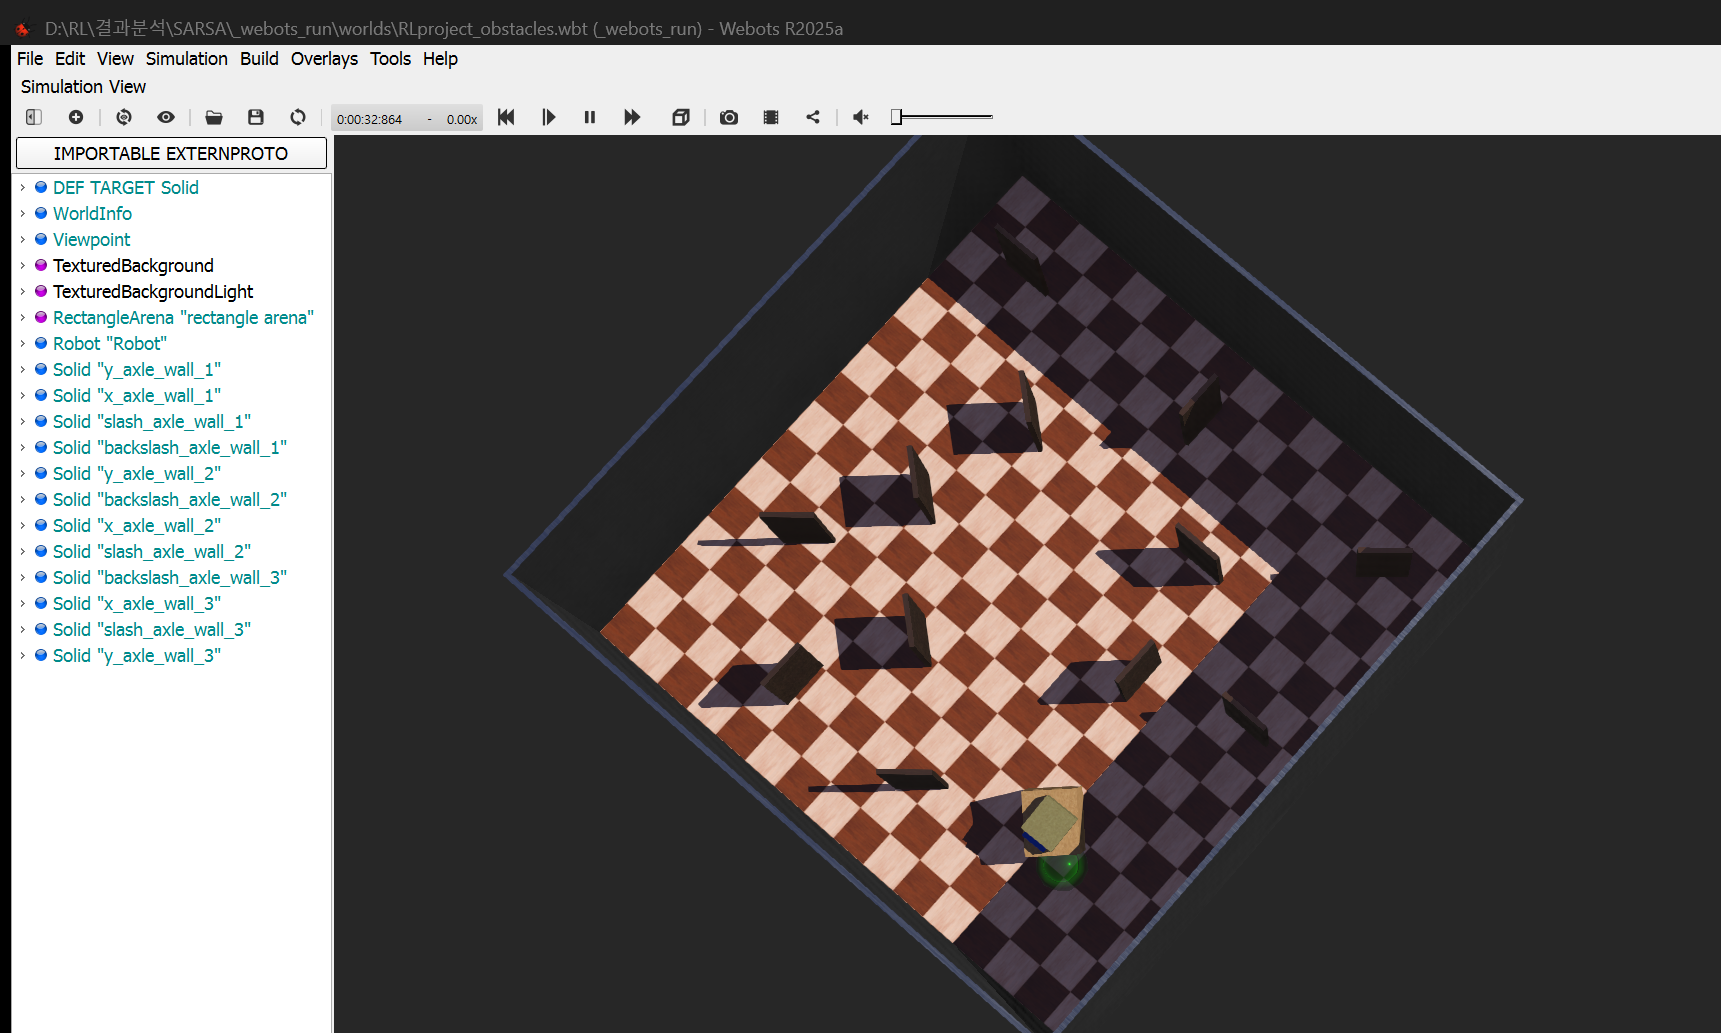
Entorno de Simulación obstacle12

📌 Puntos Clave (TL;DR)

  • Problema: Cuando el objetivo está detrás de un obstáculo, la búsqueda codiciosa de recompensas por delta de distancia (+0.1 × Δdist) empuja al robot a colisionar frontalmente, atrapándolo en un mínimo local (Local Minima).
  • Solución: Integración de percepción ultrasónica en 3 direcciones con barrido (frontal/izq/der) y propagación de valor a largo plazo (γ=0.99), junto con una canalización automatizada en PowerShell (headless_run.ps1) para entrenar en modo Headless con 3 semillas (0, 1, 2).
  • Resultado: El robot aprendió políticas de desvío efectivas en el cuadrilátero con 12 paredes, superando el 90% de tasa de éxito tras 600 episodios.

[Robótica Webots] Implementación de Q-Learning Tabular y Ajuste de la Función de Recompensa (#2)

· 3 min de lectura
Jihwan Park (jaybee)
AI & Robotics Engineer

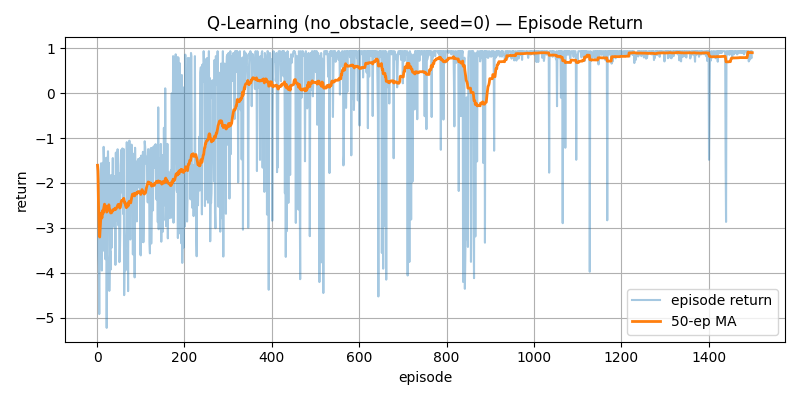
Curva de Recompensa

📌 Puntos Clave (TL;DR)

  • Problema: Las recompensas dispersas (+1.0 en la meta, -1.0 en colisión) generan grandes retrasos de exploración, provocando que el robot deambule durante miles de episodios antes de encontrar el objetivo.
  • Solución: Diseño de un esquema de Recompensas Densas (Reward Shaping) que combina recompensas proporcionales a la reducción de distancia euclidiana (+0.1 × Δdist) con penalizaciones por paso (-0.01), giro (-0.01) y retroceso (-0.05), junto con decaimiento exponencial de epsilon (1.0 → 0.05).
  • Resultado: La recompensa promedio móvil alcanzó valores positivos estables (0.7+) antes de los 500 episodios en el escenario no_obstacle, superando el 98% de tasa de éxito.

[Robótica Webots] Navegación Autónoma con Q-Learning: Discretización de 648 Estados y Arquitectura de Sockets (#1)

· 4 min de lectura
Jihwan Park (jaybee)
AI & Robotics Engineer

Entorno de Simulación Webots

📌 Puntos Clave (TL;DR)

  • Problema: Las lecturas continuas de sensores (distancia y orientación) provocan una explosión del espacio de estados para el Q-Learning tabular, y la sincronización con el simulador Webots requiere una comunicación de baja latencia.
  • Solución: Diseño de un mapeador de sensores continuos en 5 dimensiones que produce 3 × 8 × 3 × 3 × 3 = 648 estados discretos (discretizer.py) y una canalización IPC mediante sockets TCP (puerto 5000, JSON delimitado por líneas).
  • Resultado: Indexación ultrarrápida de la tabla Q en tiempo O(1) y sincronización física estable en pasos de 32 ms entre el simulador y el agente Python.