[Robótica Webots] Implementación de Q-Learning Tabular y Ajuste de la Función de Recompensa (#2)
· 3 min de lectura

📌 Puntos Clave (TL;DR)
- Problema: Las recompensas dispersas (+1.0 en la meta, -1.0 en colisión) generan grandes retrasos de exploración, provocando que el robot deambule durante miles de episodios antes de encontrar el objetivo.
- Solución: Diseño de un esquema de Recompensas Densas (Reward Shaping) que combina recompensas proporcionales a la reducción de distancia euclidiana (+0.1 × Δdist) con penalizaciones por paso (-0.01), giro (-0.01) y retroceso (-0.05), junto con decaimiento exponencial de epsilon (1.0 → 0.05).
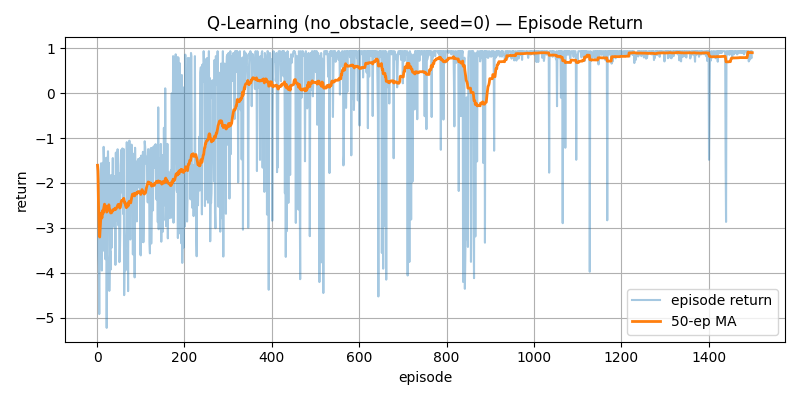
- Resultado: La recompensa promedio móvil alcanzó valores positivos estables (0.7+) antes de los 500 episodios en el escenario
no_obstacle, superando el 98% de tasa de éxito.