[Stanford CS329A #6] Escalado en Entrenamiento y RL: DeepSeekMath, GRPO y Optimización de Razonamiento a Gran Escala

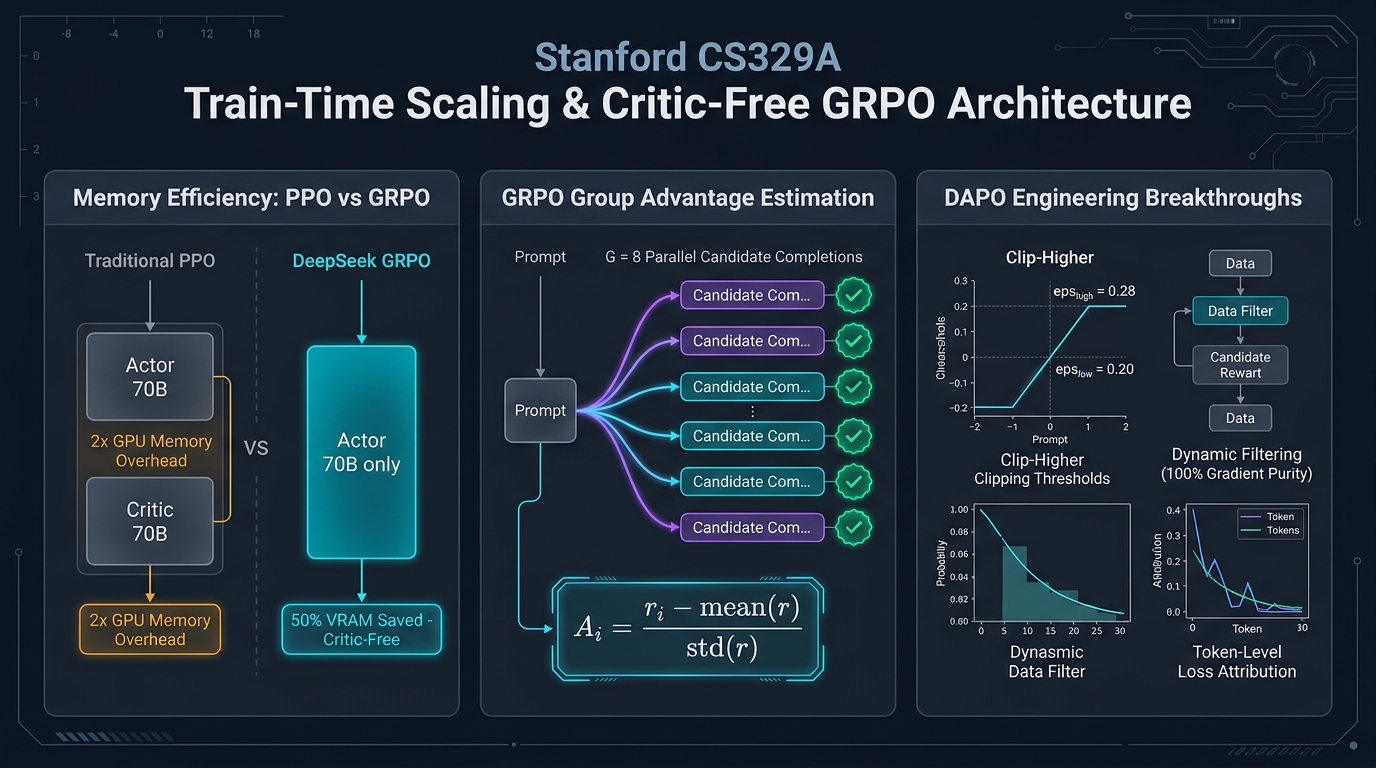
Bienvenidos a la sexta entrega de nuestro análisis técnico del curso de posgrado de la Universidad de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA que se Perfeccionan a Sí Mismos, Otoño 2025).
A lo largo de las Clases 1 a 5 (Parte 1: Fundamentos), estudiamos cómo exprimir al máximo la capacidad de modelos preentrenados y congelados mediante el cómputo en inferencia (Test-time Compute): explorando árboles de búsqueda con MCTS, recopilando diagnósticos de compiladores y podando caminos fallidos.
Sin embargo, debemos afrontar una verdad matemática ineludible: Si a un estudiante de primaria se le otorgan diez minutos adicionales durante un examen, no será capaz de deducir una demostración compleja de cálculo infinitesimal. Si el modelo carece en sus sinapsis neuronales congeladas (parámetros de peso, $\theta$) de los conceptos matemáticos fundamentales, muestrear miles de rutas o forzar búsquedas exhaustivas no produce verdadera inteligencia: engendra pura suerte estocástica.
Hoy inauguramos la Parte 2: Entrenamiento y Evolución (Clases 6 a 9), abordando la cuestión central de la autonomía:
«En lugar de gastar enormes recursos de cómputo en cada inferencia, ¿cómo podemos invertir cómputo masivo durante el entrenamiento para reescribir de forma permanente los pesos neuronales del modelo y convertirlo en un razonador de élite?»
En esta Clase 6, desmantelamos los tres pilares algorítmicos que rompieron las limitaciones de la anotación humana y revolucionaron el razonamiento mediante Aprendizaje por Refuerzo Posterior al Entrenamiento (Post-Training RL):
- Autoarranque del razonamiento: Self-Taught Reasoner (STaR, Zelikman et al., Stanford 2022).
- La muerte de la red crítica (Critic): Group Relative Policy Optimization (GRPO, DeepSeekMath 2024).
- Ingeniería industrial a escala de 1.000 GPUs: Recorte desacoplado y muestreo dinámico (DAPO, 2025).
flowchart TD
    subgraph ParadigmShift ["Cambio de Paradigma: Cómputo en Inferencia vs Entrenamiento"]
        direction TB
        TestTime["Parte 1: Escalado en Inferencia (Test-Time Scaling)<br/>• Pesos neuronales congelados (θ = constante)<br/>• Búsqueda externa en ejecución (MCTS, ReAct, RLEF)<br/>• Elevada latencia de respuesta y coste de despliegue"]
        --> TrainTime["Parte 2: Escalado en Entrenamiento (Train-Time RL)<br/>• Optimización activa de gradientes de peso (θ ← θ + Δθ)<br/>• Interiorización sináptica de la intuición estratégica vía RL<br/>• Inferencia ultrarrápida en una sola pasada (Single-Pass)"]
    end

    subgraph RLEvolution ["Evolución del Aprendizaje por Refuerzo en Razonamiento"]
        direction TB
        M1["STaR (Stanford 2022)<br/>• Autoaprendizaje a partir de razonamientos correctos propios<br/>• Racionalización: deducción inversa guiada por pistas<br/>• Modelo de 6B iguala a GPT-3 de 175B en CommonsenseQA"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• Eliminación total del modelo crítico (Ahorro del 50% de VRAM)<br/>• Ventaja relativa intra-grupo calculada mediante Z-scores<br/>• Modelo de 7B de pesos abiertos supera a Google Minerva 540B"]
        --> M3["DAPO (Ingeniería Abierta a Gran Escala 2025)<br/>• Recorte asimétrico Clip-Higher para evitar colapso de entropía<br/>• Muestreo dinámico que filtra lotes de varianza cero<br/>• Qwen-32B supera el récord de DeepSeek-R1-Zero en AIME"]
    end

    ParadigmShift ==> RLEvolution