[Stanford CS329A #5] Planificación Multietapa y Búsqueda en Árbol: ADaPT, LATS, SPRINT y MCTS para Agentes

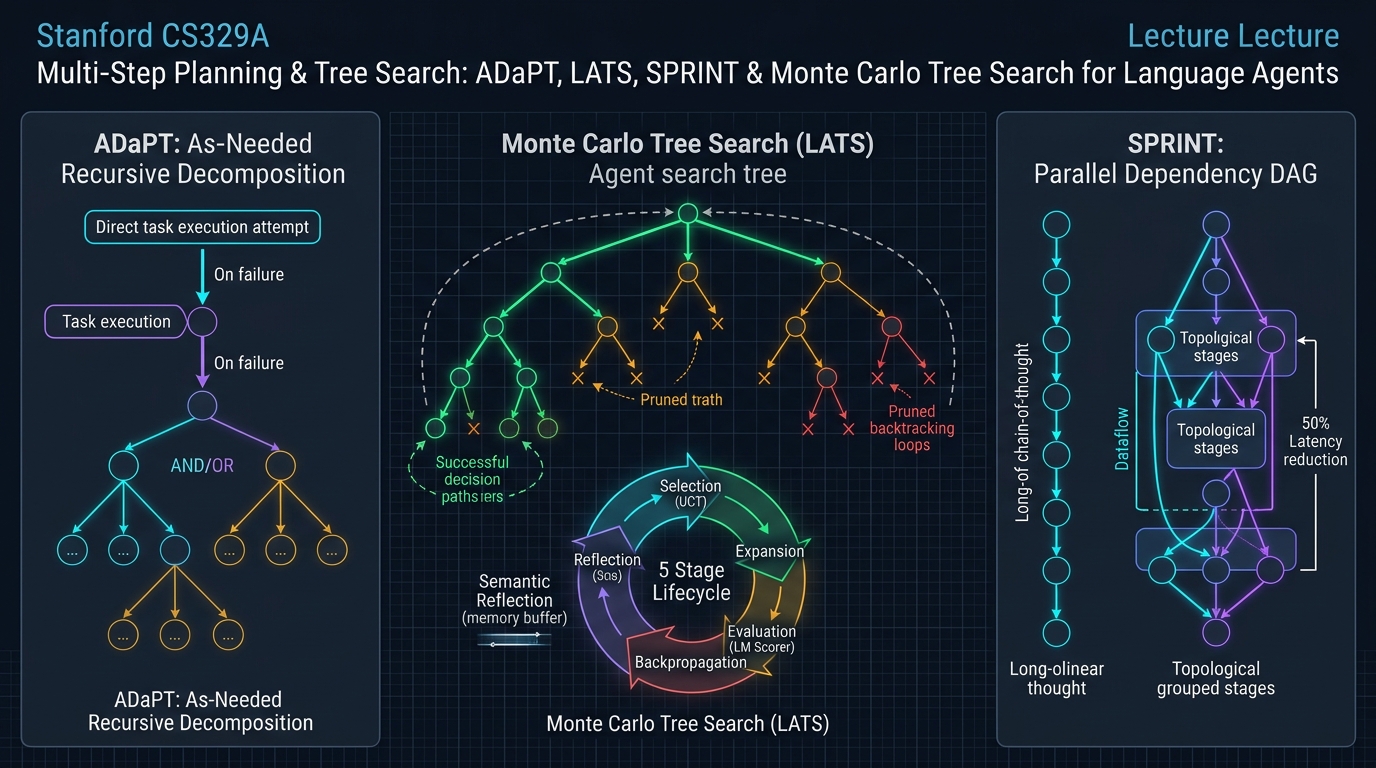
Bienvenidos a la quinta entrega de nuestro análisis técnico del curso de posgrado de la Universidad de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA que se Perfeccionan a Sí Mismos, Otoño 2025).
En la Clase 4 exploramos cómo los agentes escapan del confinamiento de la memoria estática mediante el uso de herramientas y bucles de retroalimentación de compiladores (ReAct, RLEF). Sin embargo, reparar un error puntual de sintaxis dista enormemente de diseñar un sistema de software distribuido de 100.000 líneas o resolver problemas científicos de largo horizonte.
Los enfoques estándar basados en ReAct o Chain-of-Thought (CoT) son intrínsecamente buscadores codiciosos (Greedy) de ruta única: evalúan el paso inmediato siguiente y avanzan de forma irreversible. Al igual que un principiante de ajedrez que solo contempla el siguiente movimiento y cae en jaque mate tres turnos después, un modelo autorregresivo que comete un error en una derivación inicial queda irremediablemente atrapado en un callejón sin salida.
La Clase 5 constituye el gran cierre de la Parte 1 (Fundamentos) del plan de estudios: la Planificación Multietapa (Multi-Step Planning) y la Búsqueda en Árbol (Tree Search).
Al trasladar el motor matemático de AlphaGo—la Búsqueda en Árbol de Monte Carlo (MCTS)—a los modelos autorregresivos, convertimos a los generadores de texto en grandes maestros estratégicos. Analizamos arquitecturas que anticipan consecuencias decenas de pasos por adelantado, podan ramas infructuosas, retroceden sobre árboles de decisión y paralelizan flujos de razonamiento:
- Unificación de razonamiento, acción y planificación: Language Agent Tree Search (LATS, Zhou et al., 2023).
- Descomposición recursiva bajo demanda: Desglose modular activado únicamente ante el fallo mediante ADaPT (Allen AI, 2023).
- Empaquetado de DAGs de dependencias en paralelo: Reducción de la latencia de inferencia en un 53.5% mediante SPRINT (Stanford Future Data, 2025).
- Bifurcación adaptativa mediante Muestreo de Thompson: Resolución del dilema entre amplitud y profundidad con AB-MCTS (Sakana AI, 2025).
- Interiorización de la planificación en los pesos: SWiRL (Step-Wise RL, 2025).
flowchart TD
    subgraph MCTS_Loop ["Ciclo de Vida MCTS del Agente LATS"]
        direction TB
        Root["Estado Raíz: Objetivo del Usuario / PRD"]
        --> Select["1. Selección: Navegación mediante Métrica UCT"]
        --> Expand["2. Expansión: Muestreo de n Acciones Candidatas"]
        --> Eval["3. Evaluación: Puntuación del Modelo + Consistencia"]
        --> Backprop["4. Retrorretropropagación: Actualización de Valores"]
        --> Reflect["5. Reflexión Semántica: Diagnóstico Lingüístico de Fallos"]
    end

    subgraph PlanningParadigms ["Espectro de Planificación para Agentes"]
        direction TB
        P1["LATS (Búsqueda en Árbol MCTS)<br/>• Reversibilidad sin coste basada en historial de prompts<br/>• HumanEval al 92.7%; HotpotQA salta del 32% al 71%"]
        --> P2["ADaPT (Descomposición Bajo Demanda)<br/>• Evita planes rígidos a priori; ejecuta en un solo paso primero<br/>• Desglose recursivo AND/OR desencadenado solo ante fallos"]
        --> P3["SPRINT (Empaquetado de DAGs en Paralelo)<br/>• Identifica pasos de razonamiento mutuamente independientes<br/>• Ejecución concurrente en clústeres GPU; recorta latencia un 53.5%"]
        --> P4["SWiRL (Aprendizaje por Refuerzo Paso a Paso)<br/>• Interioriza la sabiduría de búsqueda MCTS en los pesos neuronales<br/>• Inferencia en una sola pasada con visión estratégica profunda"]
    end

    MCTS_Loop ==> PlanningParadigms