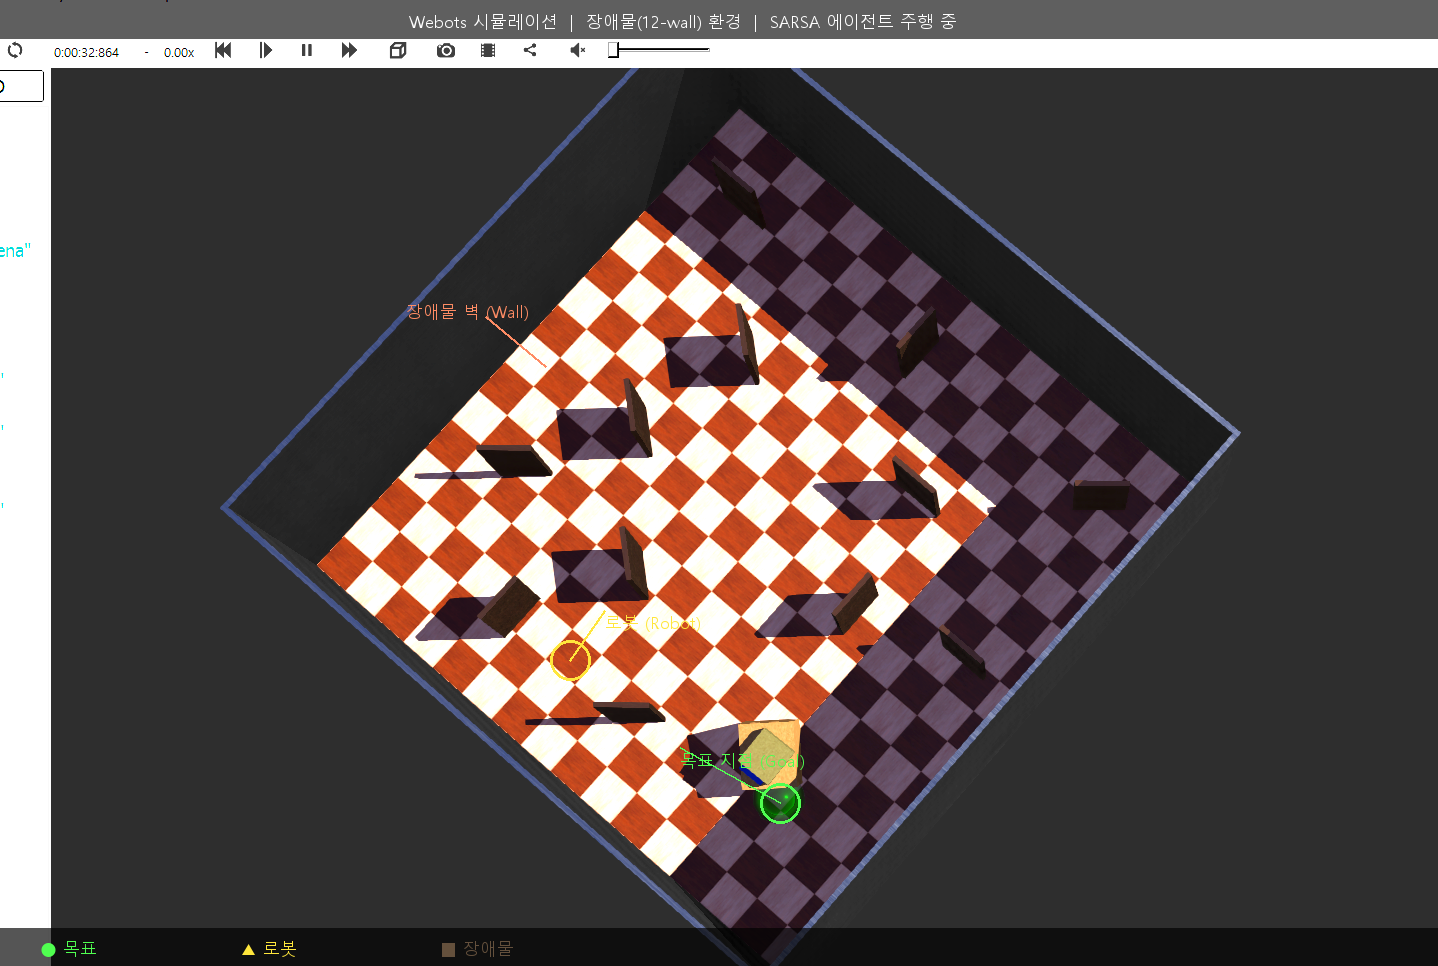
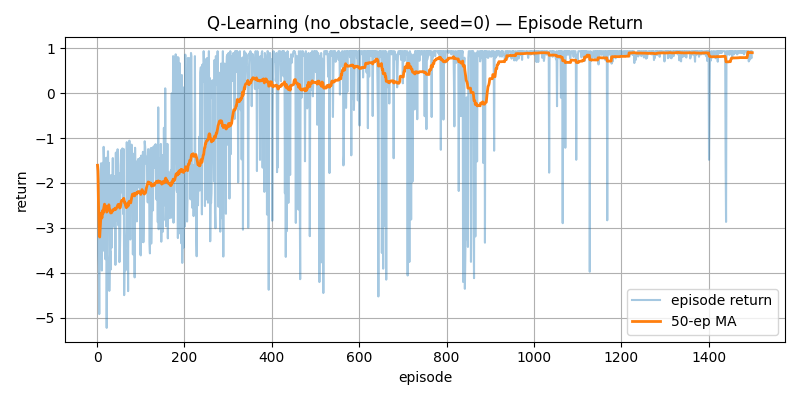
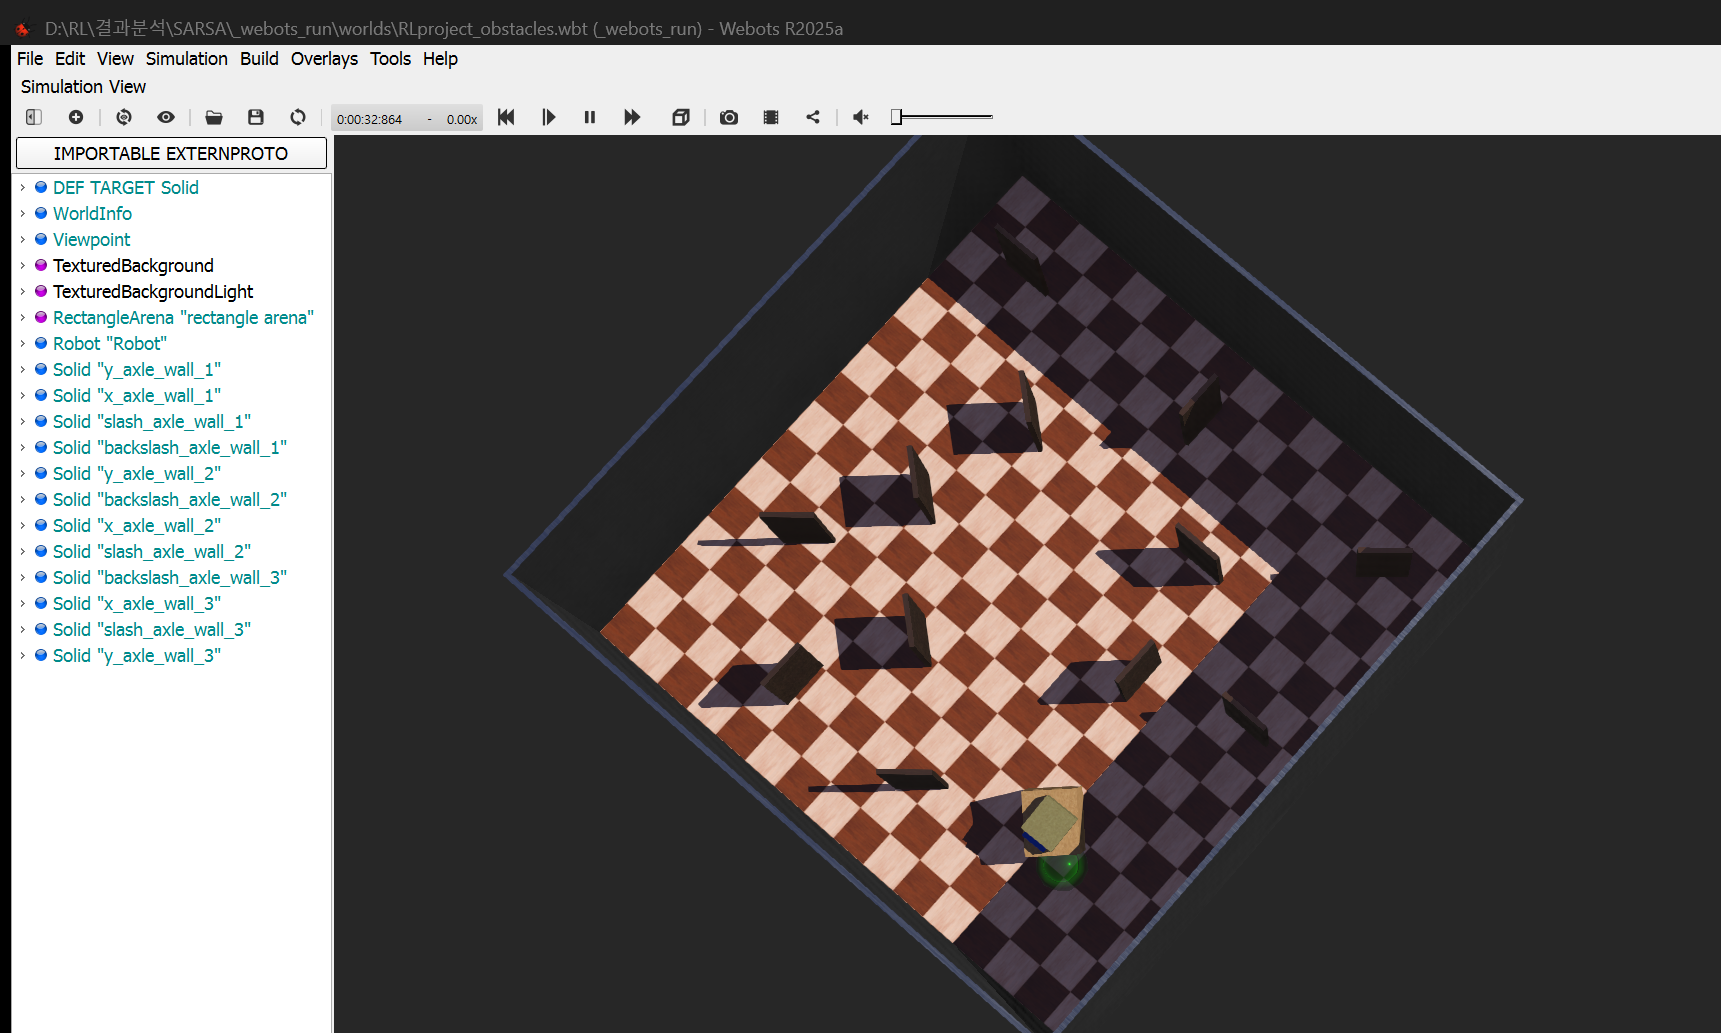
[Robótica Webots] Evaluación Determinista con evaluate_qlearning y Comparativa frente a DQN y SARSA (#4)
· 2 min de lectura

📌 Puntos Clave (TL;DR)
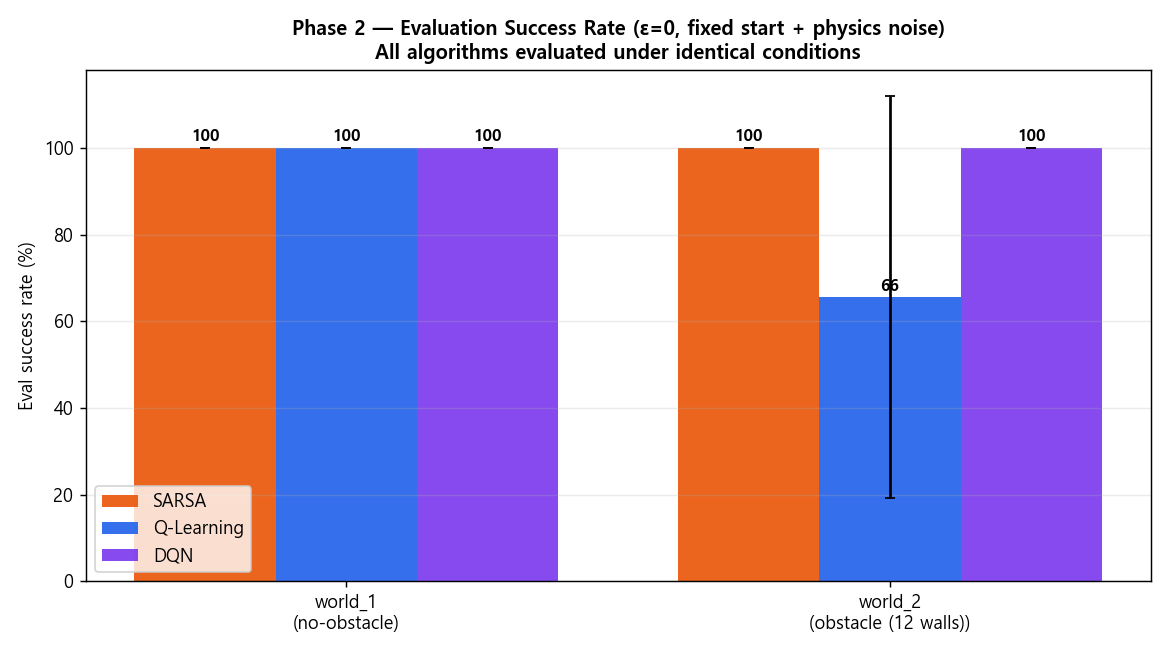
- Objetivo: Medir el desempeño puro y determinista de la política voraz aprendida (ε=0) sin ruido exploratorio, validando su viabilidad de despliegue.
- Metodología: Implementación de
evaluate_qlearning.pycon 30 pruebas independientes distribuidas en 5 semillas de evaluación, monitoreando tasa de éxito, eficiencia de ruta frente a la distancia mínima teórica y conteo de aproximaciones críticas (near-miss).- Resultado: Q-Learning tabular alcanzó un 93.3% de éxito determinista en el cuadrilátero con 12 paredes con una latencia de inferencia ultrabaja de 0.02 ms, superando a modelos más pesados como DQN y SARSA.