[Stanford CS329A #3] Verificación Robusta: Modelos de Recompensa de Proceso (PRM), Ensembles y Supervisión Escalable

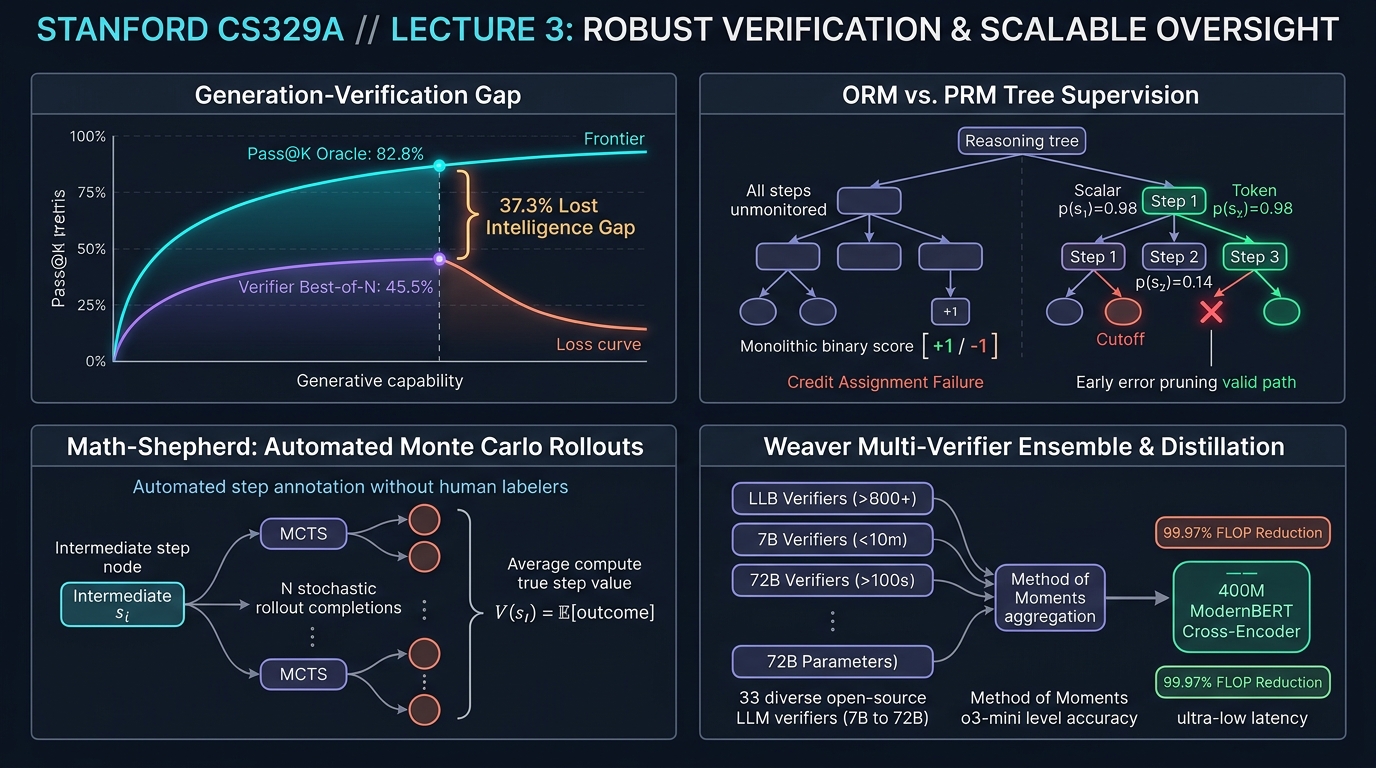
Bienvenidos a la tercera entrega de nuestro análisis exhaustivo de ingeniería sobre el curso de posgrado de la Universidad de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA con Automejora, Otoño 2025).
En la Clase 2, exploramos el escalado de cómputo en inferencia y alcanzamos una conclusión fundamental: aunque generar miles de trayectorias ($pass@k$) eleva la cobertura teórica por encima del 99%, este potencial latente resulta inutilizable sin un verificador de alta precisión. Al aplicar heurísticas como la votación por mayoría, el rendimiento choca contra una meseta insuperable.
Hoy abordamos el motor arquitectónico que rompe este cuello de botella: la Verificación Robusta (Robust Verification).
Los matemáticos e ingenieros humanos rara vez resuelven problemas complejos en un flujo unidireccional irreflexivo; desarrollan un paso, comprueban su consistencia algebraica, detectan errores sutiles de signos y retroceden (backtracking) antes de proseguir. Por el contrario, los modelos de lenguaje autorregresivos estándar generan texto estrictamente hacia adelante. Una vez que un paso inicial desvía el razonamiento, el modelo inventa alucinaciones cada vez más complejas para justificar su error original.
¿Cómo podemos diseñar modelos verificadores independientes capaces de auditar los pasos intermedios, diagnosticar falacias lógicas y guiar a los agentes hacia soluciones matemáticamente sólidas sin incurrir en millones de dólares de etiquetado humano?
A través de las investigaciones de Cobbe et al. (GSM8K, OpenAI, 2021), la supervisión de procesos de Lightman et al. (PRM800K, 2023), la anotación automatizada por Monte Carlo de Math-Shepherd (Yu et al., 2023) y el vanguardista marco de ensamble Weaver (NeurIPS 2025), dominaremos los fundamentos de la Ingeniería de Verificadores.
flowchart TD
    subgraph Gap ["El Problema Central: Brecha Generación-Verificación"]
        direction TB
        G1["Pass@100 Cobertura Oráculo: 82.8% (Límite Superior Teórico)"]
        G2["Precisión Real por Votación de Mayoría: 45.5% (Extracción Real)"]
        G1 -.->|"37.3%p de Inteligencia Perdida por Error de Selección"| G2
    end

    subgraph Solutions ["Evolución de la Verificación en 4 Fases"]
        direction TB
        S1["Modelos de Recompensa de Resultado (ORM)<br/>• Puntuación binaria al final (+1 / -1)<br/>• Fallo de Asignación de Crédito (Credit Assignment Failure)"]
        --> S2["Modelos de Recompensa de Proceso (PRM800K)<br/>• Supervisión a nivel de paso p(step_i)<br/>• Poda temprana de ramas y regla del producto"]
        --> S3["Math-Shepherd (MCTS No Supervisado)<br/>• Rollouts de Monte Carlo automatizados<br/>• Supera a los PRMs anotados por humanos"]
        --> S4["Ensamble de Verificadores Débiles Weaver<br/>• Método de los Momentos (33 verificadores débiles)<br/>• Destilación en Cross-Encoder de 400M (reducción de 99.97% FLOPs)"]
    end

    Gap ==> Solutions