Saltar al contenido principal

2 publicaciones etiquetados con "test-time-compute"

Ver Todas las Etiquetas

[Stanford CS329A #2] Escalado del Cómputo en Tiempo de Inferencia: Más Allá del Preentrenamiento hacia la Inferencia Óptima

· 13 min de lectura
Jaybee
AI & Robotics Engineer

Stanford CS329A Test-Time Compute Scaling

Bienvenidos a la segunda entrega de nuestro análisis definitivo de ingeniería sobre el curso de posgrado de la Universidad de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA con Automejora, Otoño 2025).

En nuestra clase inaugural, analizamos el cambio de paradigma macroeconómico que transforma los modelos estáticos de predicción del siguiente token en bucles agénticos autónomos con retroalimentación del entorno. Hoy nos enfrentamos al pilar computacional que hace viable esta autonomía: el Escalado del Cómputo en Tiempo de Inferencia (Test-Time Compute Scaling).

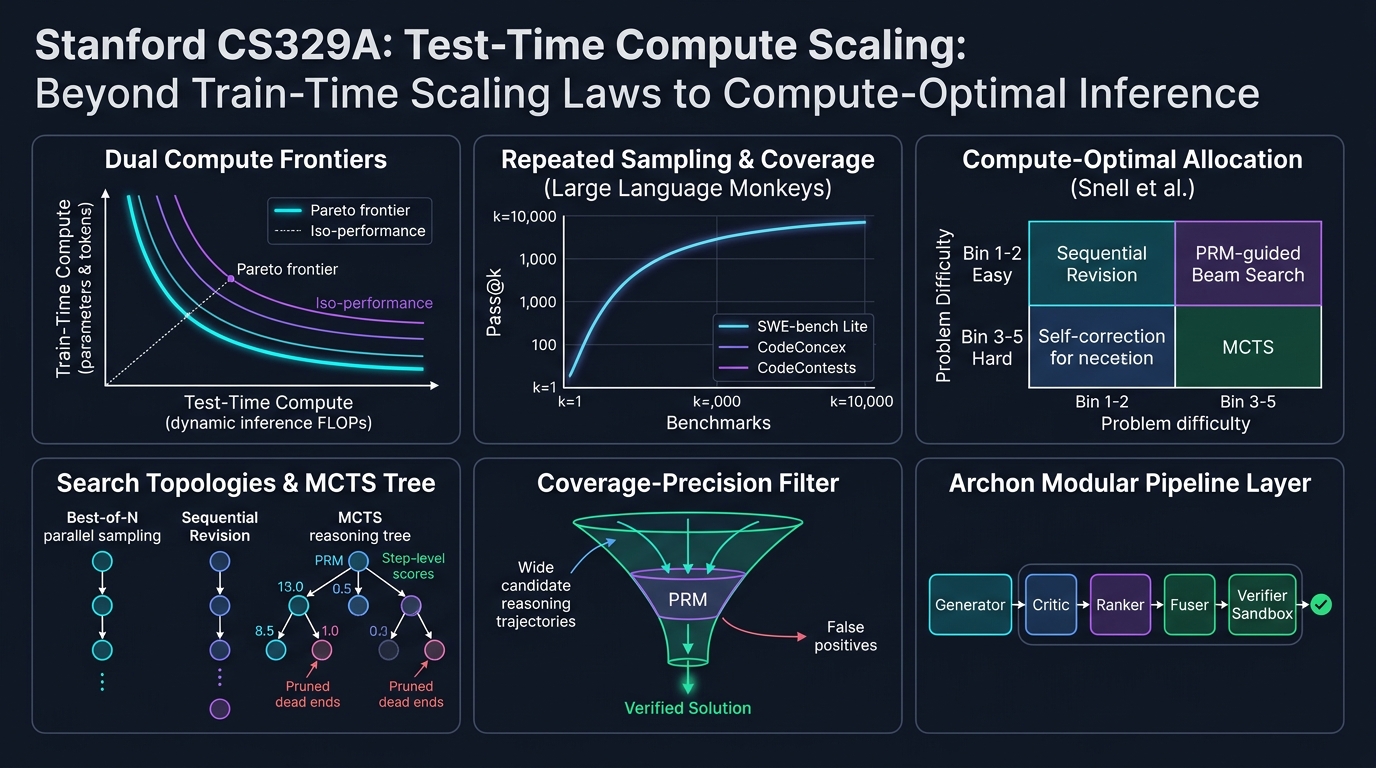
Durante más de un lustro, la doctrina imperante en la industria de la IA estuvo dictada por las leyes de escalado del preentrenamiento (Kaplan et al., Chinchilla): construir clústeres de GPUs masivos, expandir la huella de parámetros N y absorber decenas de billones de tokens web. Sin embargo, una vez congelados los parámetros θ del modelo, ¿qué ocurre si nos negamos a aceptar una respuesta voraz (greedy) en 50 milisegundos? ¿Qué sucede si el agente dedica 10 segundos, 1 minuto o 10 minutos a explorar deliberadamente árboles de razonamiento, verificar pasos intermedios y revisar sus hipótesis antes de comprometerse con una acción?

A través de los descubrimientos empíricos de Large Language Monkeys (Brown et al., 2024), el Compute-Optimal Scaling de Snell et al. (Stanford/UC Berkeley, 2024) y el marco de arquitectura modular Archon, formalizaremos matemáticamente cómo el intercambio de FLOPs de inferencia por capacidad de parámetros está redefiniendo la inteligencia artificial moderna.

flowchart TD
subgraph PreTrain ["Frontera Clásica: Escalado en Tiempo de Entrenamiento"]
direction TB
P1["Billones de Tokens Web (D)"] --> P2["Clústeres Masivos de GPU (C_train)"]
P2 --> P3["Modelo Denso Congelado (θ)"]
P3 --> P4["Pase Hacia Adelante Único Voraz (Cómputo Fijo O(1))"]
end

subgraph TestTime ["Frontera CS329A: Escalado en Tiempo de Inferencia"]
direction TB
T1["Pesos Base Congelados (θ)"] --> T2["Asignación Dinámica de FLOPs en Inferencia"]
T2 --> T3{"Selección Adaptativa por Dificultad"}
T3 -- "Baja Dificultad (Bin 1-2)" --> T4["Revisión Secuencial (Autocorrección)"]
T3 -- "Alta Dificultad (Bin 3-5)" --> T5["Búsqueda en Árbol Guiada por PRM (MCTS / Beam Search)"]
T4 --> T6["Verificador de Modelo de Recompensa de Proceso (PRM)"]
T5 --> T6
T6 --> T7["Solución Extraída y Verificada Mecánicamente"]
end

PreTrain -.->|"Punto de Inflexión: Saturación de Parámetros"| TestTime
[Stanford CS329A #1] Descripción General del Curso: De Modelos de Lenguaje Masivos a Agentes de IA Autoevolutivos

· 12 min de lectura
Jaybee
AI & Robotics Engineer

Stanford CS329A Agentes de IA Autoevolutivos

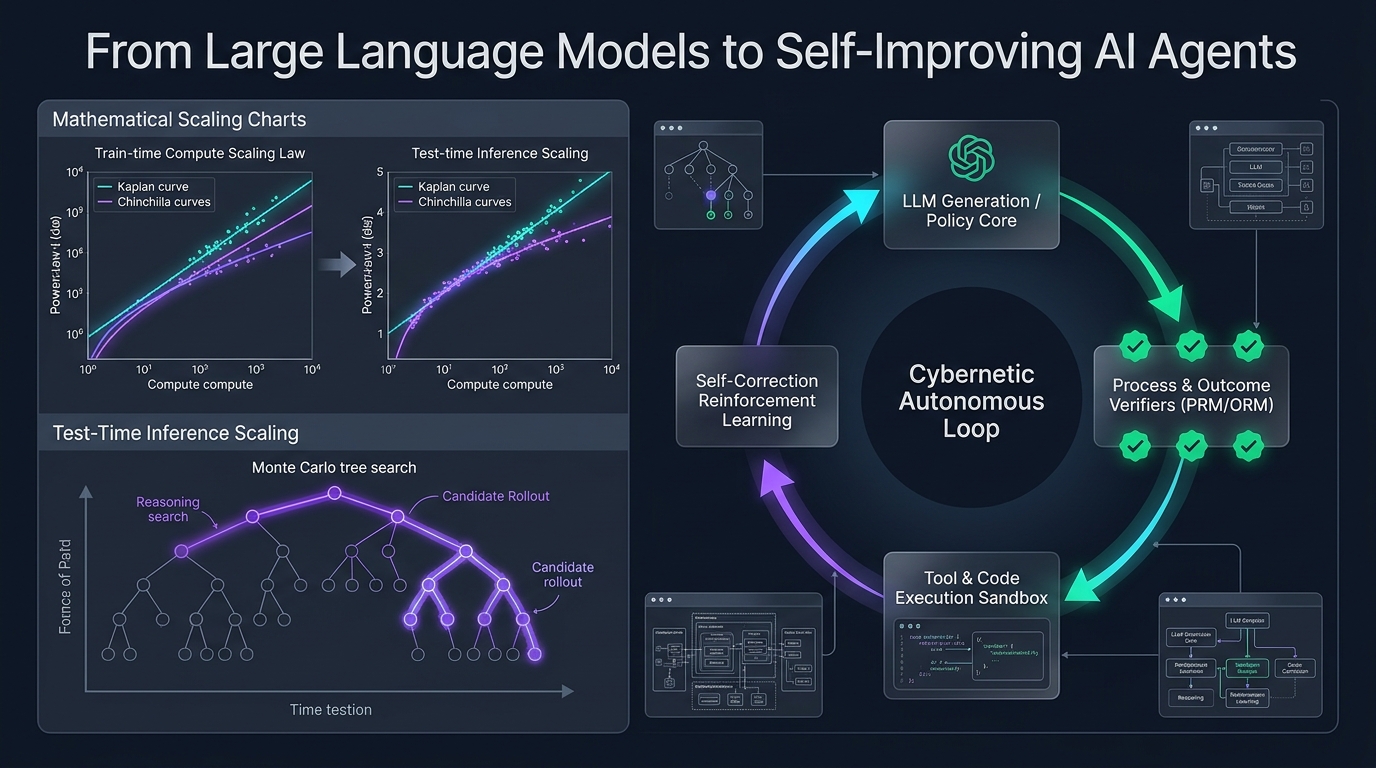
Bienvenidos al desglose técnico integral del curso CS329A de la Universidad de Stanford: Self-Improving AI Agents (Agentes de IA Autoevolutivos, Otoño 2025).

Durante los últimos cuatro años, el panorama de la inteligencia artificial ha estado dominado por un dogma potente y omnipresente: preentrenar modelos cada vez más grandes sobre corpus de texto colosales produce capacidades cognitivas crecientes de manera predecible. Si bien este paradigma impulsó la revolución de la IA generativa moderna —dando origen a sistemas como GPT-4, Claude 3.5 y Gemini—, la frontera de la investigación en aprendizaje automático ha alcanzado un punto de inflexión decisivo.

Los modelos fundacionales estáticos (Static Foundation Models), sin importar cuán astronómico sea su recuento de parámetros, poseen limitaciones intrínsecas insalvables: son predictores pasivos y autorregresivos del siguiente token que operan en un régimen de bucle abierto (open-loop). Una vez que sus pesos quedan congelados tras el entrenamiento, no pueden asignar dinámicamente más cómputo a problemas difíciles, no pueden verificar de forma autónoma la veracidad de sus deducciones, ni pueden corregir iterativamente sus propios errores mediante retroalimentación ambiental.

flowchart LR
subgraph Paradigma_Estatico ["Paradigma Estático Tradicional (2020-2024)"]
direction TB
A1[Corpus Web Masivo] --> B1[Clúster de Preentrenamiento]
B1 --> C1[Ajuste Fino Supervisado SFT]
C1 --> D1[Modelo Estático Congelado]
D1 -->|Pase Hacia Adelante Único| E1[Respuesta Textual Aislada]
end

subgraph Paradigma_Autonomo ["Frontera Stanford CS329A: Agentes Autoevolutivos"]
direction TB
A2[Objetivo Complejo] ==> B2[Motor de Razonamiento y Planificación]
B2 -->|Borrador de Acciones / Código| C2[Entorno Sandbox y Herramientas]
C2 -->|Trazas de Ejecución y Estado| D2[Verificadores de Procesos PRM]
D2 -->|Señales de Recompensa y Error| B2
D2 ==>|Actualizaciones en Inferencia y Entrenamiento| E2[Autoevolución Continua]
end

Stanford CS329A aborda la pregunta cardinal de la próxima década de la IA: ¿Cómo construimos agentes de software que no se limiten a generar texto, sino que inspeccionen, verifiquen, planifiquen y perfeccionen continuamente su propio razonamiento y código?

En esta conferencia inaugural, deconstruimos la trayectoria evolutiva desde los LLMs fundacionales hacia los sistemas agénticos, formalizamos la matemática de las leyes de escala y la asignación de cómputo en inferencia, analizamos los cuatro arquetipos de flujos de trabajo agénticos y aislamos el cuello de botella más crítico de la inteligencia autónoma: la Brecha Generador-Verificador (Generator-Verifier Gap).