[Stanford CS329A #4] Uso de Herramientas y Retroalimentación de Código: ReAct, RLEF y Autocorrección Constitucional

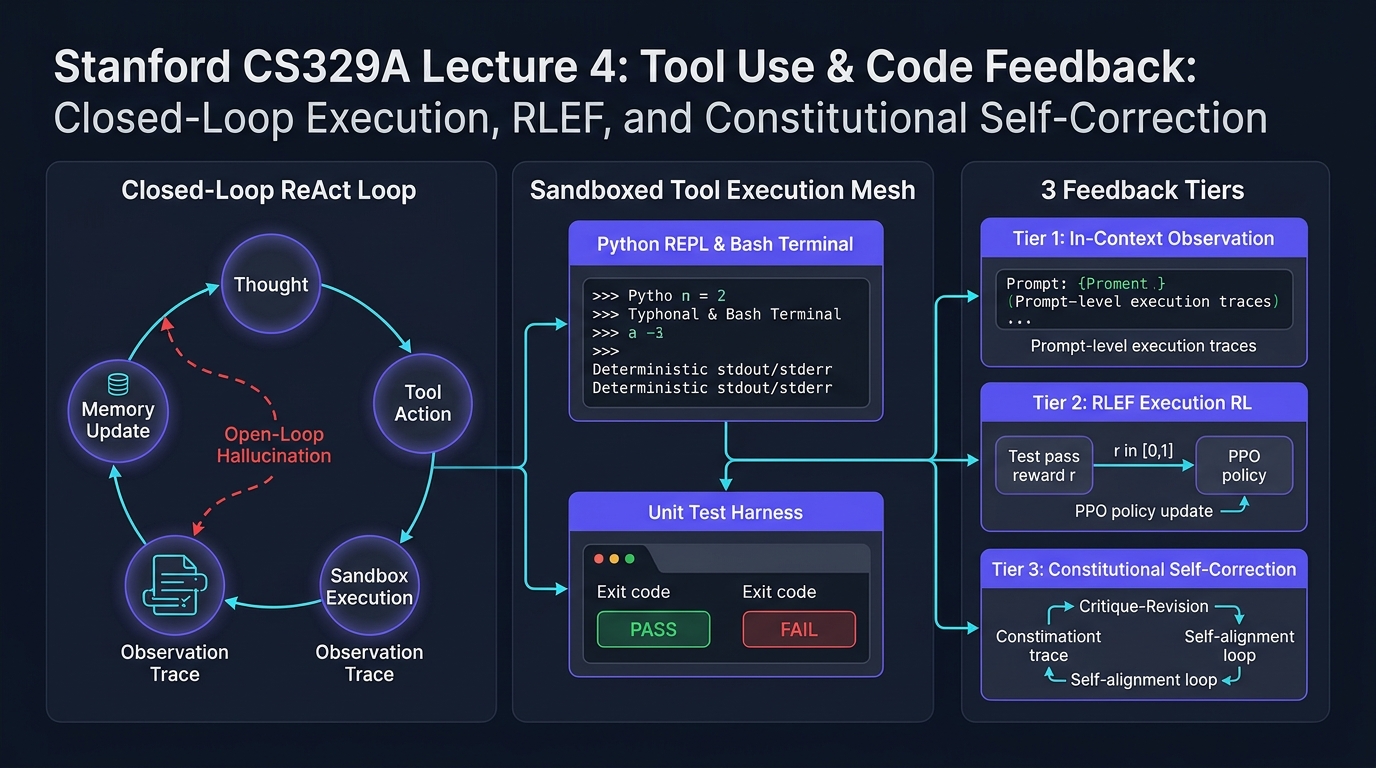
Bienvenidos a la cuarta entrega de nuestro análisis técnico exhaustivo del curso de posgrado de la Universidad de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA que se Perfeccionan a Sí Mismos, Otoño 2025).
En las Clases 2 y 3 exploramos cómo el escalado de cómputo en inferencia (Test-time Compute Scaling) y los Modelos de Recompensa de Proceso (PRM) permiten a los modelos de lenguaje explorar árboles de razonamiento y verificar rigurosamente derivaciones matemáticas intermedias. Sin embargo, a pesar de sus sofisticadas cadenas de pensamiento (CoT), los modelos confinados exclusivamente a la generación de texto puro siguen siendo "estudiantes encerrados en una habitación resolviendo exámenes". Dependen por completo de la memoria paramétrica estática y congelada adquirida durante el preentrenamiento. Ante hechos dinámicos del mundo real, APIs en constante cambio o restricciones sintácticas inflexibles en código ejecutable, un modelo aislado alucina inevitablemente al no tener contacto con sistemas reales.
La Clase 4 marca el punto de inflexión estructural que saca al modelo de ese confinamiento: el uso de herramientas (Tool Use) y los bucles de retroalimentación de ejecución (Execution Feedback Loops).
Los agentes autónomos modernos no tratan el código o las llamadas a APIs como meros textos terminales, sino como sensores y actuadores interactivos. En esta sesión, analizamos y rediseñamos los tres niveles fundamentales de retroalimentación para agentes:
- Retroalimentación ambiental a nivel de prompt: La unificación de razonamiento y acción mediante ReAct (Yao et al., 2022).
- Retroalimentación de ejecución a nivel de política: La incorporación directa de diagnósticos de compiladores y suites de prueba en los pesos neuronales mediante RLEF (Reinforcement Learning from Execution Feedback, 2024).
- Alineación de valores autosupervisada: La sustitución de costosos evaluadores humanos por bucles autónomos de crítica y revisión guiados por principios en Constitutional AI (Anthropic, 2022).
flowchart TD
    subgraph ClosedLoop ["Arquitectura de Agente en Bucle Cerrado (Closed-Loop)"]
        direction TB
        Agent["Núcleo del Agente Autónomo (Política LLM)"]
        Thought["Razonamiento Interno (Espacio de Pensamiento L)"]
        Action["Llamada Ejecutable a Herramienta (Espacio de Acción A)"]
        Sandbox["Entorno Aislado de Ejecución (Python REPL / Shell / Search)"]
        Obs["Observación Determinista del Entorno (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"Actualización de Contexto (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["Los 3 Niveles de Retroalimentación"]
        direction TB
        T1["Nivel 1: Retroalimentación Ambiental en Contexto (ReAct)<br/>• Bucle entrelazado de Pensamiento + Acción + Observación<br/>• Tasa de alucinación por invención de hechos reducida al 0%"]
        --> T2["Nivel 2: Retroalimentación de Ejecución en Política (RLEF)<br/>• Formulación MDP: Estado, Acción, Recompensa del Sandbox<br/>• Optimización PPO con división de pruebas públicas y privadas<br/>• Llama-3.1-70B salta del 27.5% al 40.1% en solo 1@3 intentos"]
        --> T3["Nivel 3: Autocorrección de Valores Autónomo (Constitutional AI)<br/>• Dataset SFT generado por crítica y revisión con axiomas constitucionales<br/>• Entrenamiento de modelo de preferencia mediante RLAIF<br/>• Eliminación total del cuello de botella de anotación humana"]
    end

    ClosedLoop ==> FeedbackTiers