[Registro de Desarrollo Maeumjigi #19] Automatización de Informes y Problemas de BD

¡Debo corregir mi suposición de que el 13 de mayo fue el último día! El 17 de mayo hubo una ola masiva de pruebas de backend y redacción de informes.
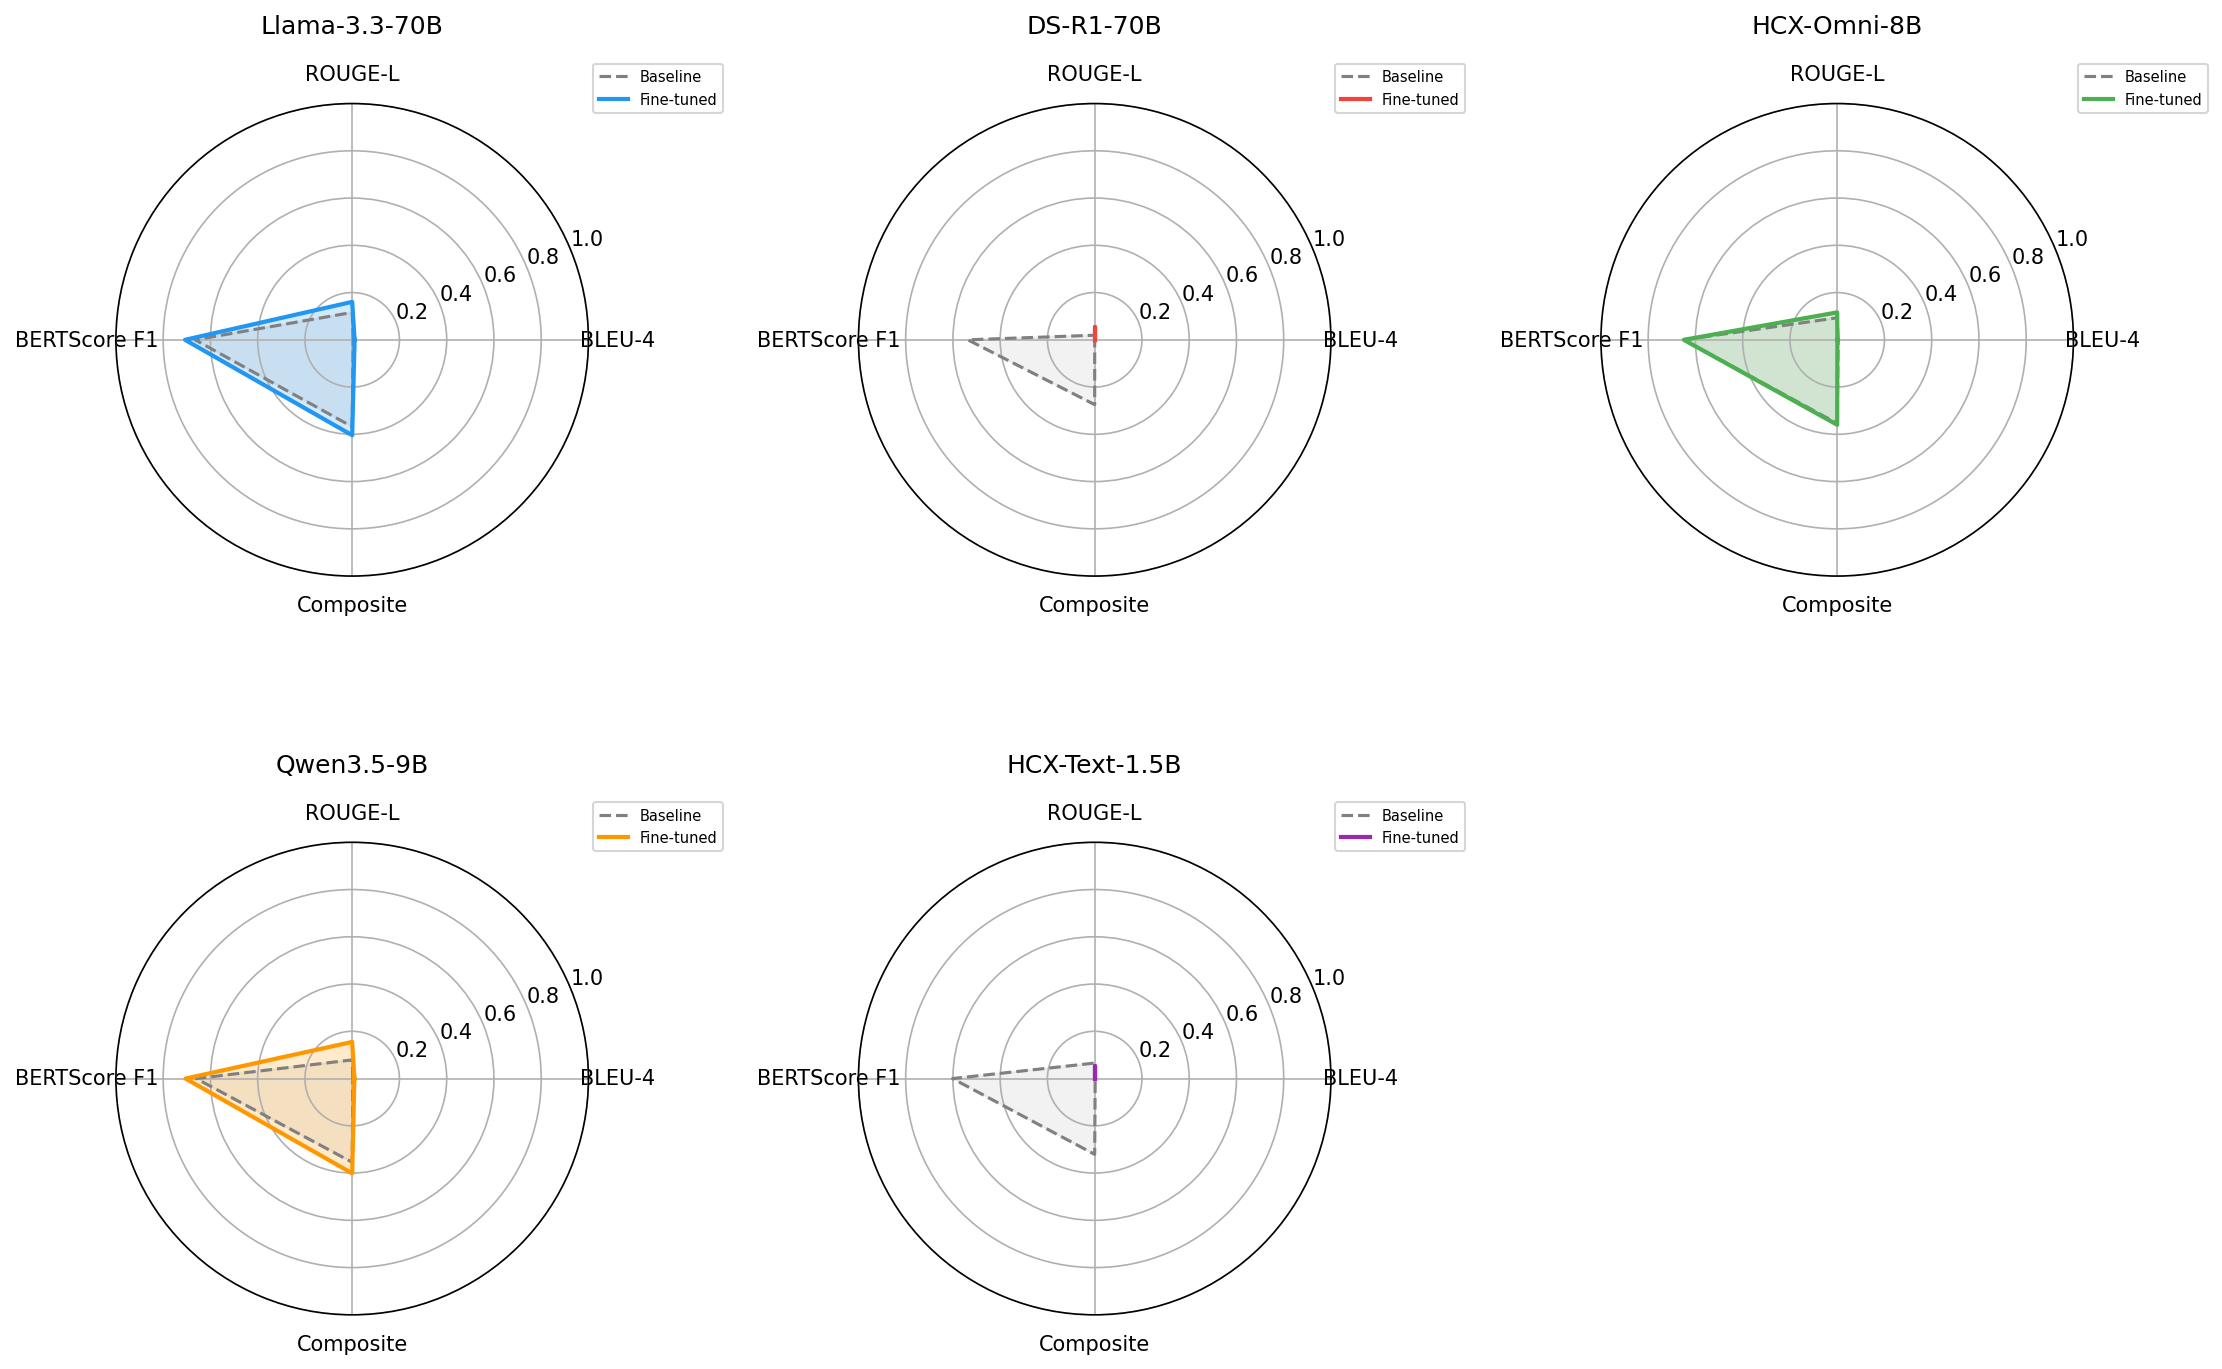
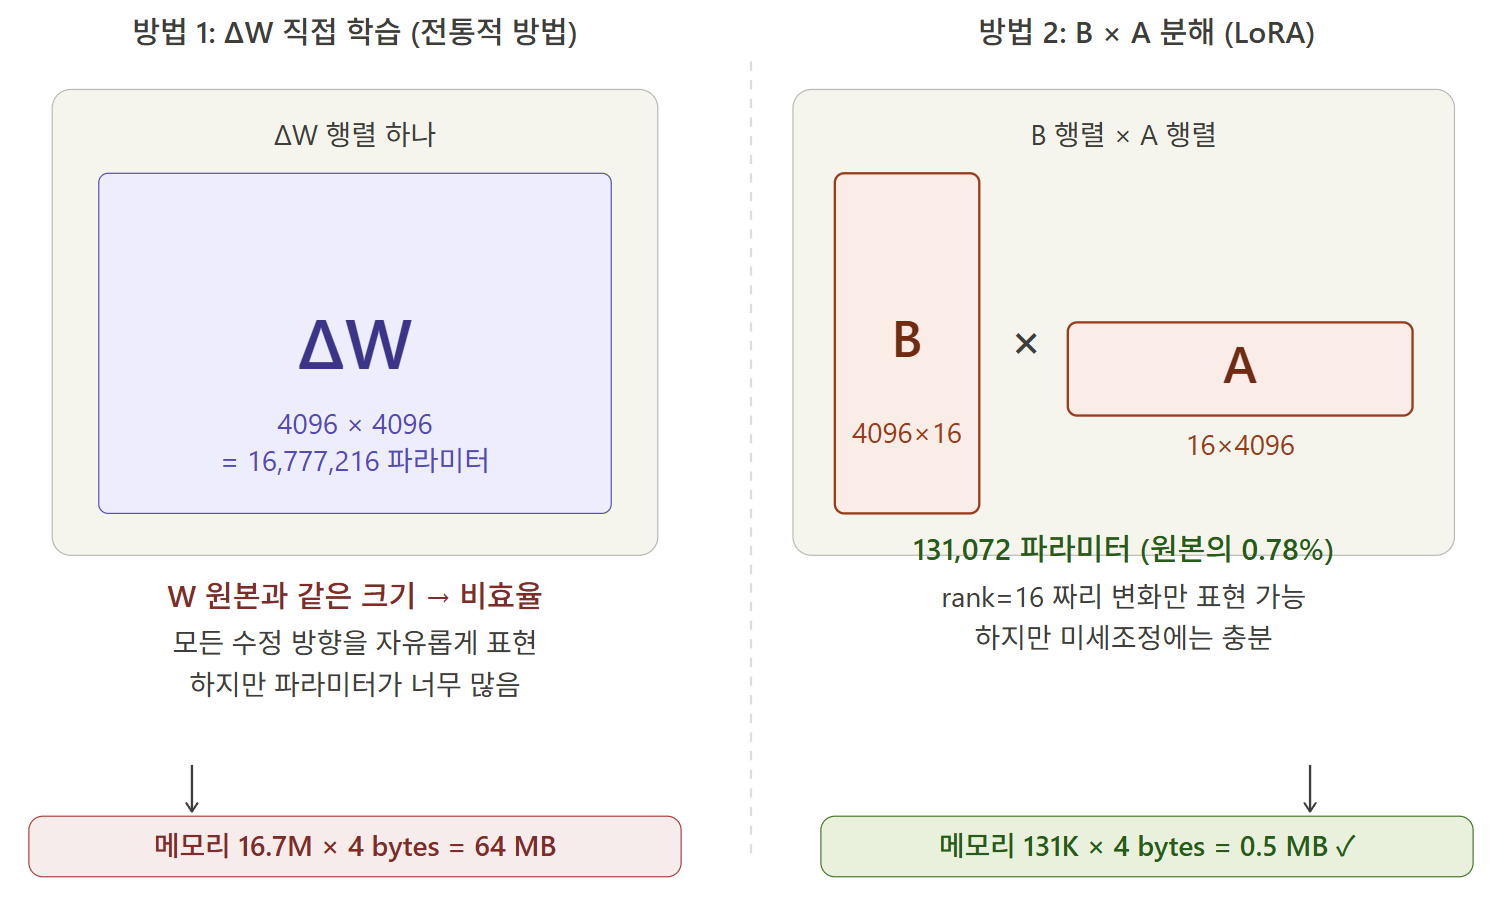
¡Debo corregir mi suposición de que el 13 de mayo fue el último día! El 17 de mayo hubo una ola masiva de pruebas de backend y redacción de informes.
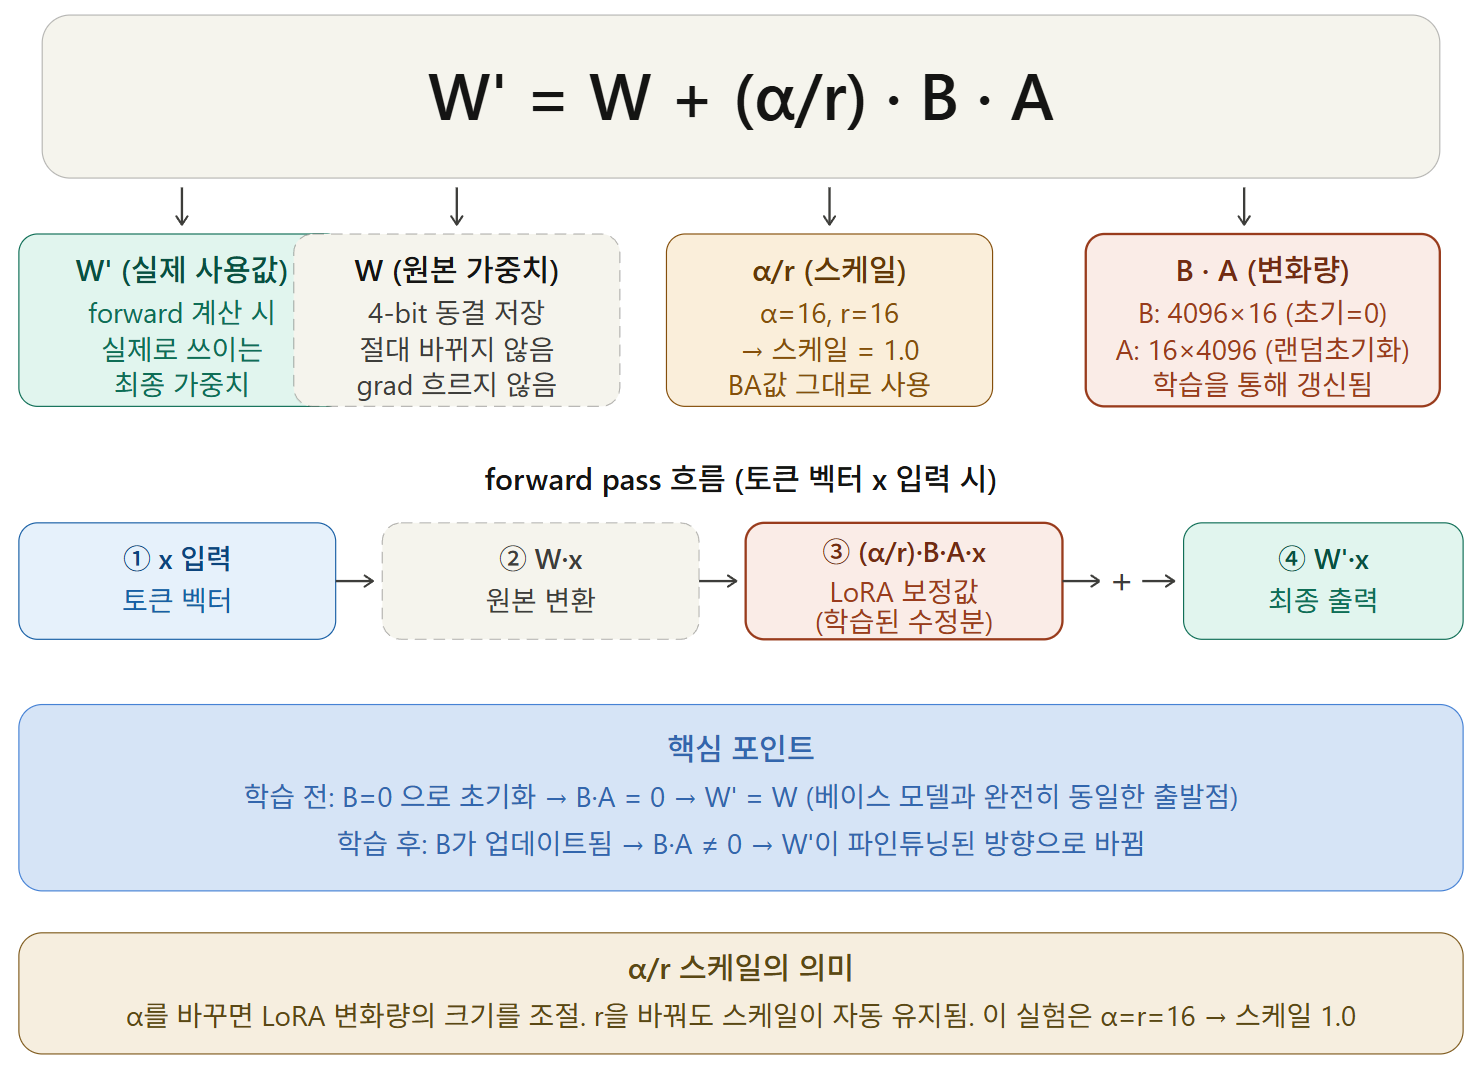
El 3 de mayo, habiendo ganado suficiente experiencia con los modelos 8B, nuestro equipo finalmente desafió a los reyes del rendimiento: el fine-tuning de modelos masivos de 70B (70 mil millones de parámetros). Intentamos entrenar tanto Llama 3.3 70B como DeepSeek-R1 70B, pero chocamos con un muro de recursos de hardware.

El 14 de abril es el día en que reanudamos el trabajo de generación de datos sintéticos (v5), que se había detenido temporalmente desde el incidente de la bomba de facturación. Aumentamos el límite de facturación de la API (levantamos la restricción) y ejecutamos el sistema, pero una vez más, no fue fácil.

El 9 de abril, usando el cuaderno de Colab que completamos ayer de manera ambiciosa, finalmente intentamos el primer entrenamiento (fine-tuning) de nuestro modelo de IA (Llama 3.1). Sin embargo, la realidad no fue tan fácil y tuvimos que enfrentar numerosos errores. También fue un día difícil ya que tuvimos que crear simultáneamente los materiales de presentación para la sexta semana.