[Stanford CS329A #2] Escalado del Cómputo en Tiempo de Inferencia: Más Allá del Preentrenamiento hacia la Inferencia Óptima

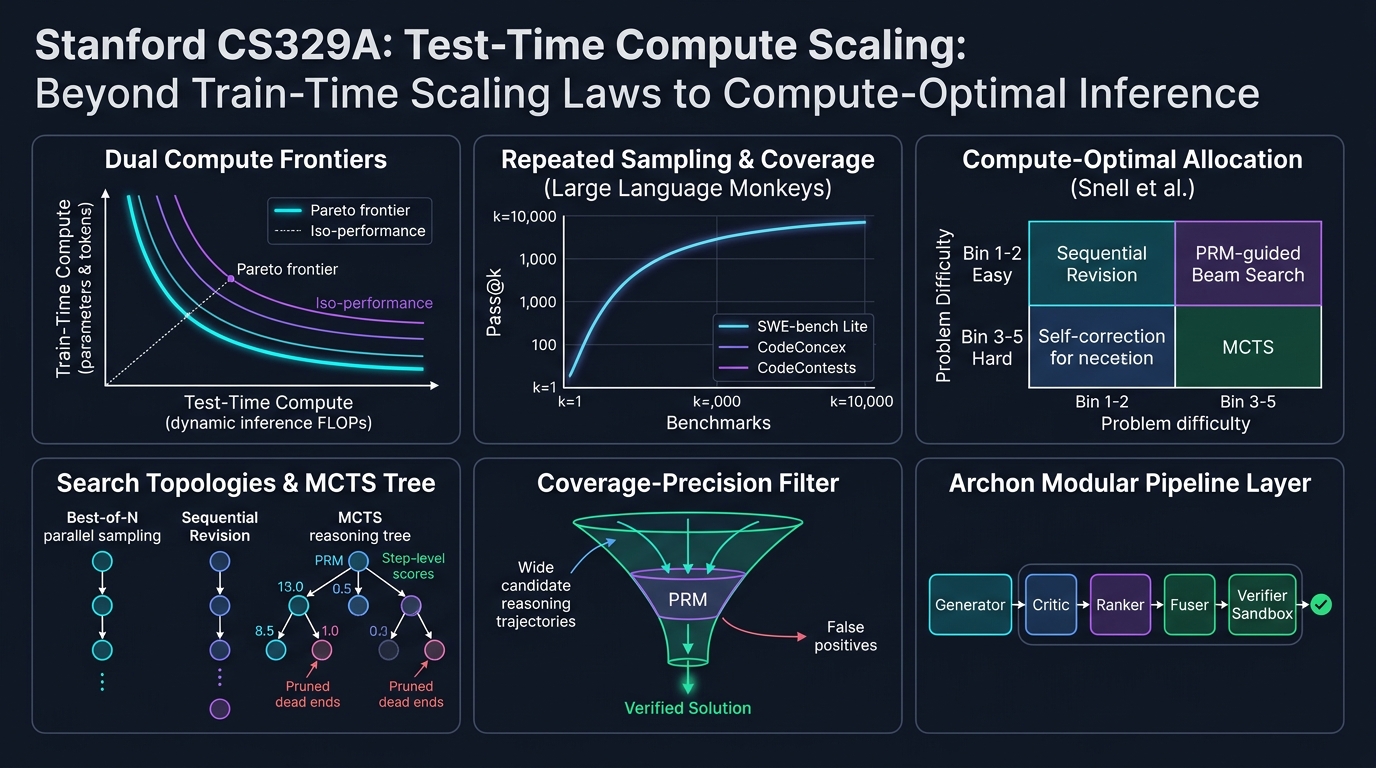
Bienvenidos a la segunda entrega de nuestro análisis definitivo de ingeniería sobre el curso de posgrado de la Universidad de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA con Automejora, Otoño 2025).
En nuestra clase inaugural, analizamos el cambio de paradigma macroeconómico que transforma los modelos estáticos de predicción del siguiente token en bucles agénticos autónomos con retroalimentación del entorno. Hoy nos enfrentamos al pilar computacional que hace viable esta autonomía: el Escalado del Cómputo en Tiempo de Inferencia (Test-Time Compute Scaling).
Durante más de un lustro, la doctrina imperante en la industria de la IA estuvo dictada por las leyes de escalado del preentrenamiento (Kaplan et al., Chinchilla): construir clústeres de GPUs masivos, expandir la huella de parámetros N y absorber decenas de billones de tokens web. Sin embargo, una vez congelados los parámetros θ del modelo, ¿qué ocurre si nos negamos a aceptar una respuesta voraz (greedy) en 50 milisegundos? ¿Qué sucede si el agente dedica 10 segundos, 1 minuto o 10 minutos a explorar deliberadamente árboles de razonamiento, verificar pasos intermedios y revisar sus hipótesis antes de comprometerse con una acción?
A través de los descubrimientos empíricos de Large Language Monkeys (Brown et al., 2024), el Compute-Optimal Scaling de Snell et al. (Stanford/UC Berkeley, 2024) y el marco de arquitectura modular Archon, formalizaremos matemáticamente cómo el intercambio de FLOPs de inferencia por capacidad de parámetros está redefiniendo la inteligencia artificial moderna.
flowchart TD
    subgraph PreTrain ["Frontera Clásica: Escalado en Tiempo de Entrenamiento"]
        direction TB
        P1["Billones de Tokens Web (D)"] --> P2["Clústeres Masivos de GPU (C_train)"]
        P2 --> P3["Modelo Denso Congelado (θ)"]
        P3 --> P4["Pase Hacia Adelante Único Voraz (Cómputo Fijo O(1))"]
    end

    subgraph TestTime ["Frontera CS329A: Escalado en Tiempo de Inferencia"]
        direction TB
        T1["Pesos Base Congelados (θ)"] --> T2["Asignación Dinámica de FLOPs en Inferencia"]
        T2 --> T3{"Selección Adaptativa por Dificultad"}
        T3 -- "Baja Dificultad (Bin 1-2)" --> T4["Revisión Secuencial (Autocorrección)"]
        T3 -- "Alta Dificultad (Bin 3-5)" --> T5["Búsqueda en Árbol Guiada por PRM (MCTS / Beam Search)"]
        T4 --> T6["Verificador de Modelo de Recompensa de Proceso (PRM)"]
        T5 --> T6
        T6 --> T7["Solución Extraída y Verificada Mecánicamente"]
    end

    PreTrain -.->|"Punto de Inflexión: Saturación de Parámetros"| TestTime