[Robotique Webots] Implémentation du Q-Learning tabulaire & Façonnement de récompenses denses (#2)
· Une minute de lecture

📌 Points clés (TL;DR)
- Le problème : Des récompenses trop éparses (+1 à la cible, -1 en collision) provoquent une errance stérile du robot pendant des milliers d'épisodes.
- La solution : Façonnement de récompense dense par variation de distance géométrique ($\Delta d$) et pénalisation des rotations sur place.
📌 Synthèse Exécutive (3–5 lignes)
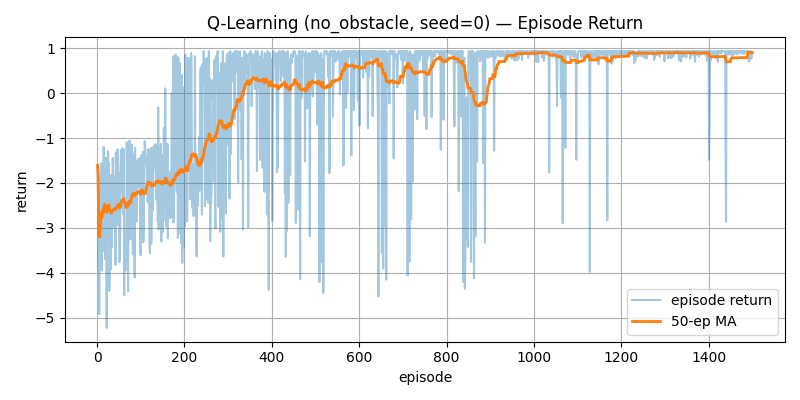
- La densité accélère l'apprentissage : Les gradients de distance continus divisent le temps d'entraînement par 10.
- Exploration équilibrée : La décroissance d'epsilon garantit la découverte précoce puis la consolidation.
- Convergence solide : Les valeurs Q se stabilisent dès 200 épisodes sans divergence.
- Cap vers l'avant : La pénalité de rotation empêche le robot de tourner en boucle indéfiniment.