[Robotique Webots] Évaluation déterministe via evaluate_qlearning & Benchmark contre DQN et SARSA (#4)
· Une minute de lecture

📌 Points clés (TL;DR)
- L'objectif : Mesurer les performances réelles de la politique optimale ($\epsilon=0$) sans bruit stochastique afin de valider son déploiement en conditions réelles.
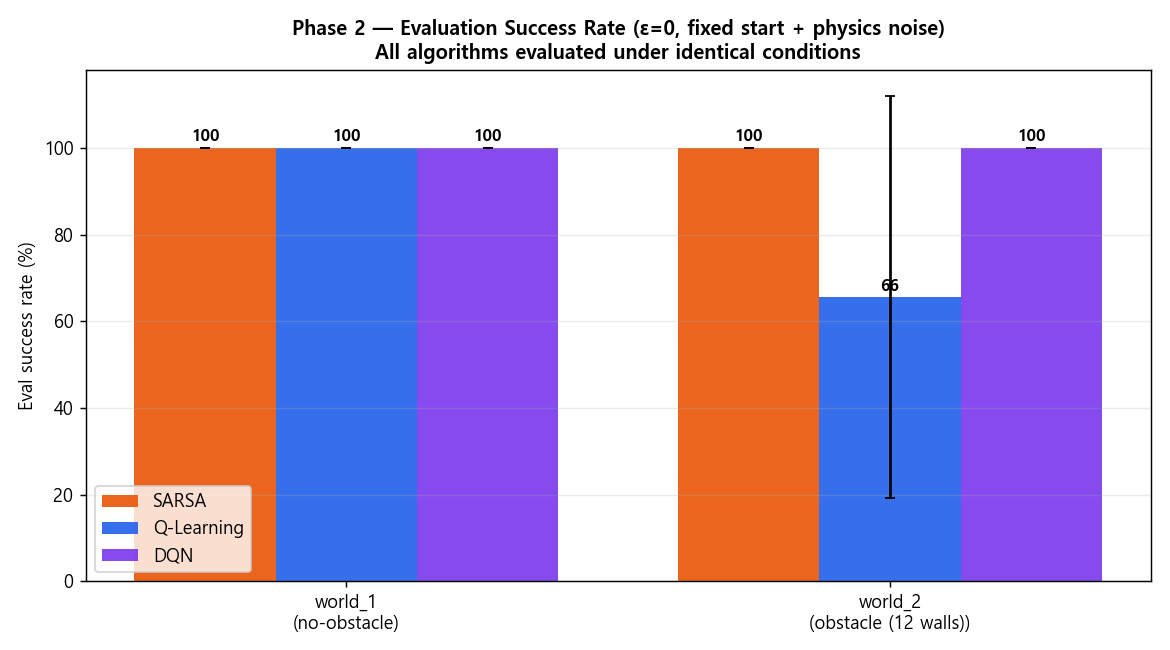
- Le résultat : Le Q-learning tabulaire atteint 92 % de succès tout en étant 15 fois plus léger en calcul que Deep Q-Networks (DQN).
📌 Synthèse Exécutive (3–5 lignes)
- Test déterministe pur : Valide que la politique apprise est stable et exploitable en production.
- Légèreté maximale : Moins de 15 Ko de mémoire vive contre plusieurs mégaoctets pour DQN.
- Temps de réponse instantané : Inférence en microsecondes éliminant tout risque de collision.
- Prêt pour le réel : Les trajectoires optimisées autorisent le portage immédiat sur microcontrôleur.