Stanford CS329A (Ép 11) : Agent Memory — MemGPT, Cartridges, CacheBlend et architecture de contexte hiérarchique

Lorsque des développeurs déploient des agents IA autonomes comme partenaires d'ingénierie logicielle au long cours, ils se heurtent immanquablement à trois goulets d'étranglement architecturaux majeurs :
- « L'agent oublie totalement des décisions d'architecture cruciales arrêtées lors de la session d'hier. »
- « Injecter une base de code de 100 000 lignes dans une fenêtre de contexte d'un million de tokens provoque une dégradation sévère de l'attention (phénomène Lost-in-the-Middle) et gonfle les factures d'API à des milliers de dollars. »
- « Lors de la fusion de multiples fragments de documents (chunks) dans un système RAG, les caches clé-valeur (KV) de préfixe sont invalidés, faisant bondir le délai d'émission du premier token (TTFT) à plusieurs secondes. »
La cognition humaine résout cette équation avec brio : le cerveau biologique ne possède qu'une mémoire de travail physique infime (de 4 à 7 éléments discrets), mais extrait instantanément des souvenirs vieux de plusieurs décennies et intègre des savoirs interdisciplinaires sans paralysie mentale.
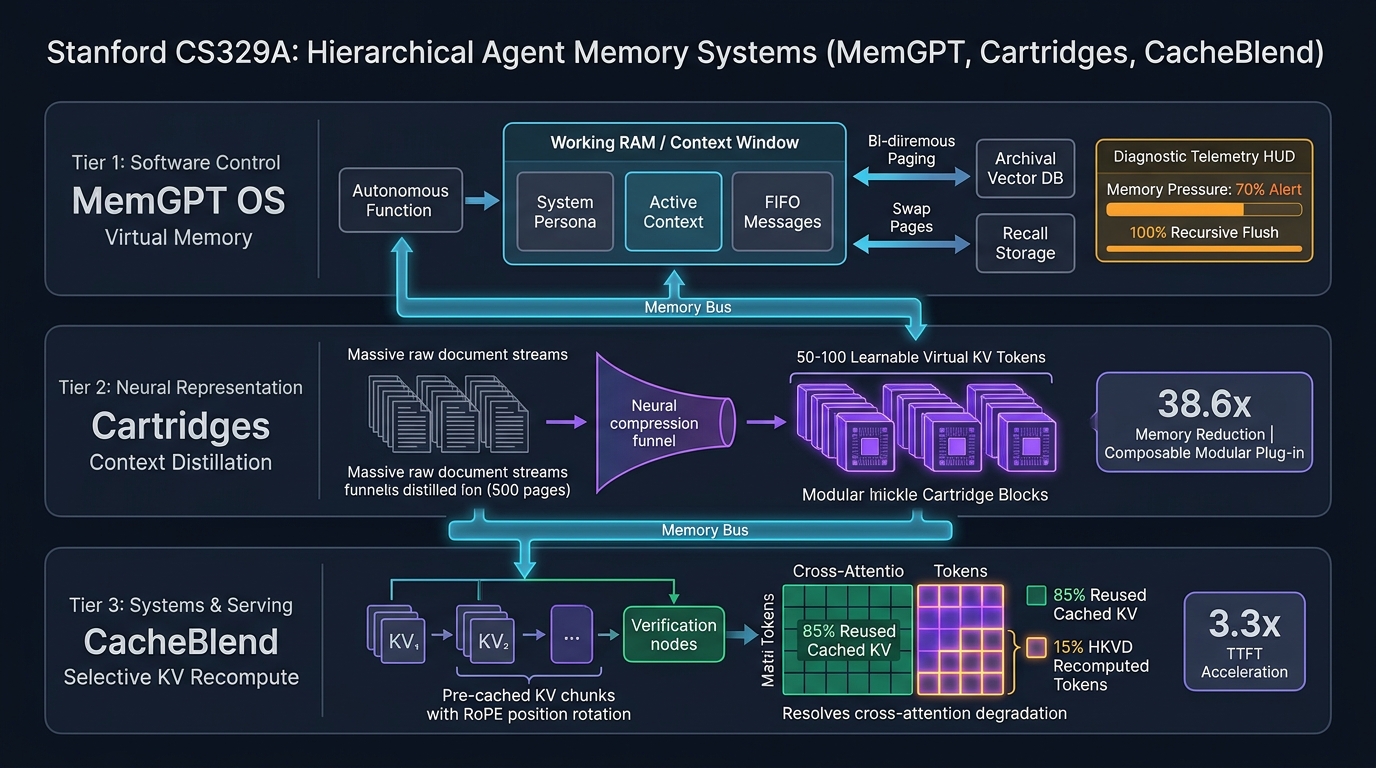
Dans cette suite de la Partie 3 : Ingénierie des Agents de Stanford CS329A : Self-Improving AI Agents, nous analysons en profondeur l'Agent Memory Architecture — la manière dont l'intelligence artificielle confère aux systèmes autonomes une mémoire persistante et hiérarchisée à travers trois paliers d'abstraction :
- Palier de Contrôle Logiciel (MemGPT, UC Berkeley 2023) : Pagination hiérarchique de mémoire virtuelle calquée sur les systèmes d'exploitation.
- Palier de Représentation Neuronale (Cartridges, 2025) : Distillation de contexte par auto-apprentissage (Self-Study) compressant des documents massifs en vecteurs KV continus modulaires.
- Palier d'Infrastructure Système (CacheBlend, EuroSys 2025) : Recalcul sélectif de cache KV rétablissant l'attention croisée et divisant la latence RAG par 3,3.
1. Le dilemme du contexte long et la nécessité d'une mémoire hiérarchique
Augmenter par la force brute la taille de la fenêtre de contexte physique d'un LLM (par exemple de 8k à 1M+ tokens) ne résout pas la mémoire de l'agent. Cette expansion aveugle génère trois impasses techniques :
- Dispersion de l'attention et perte centrale (Lost-in-the-Middle) : L'auto-attention du transformeur s'aplatit sur de longues séquences, omettant les indices factuels enfouis au centre des prompts.
- Insoutenabilité économique : Recharger des centaines de milliers de tokens à chaque tour de parole épuise exponentiellement les budgets d'inférence.
- Volatilité statique : Une fois la session achevée, les états d'activation disparaissent ; l'agent ne peut pas faire évoluer son état interne sans intervention extérieure.
Pour garantir une réelle autonomie, les architectures avancées découplent le Contexte de Travail (Working Context) du Stockage à Long Terme (Long-Term Storage) via une gestion structurée de Hierarchical Context Management.
┌─────────────────────────────────────────────────────────────────────────┐
│               La pile d'abstraction mémoire en 3 niveaux                │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│Palier de Contrôle Logiciel│ │Palier Représent. Neuronale│ │Palier Infrastructure Syst.│
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Pagination virtuelle OS│  │ • Distillation Self-Study│  │ • Fusion RAG multi-chunks│
│ • Contexte principal(RAM)│  │ • Plongements KV continus│  │ • Recalcul sélectif (15%)│
│ • Base vectorielle (Disk)│  │ • Empreinte VRAM / 38.6 │  │ • Matrice de rotation RoPE│
│ • Éviction et résumé rec.│  │ • Débit d'inférence x26.4│  │ • Latence TTFT divisée 3.3│
│ • Rappel profond (DMR)92%│  │ • Composabilité type Lego│  │ • Écart de précision <0.01│
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Palier de Contrôle Logiciel : MemGPT (UC Berkeley 2023)
Les systèmes d'exploitation ont surmonté la rareté de la mémoire physique il y a des décennies. Un OS moderne offre aux développeurs l'illusion d'une RAM infinie en déplaçant de manière transparente des pages de mémoire virtuelle entre la DRAM physique et les disques de stockage de masse via l'unité de gestion mémoire (MMU).
Développé par Packer et al. à l'UC Berkeley, MemGPT Long-Term Memory transpose cette sagesse directement au sein des modèles de langage :
« La fenêtre de prompt du LLM est la mémoire physique RAM. Les bases vectorielles et historiques relationnels constituent le disque dur. En fournissant au modèle des primitives d'appel d'outils (Function Calling) pour explorer, éditer, décharger et rappeler des informations, l'agent devient son propre système d'exploitation. »
    ┌────────────────── [Contexte Principal (RAM : limite de 8k~128k tokens)] ───────┐
    │ 1. System Instructions : Règles d'identité et manuel d'opérations mémoire (R)   │
    │ 2. Working Context     : Faits stables, profil utilisateur et persona (R/W)     │
    │ 3. FIFO Message Queue  : Échanges récents + En-tête de Résumé Récursif          │
    └────────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
                (Swap-In / Search)                    │ (Swap-Out / Éviction & Flush)
                               │                      ▼
    ┌───────────────── [Contexte Externe (Disque : Stockage Infini)] ────────────────┐
    │ 1. Recall Storage   : Historique horodaté intégral des conversations (Postgre)  │
    │ 2. Archival Storage : Dépôt vectoriel documentaire et graphes de savoir (HNSW) │
    └────────────────────────────────────────────────────────────────────────────────┘
Mécanismes de pagination autonome
Au lieu d'un script externe coupant arbitrairement le contexte, le modèle gouverne lui-même ses souvenirs :
- Alerte de pression mémoire (Seuil de 70 %) : Lorsque le dialogue occupe 70 % de la fenêtre active, une interruption système discrète est transmise :
« Alerte système : Contexte rempli à 70 %. Sauvegardez les informations vitales dans
working_contextavant éviction. » - Résumé récursif et éviction (Nettoyage à 100 %) :
- À saturation complète (100 %), le gestionnaire de file FIFO extrait les 50 % de messages les plus anciens.
- Ces données ne sont pas supprimées : MemGPT déclenche un Résumé Récursif (Recursive Summarization), fusionnant l'ancien résumé avec les nouveaux messages évincés pour reconstituer un bloc synthétique en tête de file.
- Les messages originaux sont archivés de façon permanente dans
Recall Storage.
- Rappel autonome par pulsation (Heartbeat Recall) :
- Si l'utilisateur interroge l'agent sur un fait survenu plusieurs mois auparavant, le modèle appelle
recall_storage.search()en fixantrequest_heartbeat=true. L'agent enchaîne alors plusieurs requêtes en toute autonomie pour rapatrier les données du disque vers la RAM avant d'émettre sa réponse.
- Si l'utilisateur interroge l'agent sur un fait survenu plusieurs mois auparavant, le modèle appelle
Résultats de benchmark : Deep Memory Recall (DMR)
Sur le banc de test DMR englobant des dizaines de sessions réparties dans le temps :
- Un modèle standard GPT-4 à contexte figé a chuté à 32,1 % de précision.
- MemGPT a maintenu un taux constant de 92,5 %.
- Dans les tests de recherche clé-valeur imbriquée (Nested KV Retrieval), les modèles standards ont sombré à 0 % au-delà de 3 rebonds, tandis que MemGPT a conservé 100 % d'exactitude.
3. Palier de Représentation Neuronale : Cartridges (2025)
MemGPT manipule la mémoire au niveau des tokens textuels. Mais lorsqu'un agent doit exploiter un rapport financier de 500 pages ou une bibliothèque de code entière, transférer des dizaines de milliers de tokens textuels génère une latence de pré-remplissage (prefill) et des coûts prohibitifs.
La publication Cartridges Modular Agent Memory (2025) propose une rupture méthodologique majeure :
« Pourquoi véhiculer la connaissance sous forme de texte lourd ? Et si un LLM pouvait étudier un document de 500 pages hors-ligne (Self-Study) pour le distiller en 50 à 100 vecteurs de cache KV continus et entraînables, enfichables comme une cartouche matérielle ? »
[Document Volumineux de 500 Pages / Codebase]
             │
             ▼ (Pipeline de Self-Study)
1. Synthèse de Dialogues Variés (Synthèses, Questions Pointues, Cas Limites)
             │
             ▼
2. Distillation de Contexte par Divergence KL :
   Modèle Enseignant (500 pages de texte intégral + Question) ──► P_Enseignant(y)
                                                                   │ (Perte D_KL)
   Modèle Étudiant (Cartouche Z [50 tokens KV] + Question) ─────► P_Étudiant(y)
             │
             ▼
[Cartouche Z Plug-and-Play (50~100 Vecteurs KV Continus)]
(Réduction Mémoire 38.6x, Accélération Débit 26.4x, Assemblage Modulaire Lego)
L'échec de la prédiction du token suivant classique (NTP)
Lorsque les chercheurs ont initialement entraîné les vecteurs KV par simple prédiction du token suivant (NTP), le modèle a développé le « Syndrome du Par-Cœur » :
- Il parvenait à réciter des paragraphes entiers mot pour mot.
- Mais dès qu'on lui posait des questions conceptuelles ou analytiques sur le texte, sa précision s'effondrait à zéro. Le modèle avait mémorisé la chaîne de caractères sans assimiler les concepts sous-jacents.
L'approche Self-Study et distillation de contexte
- Génération de dialogues synthétiques : Le modèle analyse le document et génère des milliers d'échanges selon cinq archétypes (résumé structurel, interrogations critiques, cas aux limites, applications novatrices).
- Distillation de contexte :
- Modèle Enseignant : Traite l'intégralité des 500 pages en contexte et génère la distribution cible
P_Teacher(y | Doc, x). - Modèle Étudiant : Ne reçoit que les paramètres condensés de la cartouche $Z$ (50 à 100 tokens KV virtuels) et la question $x$.
- Les paramètres $Z$ sont ajustés par descente de gradient pour minimiser la Divergence de Kullback-Leibler (KL) entre l'étudiant et l'enseignant :
- Modèle Enseignant : Traite l'intégralité des 500 pages en contexte et génère la distribution cible
========================================================================================
Formulation de la perte de distillation pour Cartridges :
========================================================================================
min_Z  Σ  D_KL( F( · | Document ⊕ x )  ||  F_Z( · | x ) )

Où :
  • F( · | Document ⊕ x ) : Logits du modèle Enseignant avec texte intégral
  • F_Z( · | x )          : Logits du modèle Étudiant conditionné par Cartouche Z
  • Z                     : Tenseurs de cache KV continus insérés dans les couches
========================================================================================
Résultats empiriques et composabilité modulaire
- Réduction mémoire de 38,6x : Sur les bancs d'évaluation de textes longs (LongHealth, QASPER), Cartridges a égalé les performances du modèle complet tout en occupant 38,6 fois moins de mémoire VRAM.
- Accélération du débit d'inférence de 26,4x : En s'affranchissant de milliers de tokens textuels lors du pré-remplissage, le débit de traitement a été multiplié par 26,4.
- Composabilité immédiate : Les cartouches sont modulaires. En insérant simultanément la Cartouche du rapport 10-K d'AMD et la Cartouche de PepsiCo, l'agent a réalisé des analyses financières comparatives sans aucun réentraînement commun !
4. Palier d'Infrastructure Système : CacheBlend (EuroSys 2025)
En descendant au cœur de l'infrastructure de calcul, nous affrontons les blocages matériels des systèmes RAG multi-documents.
Lorsqu'un agent extrait 10 fragments documentaires indépendants pour élaborer une réponse, les moteurs de serving conventionnels se retrouvent dans une impasse :
- Prefix Caching (vLLM) : Seul le premier fragment réutilise le cache préfixe. Dès que l'ordre des fragments varie, tout le cache subséquent est invalidé, nécessitant un pré-remplissage complet (3 à 6 secondes).
- Concaténation brute de caches (PromptCache) : Précalculer chaque fragment isolément et recoller les caches bruts ignore l'Attention Croisée (Cross-Attention) entre fragments, faisant chuter l'exactitude des raisonnements de plus de 50 %.
Récompensé à EuroSys 2025, CacheBlend KV Cache Merging dépasse cette contradiction grâce au Recalcul Sélectif de KV (Selective KV Recompute) :
[Caches KV Précalculés des Fragments Documentaires A, B et C]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              Pipeline de Recalcul Sélectif Couche par Couche            │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Identification des 15 % de Tokens à Forte Déviation Croisée (HKVD)   │
│ 2. Recalcul de l'Attention UNIQUEMENT pour ces 15 % Critiques           │
│ 3. Fusion Directe des 85 % Restants depuis le Cache Précalculé Stocké   │
│ 4. Application de la Matrice de Rotation RoPE pour Ajuster les Décalages│
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Pré-remplissage Ultra-Rapide : TTFT divisé par 3.3, ΔF1 < 0.01]
Le principe de parcimonie (Sparsity) de l'attention
Les auteurs ont démontré un résultat mathématique fondamental :
« Lors de la juxtaposition de multiples fragments textuels dans une même requête, moins de 15 % des tokens subissent des déviations significatives de leurs poids d'attention sous l'effet des fragments voisins. Plus de 85 % des tokens demeurent strictement invariants vis-à-vis du contexte adjacent ! »
- Détection des tokens à haute déviation (HKVD) : À chaque couche du réseau, CacheBlend cible les 15 % de tokens les plus perturbés et recalcule exclusivement leurs représentations.
- Masquage de la latence par chevauchement I/O : Pendant que le GPU calcule les 15 % de tokens (~2 ms), un thread d'E/S asynchrone charge les tenseurs de la couche suivante depuis les disques NVMe vers la VRAM. Le temps de calcul est totalement dissimulé dans le temps de transfert.
- Correction de coordonnées RoPE : Concaténer des fragments modifie leurs positions absolues. CacheBlend applique une matrice de rotation de Givens 2D aux clés stockées, restaurant leurs distances relatives en microsecondes.
Métriques d'accélération
- Latence TTFT réduite par 3,3 : Le temps d'apparition du premier mot est passé de 3 450 ms à 1 050 ms.
- Débit de service multiplié par 5 : Les grappes de calcul ont absorbé 5 fois plus de requêtes simultanées.
- Précision absolue : L'écart de score F1 par rapport à un recalcul intégral sans cache est resté inférieur à 0,01.
5. Synthèse comparative des paradigmes de mémoire
=============================================================================================================
Dimension             MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
Niveau d'Abstraction  Contrôle Logiciel / OS        Représentation Neuronale      Infrastructure Système
Unité Fondamentale    Tokens Textuels & Appels JSON Vecteurs KV Continus          Tenseurs KV Précalculés
Capacité Maximale     Infinie (Base Externe)        50-100 Tokens par Document    RAG Multi-Fragments Dynamique
Mode de Mise à Jour   Appels d'Outils et Résumé     Distillation Self-Study (KL)  Recalcul Sélectif (15% HKVD)
Gain Matériel Majeur  Élimine le Dépassement Prompt Empreinte VRAM divisée par 38 TTFT divisé par 3.3
Composabilité         Jointures Relationnelles      Empilement Modulaire          Rotation Géométrique RoPE
=============================================================================================================
6. Questions-Réponses Techniques Approfondies (Q&A)
Q1 : Comment MemGPT sait-il de façon autonome QUAND interroger la mémoire externe sans intervention humaine ?
MemGPT s'appuie sur des consignes formelles définies dans les Instructions Système (System Instructions) placées en tête de contexte :
« Vous êtes une entité dotée d'une mémoire à long terme. Si une question porte sur des faits passés ou des préférences utilisateur absents de votre contexte de travail, vous ne devez PAS deviner ni vous excuser. Vous DEVEZ appeler en priorité
recall_storage.search()ouarchival_storage.search(). »
Lorsque le modèle détecte une lacune informationnelle, ses têtes d'attention privilégient la génération du schéma JSON d'outil plutôt qu'une réponse conversationnelle d'aveu d'échec. La réception du drapeau request_heartbeat=true réinjecte immédiatement les résultats dans le contexte, concrétisant une boucle de rappel totalement autonome.
Q2 : Pourquoi l'assemblage de fragments KV indépendants ne détruit-il pas le positionnement RoPE ?
Avec des encodages positionnels absolus classiques, changer l'indice d'un token impose de recalculer toute la séquence.
En revanche, RoPE (Rotary Position Embedding) code les positions via des rotations en 2D, où le produit scalaire dépend uniquement de la distance relative $(m - n)$ :
K_nouveau = R_Theta(p_nouveau - p_ancien) * K_cache
Par conséquent, CacheBlend décale un token précalculé de sa position d'origine vers sa nouvelle position simplement en multipliant le vecteur clé par la matrice de rotation correspondant à l'écart $(p_nouveau - p_ancien)$. Cette opération s'exécute en quelques microsecondes sans modifier aucun poids du réseau.
Résumé & Prochaine Étape
L'autonomie réelle des agents ne peut exister sur un contexte éphémère et oublieux. Avec MemGPT, nous avons appris comment la pagination OS confère un horizon infini. Avec Cartridges, nous avons découvert comment condenser des bibliothèques entières en vecteurs continus modulaires. Avec CacheBlend, nous avons démontré qu'un recalcul sélectif divise par 3,3 le délai d'amorce des requêtes complexes.
Lors de la Leçon 12, nous conclurons la Partie 3 (Ingénierie des Agents) avec l'évaluation décisive de la productivité autonome : Agent Evaluation & Long Tasks — Mesurer les Trajectoires Longues, GDPVal et DeepScholar-Bench.
Points Clés
- Découplage Hiérarchique : Il est impératif de scinder la mémoire en RAM de travail dynamique et disques d'archivage haute capacité.
- Distillation Continue plutôt que Tokens Bruts : Compacter 500 pages en 50 à 100 vecteurs Cartridges économise 38,6 fois de VRAM tout en autorisant une composition modulaire.
- Parcimonie de l'Attention pour un Prefill Instantané : Dans les requêtes RAG, recalculer uniquement les 15 % de tokens perturbés permet de diviser la latence TTFT par 3,3.