Stanford CS329A (Ép 12) : Agent Evaluation & Long Tasks — Horizons METR, OpenAI GDPval et DeepScholar-Bench

Lorsqu'une équipe d'ingénierie développe un agent de codage autonome et le présente à des dirigeants d'entreprise ou des investisseurs, annoncer « 92 % de score au test MMLU » ne suscite qu'une totale indifférence. Les questions industrielles sont infiniment plus pragmatiques :
- « Cet agent autonome peut-il mener à bien une mission complexe de plusieurs heures sans intervention humaine ? »
- « Si un ingénieur senior met 8 heures à concevoir un modèle financier ou refactoriser un microservice, l'agent peut-il délivrer une qualité comparable ? Et quelle est sa valeur économique nette en dollars réels ($) ? »
Les bancs d'essai traditionnels à choix multiples (MMLU, GSM8K, HumanEval) sont largement saturés au-delà de 90 % et corrompus par la contamination des données du Web. Surtout, réussir un quiz de 5 secondes n'a aucun rapport avec l'exécution de Long-Horizon Agent Tasks exigeant des centaines d'actions interdépendantes avec maintien d'état sur plusieurs heures.
Pour clore en apothéose la Partie 3 : Ingénierie des Agents (Leçons 10 à 12) de Stanford CS329A : Self-Improving AI Agents, nous analysons la science moderne des Agent Evaluation Benchmarks — mesurant l'intelligence agentique non par de vagues pourcentages, mais en unités physiques de Temps Humain et de Valeur Économique ($) :
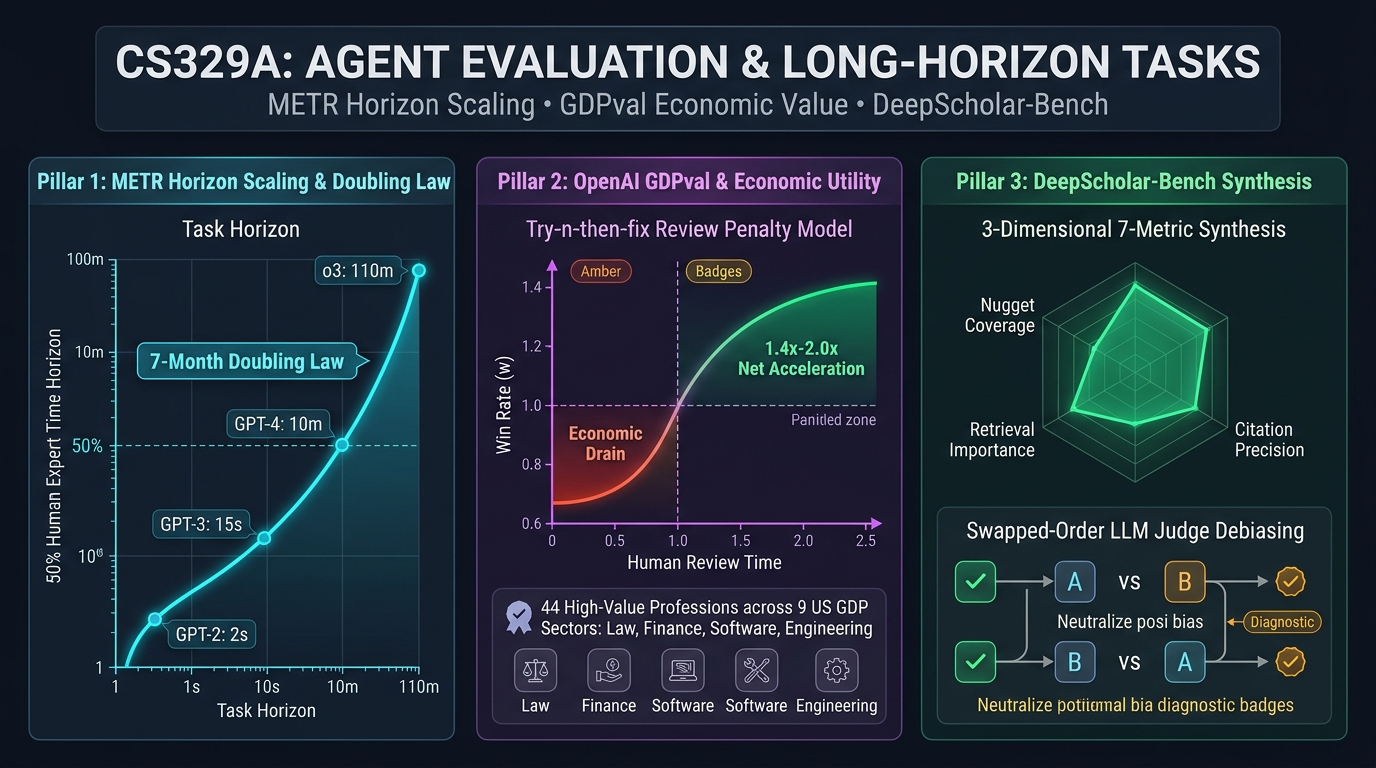
- Horizon Temporel Humain (METR, 2025) : L'horizon de temps à 50 % de succès (h_agent) et la loi empirique de doublement tous les 7 mois.
- Valeur Économique Réelle (OpenAI GDPval, 2025) : Évaluation de 44 métiers à haute valeur ajoutée et équation rigoureuse du coût de révision humaine « Try-n-then-fix ».
- Évaluation Académique sans Contamination (DeepScholar-Bench, 2025) : 3 dimensions, 7 métriques en continu et neutralisation du biais de position chez les juges LLM.
1. La crise de l'évaluation : L'impasse des tests à choix multiples
Pendant cinq ans, la recherche s'est appuyée sur des jeux de données statiques de questions-réponses. Toutefois, le déploiement d'agents autonomes en conditions réelles a mis en lumière trois failles structurelles :
- Saturation et contamination : Les modèles de pointe ont dépassé 90 % au MMLU en apprenant par cœur les énoncés aspirés lors du pré-entraînement.
- Absence d'horizon temporel : Une question à choix multiples prend 2 secondes et 1 étape. L'ingénierie logicielle réelle impose de maintenir un état cohérent sur plus de 100 appels d'outils séquentiels.
- L'illusion de la propreté : Les examens scolaires offrent des énoncés parfaits. Le monde professionnel est par nature chaotique (Task Messiness) : exigences ambiguës, latences réseau imprévisibles, journaux d'erreurs abscons et commandes destructives irréversibles.
Les laboratoires d'élite ont ainsi abandonné les QCM au profit d'évaluations physiques et économiques continues.
┌─────────────────────────────────────────────────────────────────────────┐
│              Les 3 piliers de l'évaluation moderne des agents           │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│     Horizons METR        │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Unité : Temps humain t │  │ • Unité : Dollars réels  │  │ • Unité : Vecteur 7 dim. │
│ • Horizon à 50 % h_agent │  │ • 44 métiers qualifiés   │  │ • Flux continu arXiv     │
│ • Doublement en 7 mois   │  │ • Formule Try-n-then-fix │  │ • Zéro contamination     │
│ • Pénalité Messiness     │  │ • Juges experts (14 ans) │  │ • Couverture pépites 39% │
│ • 2s (GPT-2) -> 110m (o3)│  │ • Seuil rentabilité 40 % │  │ • Débiaisage ordre permut│
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Mesurer l'intelligence en temps humain : METR (2025)
Déclarer qu'un modèle obtient 88 % ne renseigne en rien sur son endurance autonome. L'organisme de recherche indépendant METR (Model Evaluation and Threat Research) a instauré un étalon révolutionnaire :
« Oubliez les pourcentages. Mesurez plutôt la probabilité qu'un agent IA mène à bien une tâche requérant un temps $t$ pour un expert humain. Définissez l'intelligence par l'Horizon Temporel à 50 % (h_agent) : la durée de tâche humaine qu'il résout avec un taux de succès de 50 %. »
    [170 tâches complexes d'ingénierie logicielle / ML (secondes à 8 heures)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [Temps humain étalon t]        [Taux de succès empirique p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [Régression logistique Item Response Theory (IRT)]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [Horizon 50 % h_agent : GPT-2 (2s) ──► OpenAI o3 (110 minutes)]
Équation logistique de l'horizon temporel
Fondée sur la théorie de réponse aux items (IRT), l'équation de METR relie la probabilité de réussite $p$ au temps humain t_task et à l'endurance h_agent :
========================================================================================
Formule probabiliste de l'horizon temporel METR :
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

Où :
  • t_task  : Temps moyen requis par un expert humain qualifié
  • h_agent : Horizon temporel à 50 % de l'agent (quand t_task = h_agent, p = 0.5)
  • β_agent : Pente de décroissance de la réussite face à la difficulté
  • σ(z)    : Fonction sigmoïde logistique standard 1 / (1 + exp(-z))
========================================================================================
La loi de doublement en 7 mois
L'examen de 16 modèles majeurs sortis entre 2019 et 2025 a révélé une tendance exponentielle remarquable :
- 2019 (GPT-2) : Horizon de 2 secondes (autocomplétion basique).
- 2021 (GPT-3) : Horizon de 15 secondes.
- 2023 (GPT-4) : Horizon de 10 minutes.
- 2025 (OpenAI o3) : Horizon de 110 minutes (~2 heures).
- Régression statistique : L'horizon temporel à 50 % double exactement tous les 7 mois (207 jours).
- Projection macroscopique : Si ce rythme perdure, les agents franchiront entre 2028 et 2030 le seuil d'autonomie à 50 % sur des projets demandant un mois entier (160 heures) de travail continu d'un ingénieur senior.
3. Mesurer la valeur économique réelle : OpenAI GDPval (2025)
Tandis que METR chronométrait le temps, le benchmark GDPval d'OpenAI a mesuré le capital financier concret.
OpenAI a sélectionné 44 professions intellectuelles hautement rémunérées réparties sur les 9 secteurs composant le PIB américain (finance, droit, logiciel, ingénierie, santé, etc.). Ils ont recruté des professionnels comptant en moyenne 14 ans d'expérience métier pour élaborer 220 tâches concrètes (modélisation de flux de trésorerie DCF, mémoires de brevets, pipelines d'analyse de données) :
- Temps humain moyen par tâche : 9,5 heures (médiane : 5,0 heures).
- Coût de sous-traitance moyen par tâche : 398 $ USD (~550 000 KRW).
La réalité des taux de victoire en double aveugle
Des experts chevronnés ont évalué à l'aveugle les livrables des modèles face à ceux de confrères humains :
- GPT-4o : Taux de victoire de 12,5 % (largement rejeté par les experts).
- OpenAI o3 : Taux de victoire de 35,2 %.
- Claude Opus 4.1 : Taux de victoire de 47,6 % (Gagné ou Égalité) !
- Les modèles de raisonnement contemporains produisent des travaux que des spécialistes seniors jugent équivalents ou supérieurs à ceux d'humains dans près d'un cas sur deux.
L'illusion de la vitesse et la formule Try-n-then-fix
Le discours commercial affirme souvent : « L'agent a achevé en 2 minutes ce qui prend 9 heures, soit un gain de 270x ! » GDPval réfute ce raisonnement simpliste par la modélisation mathématique du coût de vérification et de reprise humaine :
========================================================================================
Équation économique du coût temporel réel (Modèle Try-n-then-fix) :
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

Où :
  • M_T : Temps de génération machine (quelques minutes)
  • R_T : Temps passé par l'humain à auditer le travail généré
  • H_T : Temps nécessaire à l'humain pour tout recommencer de zéro après rejet
  • w   : Taux de victoire du modèle (probabilité d'acceptation du livrable)
  • n   : Nombre maximal de tentatives avant que l'humain n'abandonne
========================================================================================
Le seuil de rentabilité économique
- Quand la qualité $w$ est médiocre (ex. GPT-4o, $w=12,5%$), l'auditeur humain passe des heures à déceler des erreurs subtiles pour finalement tout refaire lui-même. Déployer GPT-4o s'est donc traduit par un ralentissement net de 13 % (0,87x la vitesse humaine) !
- Seul le franchissement du seuil critique de $w \ge 40%$ (atteint par o3 et Opus 4.1) permet d'amortir le temps d'audit, dégageant une accélération réelle de productivité de 1,3x à 1,4x.
4. Évaluation académique sans contamination : DeepScholar-Bench (2025)
Comment évaluer des agents de recherche avancée sur des synthèses ouvertes où il n'existe aucune réponse préétablie ?
Lancé en août 2025, DeepScholar-Bench a conçu un pipeline dynamique ingérant chaque semaine les articles déposés sur arXiv, interdisant toute contamination par mémorisation préalable.
       [Ingestion hebdomadaire en direct sur arXiv (Zéro contamination)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               Pile de 7 métriques sur 3 dimensions (DeepScholar)        │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Synthèse des connaissances (Knowledge Synthesis)                     │
│    • Organisation & Cohérence (Structure logique, clarté, mise en page) │
│    • Couverture des pépites (Rappel des faits atomiques indispensables) │
│ 2. Qualité de recherche (Retrieval Quality)                             │
│    • Taux de pertinence (Adéquation des sources citées au sujet)        │
│    • Importance documentaire (Capacité à identifier les articles clés)  │
│ 3. Vérifiabilité (Verifiability)                                        │
│    • Précision des citations (Validation du texte face à la source)     │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Juge LLM à ordre inversé : Élimination algébrique du biais de position]
La réalité mesurée à 30,9 %
Même les systèmes de recherche les plus sophistiqués comme OpenAI DeepResearch n'ont obtenu qu'une moyenne géométrique de 30,9 % sur les 7 métriques :
- Forme séduisante vs Fond lacunaire : Les agents brillent sur la syntaxe et la structure (Organization : 85,7 %), mais échouent à capter les faits atomiques essentiels (Nugget Coverage : 39,2 %) et la littérature fondatrice (Document Importance : 12,4 %).
- L'expérience avec référence idéale : En fournissant à l'agent la liste exacte des articles à citer (Oracle Retriever), son score global n'a atteint que 49 %. Cela prouve que le goulet d'étranglement de la recherche autonome n'est pas le moteur de recherche, mais l'aptitude à synthétiser des connaissances complexes issues de multiples lectures.
5. Synthèse comparative des référentiels d'évaluation
=============================================================================================================
Critère               METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
Métrique Principale   Temps Humain (Heures)         Valeur Économique Nette ($)   Vecteur Qualité 7 Métriques
Champ d'Application   Génie Logiciel et IA          44 Métiers Qualifiés du PIB   Synthèse Scientifique Ouverte
Critère de Vérité     Suites de Tests Unitaires     Victoire en Double Aveugle    Pépites d'Informations Fact.
Défense Contamination Problèmes Isolés Air-Gapped   Missions Entreprise Réelles   Flux Hebdomadaire arXiv
Prise en Compte Audit Non Modélisé (Passe/Échoue)   Formule Try-n-then-fix        Juge LLM à Ordre Inversé
Record Actuel         o3 : 110 Minutes (50 % Succès)Opus 4.1 : 47,6 % de Victoire DeepResearch : 30,9 % G-Mean
=============================================================================================================
6. Questions-Réponses Techniques (Q&A)
Q1 : Qu'est-ce que la « Task Messiness » (Complexité / Bruit) dans METR et quel est son impact ?
Dans METR, la Task Messiness mesure 16 facteurs de friction réels absents des exercices scolaires :
- Environnement Dynamique : Le système mute en cours d'exécution (délais réseau, verrous de bases de données).
- Actions Irréversibles : Opérations destructives (un
DROP TABLEerroné ou un commit Git corrompu) interdisant le retour arrière trivial. - Investigation Active : Les données ne sont pas servies prêtes à l'emploi ; l'agent doit fouiller les fichiers de log et déduire le contexte.
Les résultats statistiques démontrent que chaque point supplémentaire de Messiness fait chuter le taux de succès de l'agent de 8,1 %. L'aptitude industrielle dépend de la tolérance à ce désordre ambiant.
Q2 : Comment la moyenne à ordre inversé (Swapped-Order) annule-t-elle le biais de position des juges LLM ?
Lorsqu'un juge LLM évalue deux propositions $(A)$ et $(B)$, il manifeste un Biais de Position prononcé, accordant une préférence de 60 % à 70 % à l'option $(A)$ par le simple fait qu'elle apparaît en premier.
Pour neutraliser ce biais, DeepScholar-Bench met en œuvre la Moyenne à Ordre Inversé (Swapped-Order Averaging) :
- Évaluation 1 : Présentation sous la forme
[A, B], enregistrement du vecteur $S_1 = [s(A), s(B)]$. - Évaluation 2 : Présentation permutée
[B, A], enregistrement du vecteur $S_2 = [s(B), s(A)]$. - Calcul de la moyenne arithmétique :
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
À température identique, le biais induit par la position dans l'invite s'annule algébriquement.
Conclusion & Clôture de la Partie 3
La Partie 3 (Ingénierie des Agents) s'achève sur une vision industrielle rigoureuse :
- Dans la Leçon 10, nous avons éprouvé les SWE-Agents et l'optimisation GPU guidée par profiler (KernelBench).
- Dans la Leçon 11, nous avons pérennisé la mémoire longue durée avec MemGPT, Cartridges et CacheBlend.
- Dans la Leçon 12, nous avons ancré les capacités des agents dans les réalités du Temps Humain (METR) et de la Rentabilité Économique (GDPval).
Nous disposons désormais de tous les leviers pour concevoir, entraîner, équiper et mesurer des agents autonomes.
Cap sur la Partie 4 : Les Frontières
Dans l'ultime section de ce cours, Part 4 · Frontiers (Leçons 13 à 17), nous abordons le sommet théorique de l'intelligence artificielle : La Nature du Raisonnement Machine.
Nous débuterons lors de la Leçon 13 avec : 《LLM Reasoning : Les Fondements du Raisonnement, Chain-of-Thought et Émergence Cognitive》, à partir des recherches pionnières de Denny Zhou chez Google DeepMind.
Points Clés
- Mesurer le Temps : La vraie métrique d'intelligence est l'horizon temporel à 50 % (h_agent), qui double tous les 7 mois (de 2s pour GPT-2 à 110m pour o3).
- Le Coût de Révision Gouverne le ROI : Si le taux de victoire d'un agent reste inférieur à 40 %, le temps passé à vérifier et corriger ses erreurs engendre des pertes nettes.
- La Synthèse est la Vraie Frontière : En recherche ouverte, extraire des documents est résolu ; synthétiser des connaissances hétérogènes en faits vérifiables reste le véritable défi.