Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — Vérification formelle, Lean 4, AlphaGeometry et Gemini Deep Think

Lors de notre cours précédent consacré au raisonnement des LLM, nous avons exploré comment le prompting par Chaîne de Pensée (Chain-of-Thought, CoT) et le décodage par Auto-Cohérence (Self-Consistency) ont initié le raisonnement causal multi-étapes au sein des réseaux neuronaux. Cependant, dans les domaines hautement critiques — tels que la vérification de protocoles cryptographiques, les logiciels de trajectoire orbitale ou les démonstrations de théorèmes mathématiques de pointe — le texte en langage naturel présente une faille intrinsèque :
"Quelle que soit l'éloquence et la clarté d'une chaîne de pensée en langage naturel générée par un LLM, elle demeure une séquence stochastique de tokens probabilistes. Une unique erreur subtile de signe, un raisonnement circulaire ou un lemme hallucinatoire anéantit l'ensemble de l'édifice. En mathématiques pures, une preuve correcte à 99% équivaut à une preuve correcte à 0%."
Bienvenue dans le Cours 14 de Stanford CS329A: Self-Improving AI Agents, second volet de la Partie 4 : Frontières (Frontiers in Reasoning & Autonomy). En nous appuyant sur les percées majeures dirigées par le Dr Thang Luong (Directeur de recherche senior chez Google DeepMind), nous étudions comment l'intelligence artificielle est passée de la prédiction statistique de mots à une déduction mathématique infaillible et vérifiée par machine, culminant par l'obtention de médailles historiques aux Olympiades Internationales de Mathématiques (OIM / IMO) :
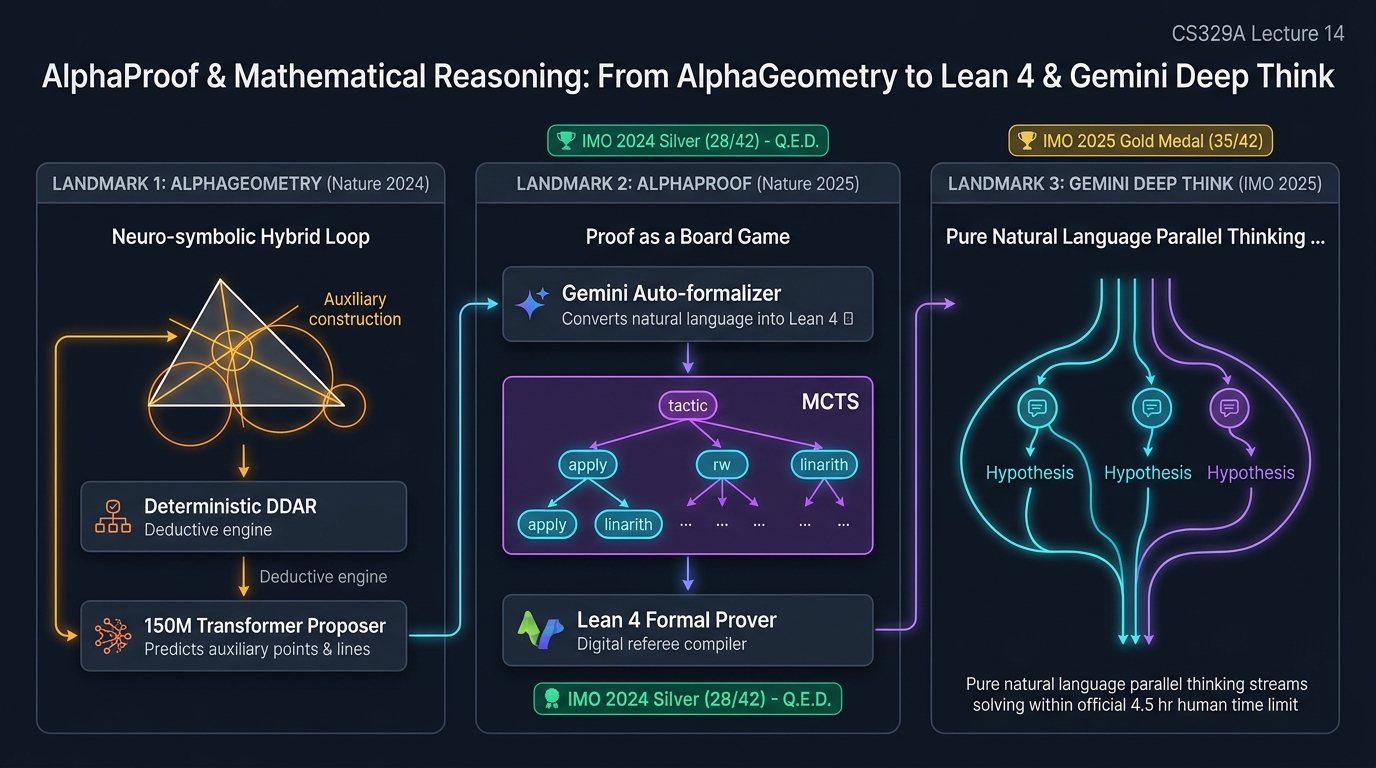
- AlphaGeometry (Nature 2024) : La synthèse neuro-symbolique unissant moteurs déductifs déterministes et Transformers génératifs pour les constructions géométriques auxiliaires.
- AlphaProof (DeepMind, Nature 2025) : La transformation de la démonstration formelle de théorèmes en un jeu de plateau style AlphaZero grâce à Lean 4, à l'auto-formalisation et à l'apprentissage par renforcement au moment du test (TTRL).
- Gemini Deep Think (IMO 2025) : Le triomphe du raisonnement pur en langage naturel et de la pensée parallèle (Parallel Thinking), décrochant la première médaille d'or officielle aux OIM (35/42) dans la limite humaine de 4,5 heures.
- Vérification formelle et raisonnement mathématique par LLM : Comparaison approfondie entre noyaux formels typés par compilateur et apprentissage par renforcement non contraint.
1. Les mathématiques : L'ultime test décisif pour l'intelligence artificielle
Pourquoi les mathématiques sont-elles universellement considérées comme le banc d'essai absolu (« Litmus Test ») pour les agents cognitifs autonomes ? Tandis que les benchmarks de programmation (comme SWE-bench) ou les tâches conversationnelles autorisent des approximations heuristiques et une certaine souplesse, les mathématiques formelles imposent trois contraintes structurelles non négociables :
┌──────────────────────────────────────────────────────────────────────────┐
│             Pourquoi les mathématiques sont le test suprême de l'IA      │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Vérifiabilité mécanique │  │  Rareté extrême de la   │  │ Espace combinatoire     │
│ objective (0% hallu.)   │  │  récompense (Sparsity)  │  │ gigantesque et infini   │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Systèmes logiques     │  │ • Des centaines d'étapes│  │ • Facteur de            │
│   (Lean 4, Coq, Isabelle)│   avec 0 récompense       │    branchement infini dans │
│ • Vérificateur de type  │    jusqu'au Q.E.D. terminal│    l'espace des lemmes     │
│   déterministe par code │  │ • Récompense délivrée   │  │ • L'invention de lignes │
│ • Vérité binaire (0 ou 1)│   uniquement en cas total │    auxiliaires exige un    │
│ • Tolérance d'erreur: 0 │  │ • Attribution de crédit │    authentique génie       │
│   (Aucun crédit partiel)│    extrêmement ardue       │  │ • Brute force impossible│
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- Vérifiabilité mécanique objective (Objective Mechanical Verifiability) : Contrairement aux dissertations littéraires ou aux analyses juridiques dont l'évaluation est subjective, les mathématiques formelles sont vérifiées avec une certitude absolue par un compilateur déterministe (tel que le vérificateur de types de Lean 4).
- Rareté extrême de la récompense (Extreme Reward Sparsity) : Dans une démonstration de niveau olympique comportant des centaines d'étapes déductives, l'agent ne perçoit aucune récompense intermédiaire jusqu'à la résolution complète (
Goal Solved). Une preuve exacte à 99% mais erronée sur la dernière ligne reçoit une récompense nulle. - Espace de recherche combinatoire massif (Massive Combinatorial Search Space) : Contrairement aux échecs (facteur de branchement $\approx 35$) ou au jeu de Go ($\approx 250$), l'espace des lemmes mathématiques, des définitions et des constructions auxiliaires est illimité ($b \to \infty$).
2. Synthèse neuro-symbolique : AlphaGeometry (Trinh et al., Nature 2024)
Les problèmes de géométrie euclidienne aux Olympiades Internationales de Mathématiques représentent un défi redoutable même pour les esprits les plus brillants. Même si un candidat mémorise tous les théorèmes des manuels, il ne peut progresser s'il ne conçoit pas une construction auxiliaire (Auxiliary Construction) créative — comme tracer un cercle circonscrit passant par trois points non triviaux ou abaisser une hauteur spécifique.
Historiquement, l'intelligence artificielle était scindée en deux camps irréconciliables :
- Moteurs déductifs symboliques (DDAR) : Extrêmement véloces, 100% rigoureux et exempts d'erreurs de calcul, mais dépourvus de toute intuition créatrice. Dès que les règles axiomatiques s'épuisent, le moteur s'arrête net.
- Réseaux neuronaux profonds (Transformers) : Dotés d'une intuition aiguë et d'une reconnaissance de formes remarquable, mais sujets aux hallucinations de coordonnées, erreurs d'arrondi et conjectures infondées.
AlphaGeometry a harmonisé ces deux approches au sein d'une architecture asymétrique et symbiotique :
               +-------------------------------------------+
               |        Problème de Géométrie Euclidienne  |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |  Moteur Symbolique (DDAR)  | <---------+
                        |  - Base Déductive (DD)     |           |
                        |  - Moteur Algébrique (AR)  |           |
                        +--------------+-------------+           |
                                       |                         |
                         [Objectif de preuve atteint ?]          |
                           /                   \                 |
                        (Oui)                  (Non / Bloqué)    |
                         /                       \               |
                        v                         v              |
             +--------------------+    +-----------------------+ |
             | Démonstration      |    | Transformer de 150M   | |
             | Finale Lisible     |    | Proposeur Auxiliaire  | |
             +--------------------+    +-----------+-----------+ |
                                                   |             |
                                      [Prédit les éléments       |
                                       auxiliaires indispensables│
                                                   +-------------+
Le moteur de synthèse de 100 millions de données
Le goulot d'étranglement majeur résidait dans la pénurie de données : dans toute l'histoire olympique, il existait moins de 1 000 preuves géométriques formalisées. DeepMind a élaboré un pipeline de génération synthétique :
- Génération de graphes aléatoires : Échantillonnage d'un milliard de configurations aléatoires de points, segments et cercles.
- Traçage déductif avant : Le moteur symbolique DDAR a extrait systématiquement plus de 100 millions de théorèmes géométriques valides au sein de ces figures fortuites.
- Filtrage par dépendance auxiliaire : Isolement de 9 millions de preuves où le théorème final n'était démontrable que si une construction auxiliaire précise avait été injectée.
- Distillation supervisée : Entraînement d'un Transformer de 150 millions de paramètres pour prédire exactement ces constructions indispensables dès que le moteur symbolique cale.
Résultats aux OIM
Sur un banc d'essai de 30 problèmes géométriques historiques des OIM :
- La méthode symbolique de référence antérieure (méthode de Wu) n'a résolu que 10 problèmes.
- AlphaGeometry a résolu 25 des 30 problèmes dans le temps officiel imparti, rivalisant avec les médaillés d'or humains.
- Lors du problème 1 des OIM 2004, AlphaGeometry a découvert qu'une prémisse posée par les auteurs était mathématiquement superflue, formulant un théorème plus général et élégant.
3. La démonstration comme jeu de plateau : AlphaProof (Nature 2025)
Cependant, la géométrie n'est qu'une branche des mathématiques. Pour aborder la théorie des nombres, l'algèbre abstraite et la combinatoire, un agent doit manipuler des propositions formelles à travers des chaînes déductives rigoureuses.
En juillet 2024, l'équipe du Dr Thang Luong a dévoilé AlphaProof, un système concevant la preuve de théorèmes comme un jeu à somme nulle opposant l'agent à un compilateur intraitable.
┌──────────────────────────────────────────────────────────────────────────┐
│                   Architecture Système AlphaProof                        │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Auto-formalisateur Gemini│                   │ Réseau de Recherche       │
├──────────────────────────┤                   │ AlphaZero                 │
│ • Énoncés en texte brut  │                   ├───────────────────────────┤
│ • 100M de problèmes bruts│                   │ • Transformer de 3B params│
│ • Validation rétro-trad. │                   │ • Politique tactique :    │
│ • Code formel Lean 4     │                   │   apply, rw, linarith     │
│ • 80M théorèmes valides  │                   │ • Tête de valeur :        │
└────────────┬─────────────┘                   │   Distance au Q.E.D. final│
             │                                 └─────────────┬─────────────┘
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Noyau Formel Lean 4      │
                      ├─────────────────────────────┤
                      │ • Vérificateur de type      │
                      │ • Boucle de rétroaction     │
                      │ • Validation binaire (0/1): │
                      │   - Compilation de tactique │
                      │   - Inhabitation de type    │
                      └─────────────────────────────┘
L'environnement Lean 4 : L'échiquier infini des mathématiques
Lean 4 est un langage de programmation purement fonctionnel reposant sur le Calcul des Constructions Inductives (CIC). Selon l'isomorphisme de Curry-Howard :
- Une Proposition mathématique correspond à un Type.
- Une Preuve mathématique correspond à un Terme (Programme) qui habite ce type.
- Le Compilateur Lean sert d'arbitre infaillible : si le code compile sans erreur, le théorème est prouvé à 100%.
À chaque étape, l'agent observe l'état actuel (Goal) et joue des tactiques formelles telles que induction, ring, rw [mul_comm] ou linarith.
Auto-formalisation : Constitution de 80 millions de théorèmes
Moins de 1 000 mathématiciens dans le monde maîtrisent couramment Lean 4. DeepMind a mobilisé les modèles Gemini pour traduire automatiquement des millions d'exercices de manuels scolaires vers des spécifications Lean 4, constituant une bibliothèque de 80 millions d'énoncés mathématiques formalisés.
Apprentissage par renforcement au moment du test (TTRL)
Face au problème 6 des OIM 2024 — un redoutable problème de combinatoire résolu par seulement 5 candidats sur 609 — la politique standard d'AlphaProof s'est trouvée bloquée. DeepMind a alors activé le TTRL :
[Entrée : Problème 6 des OIM 2024]
         │
         ▼
[Générateur automatisé de problèmes Gemini]
         │
         ├──> Synthèse immédiate de 400 000 variations structurelles du problème
         │    (Paramètres réduits, cas limites, lemmes intermédiaires)
         ▼
[Cluster de calcul mobilisant des milliers de TPU v5e]
         │
         ├──> Auto-jeu AlphaZero exécuté sur ces 400 000 variations
         ├──> Ajustement dynamique des poids du modèle durant 3 jours
         ▼
[Modèle expert sur-mesure produit au moment du test]
         │
         ▼
[Démonstration Lean 4 complète du problème 6 vérifiée à 100% !]
AlphaProof a résolu 4 problèmes sur 6, totalisant 28 points sur 42 : une Médaille d'Argent officielle aux OIM (à 1 seul point de la médaille d'or).
4. Le triomphe du langage naturel pur : Gemini Deep Think (IMO 2025)
Malgré l'éclatant succès d'AlphaProof, deux limites pratiques subsistaient :
- La conversion préalable des énoncés en code Lean 4 nécessitait un pipeline complexe.
- Le processus TTRL mobilisait 3 jours de calcul massif, dépassant la contrainte humaine de 4,5 heures par jour d'épreuve.
En juillet 2025, DeepMind a dévoilé Gemini Deep Think, démontrant que le raisonnement direct en langage naturel peut atteindre l'or olympique sans traduction formelle :
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think : Pensée Parallèle                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Branche Hypothétique A  │  │ Branche Hypothétique B  │  │ Branche Hypothétique C  │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Substitution algébriq.│  │ • Inversion géométrique │  │ • Bornes combinatoires  │
│ • Progression : 4 étapes│  │ • Bloqué au Lemme 3     │  │ • Borne asymptotique OK │
│ • Auto-détection erreur │  │ • Élagage immédiat      │  │ • Intégré dans l'hypoth.│
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
Gemini Deep Think déploie une Pensée Parallèle (Parallel Thinking) :
- L'agent explore simultanément des dizaines de pistes algébriques, géométriques et analytiques.
- Dès qu'une voie échoue, le système en extrait les invariants partiels pour nourrir les autres branches actives.
- Respectant la limite stricte de 4,5 heures, il a résolu 5 problèmes sur 6 (35 points sur 42), remportant la première Médaille d'Or officielle aux OIM de l'histoire de l'IA.
5. Synthèse comparative : Vérification formelle vs RL en langage naturel
+-----------------------+----------------------------------+----------------------------------+
| Axe de Comparaison    | Vérification Formelle (Lean 4)   | RL en Langage Naturel (DeepThink)|
+-----------------------+----------------------------------+----------------------------------+
| Moteur de Contrôle    | Vérificateur de type de Lean 4   | LLM multi-agents & auto-critique |
| Risque d'Hallucination| Strictement 0% (Preuve formelle) | > 0% (Risque d'inférence subtile)|
| Durée de Recherche    | Heures à 3 jours (MCTS + TTRL)   | 4,5 heures (Inférence en direct) |
| Domaines Cibles       | Logiciels critiques, cryptologie | Recherche ouverte, prospective   |
| Dépendance Système    | Écosystème Lean 4 & Mathlib      | Supercalculateurs RL distribués  |
+-----------------------+----------------------------------+----------------------------------+
6. Enseignements clés pour l'ingénierie de l'IA
- Les données synthétiques amorcent le raisonnement avancé : AlphaGeometry a prouvé qu'en cas de pénurie de données empiriques, les moteurs déductifs peuvent synthétiser des centaines de millions de preuves pour forger l'intuition neuronale.
- La vérification formelle éradique l'hallucination : Dans les secteurs à tolérance zéro, les modèles doivent impérativement s'adosser à des compilateurs déterministes comme Lean 4.
- Le calcul en inférence (TTRL) repousse les frontières : AlphaProof a validé que l'adaptation dynamique des poids au moment du test libère des capacités inaccessibles aux modèles figés.
- La pensée parallèle rivalise avec l'humain : Gemini Deep Think a montré que le raisonnement parallèle permet d'atteindre l'excellence olympique en temps réel.
Dans notre prochain cours, Cours 15 : Systèmes Autonomes et Fiabilité, nous quitterons la perfection mathématique pour affronter la complexité des systèmes logiciels réels : auto-réparation (Self-Healing), sandboxes sécurisées et garde-fous opérationnels. Ne manquez pas ce rendez-vous !