Stanford CS329A (Ep 16): Multimodal & Embodied Agents — Modèles fondation robotiques pour le monde physique (VLA, RT-2, OpenVLA et π₀)

Dans notre précédent cours consacré aux Systèmes Autonomes et à la Fiabilité, nous avons vu comment les agents logiciels opèrent au sein de bacs à sable virtuels sécurisés par des harnais de défense et des protocoles de contrôle. Cependant, une interrogation fondamentale interpelle la communauté scientifique :
"Une intelligence cantonnée aux écrans d'ordinateur, générant du texte et exécutant des scripts, peut-elle réellement prétendre au titre d'Intelligence Artificielle Générale (AGI) ? Notre réalité physique n'est pas régie par des commandes shell ; elle est façonnée par la gravité, les frottements, la géométrie 3D euclidienne et les contacts subtils entre corps rigides et déformables."
Que se passe-t-il lorsque nous dotons un modèle fondation d'une incarnation physique — de deux yeux haute résolution (caméras RGB) et d'un bras articulé en acier à sept degrés de liberté (manipulateur robotique) ?
- Saisir un œuf cru sans en briser la coquille pour le poser délicatement sur une poêle ;
- Trier par couleur les jouets d'enfants disséminés sur le sol d'un salon dans leurs bacs respectifs ;
- Aligner et insérer avec une précision de 0,1 millimètre des connecteurs micro-électroniques sur une chaîne de montage !
Bienvenue dans le Cours 16 de Stanford CS329A: Self-Improving AI Agents, quatrième volet de la Partie 4 : Frontières (Frontiers in Reasoning & Autonomy). Inspirés des recherches pionnières du Dr Danny Driess (Chercheur fondateur chez Physical Intelligence, ex-responsable chez Google DeepMind Robotics), nous décortiquons l'architecture des modèles Vision-Langage-Action (VLA, Vision-Language-Action) :
- L'action comme modalité du langage (RT-2, DeepMind 2023) : La conversion des commandes cinématiques continues à 7DoF en 256 tokens discrets intégrés au vocabulaire d'un VLM de 55 milliards de paramètres.
- La percée de l'open source (OpenVLA, 2024) : Comment un modèle de 7B surpasse les modèles fermés de 55B grâce à la fusion visuelle duale SigLIP + DINOv2, au binning par quantiles et à l'adaptation LoRA sur GPU grand public.
- Contrôle continu et politiques de diffusion ($\pi_0$) : Dépasser les micro-vibrations de la discrétisation pour maîtriser les objets déformables comme le pliage du linge et l'assemblage de cartons.
- Architecture de sécurité incarnée : La double barrière logicielle de bridage de vitesse et matérielle par boucle réflexe d'effort-couple.
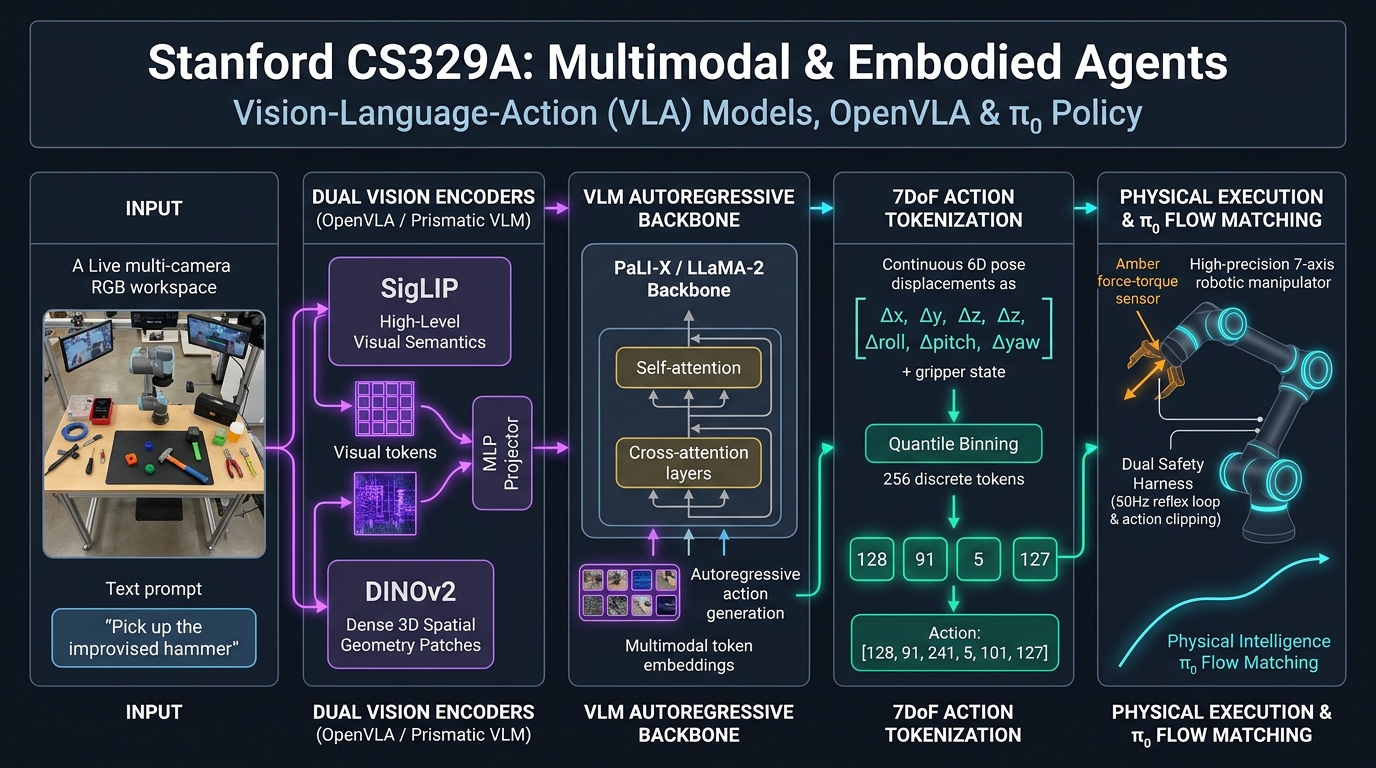
1. La frontière physique : Briser la pénurie de données en robotique
Pendant des décennies, la robotique a souffert d'une famine de données critique. Alors que les modèles de langage se nourrissaient de milliers de milliards de tokens web, la collecte de trajectoires physiques restait prohibitive :
- Elle requiert des robots physiques pilotés par téléopération humaine dans des installations dédiées.
- Une flotte de 13 robots chez Google opérant pendant 17 mois n'a permis d'accumuler qu'environ 130 000 démonstrations.
- Les politiques classiques étaient donc hypersensibles : une variation de luminosité de 10% ou un décalage de 5 cm de l'objet suffisait à faire échouer la prise.
Le Dr Danny Driess et l'équipe de DeepMind ont opéré un basculement conceptuel radical :
"Ne cherchez pas à entraîner une politique robotique à partir de rien sur un jeu de données étriqué. Prenez un modèle Vision-Langage (VLM) massif pré-entraîné sur des milliards d'images et textes du web, et apprenez-lui à émettre des commandes moteurs comme s'il s'agissait des mots d'une langue étrangère."
┌──────────────────────────────────────────────────────────────────────────┐
│              Changement de paradigme vers les modèles VLA                │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ Politique robotique classique    │   │ Modèles VLA                      │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • Petit CNN entraîné sur         │   │ • Base multimodale de 7B à 55B   │
│   quelques milliers de données   │   │ • Connaissances acquises du web  │
│ • Généralisation sémantique de 0%│   │ • Bon sens physique intégré :    │
│ • Échec au moindre décalage (5cm)│     « Une pierre sert de marteau »   │
│ • Recodage requis par tâche      │   │ • Généralisation zero-shot aux   │
│ • Silos de tâches hermétiques    │     nouveaux objets et environnements│
└──────────────────────────────────┘   └──────────────────────────────────┘
2. L'action vue comme un token : RT-2 (Brohan et al., DeepMind 2023)
En juillet 2023, Google DeepMind a dévoilé Robotic Transformer 2 (RT-2), transformant des modèles multimodaux de grande envergure (PaLI-X 55B, PaLM-E 12B) en contrôleurs robotiques de bout en bout.
[Entrée : Flux RGB] + [Consigne : « Déplace le ballon de football près de la photo de Messi »]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             Base VLA massive (PaLI-X de 55B)                  │
     │  • Savoir sémantique : Identifie le visage de Lionel Messi    │
     │  • Déduction spatiale : Calcule les coordonnées 3D relatives  │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (Génération autorégressive de tokens)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ Fermeture pince (127)
                     │       │  │   │   └──┴───┴───── Rotation 3D (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── Translation 3D (Δx, Δy, Δz)
                     └─────────────────────────────── Indicateur de poursuite
L'espace d'action 7DoF et la discrétisation uniforme à 256 niveaux
Les manipulateurs opèrent dans un espace continu à 7 degrés de liberté (7DoF) :
- Translation 3D ($\Delta x, \Delta y, \Delta z$) : Déplacement de la pince dans l'espace.
- Rotation 3D ($\Delta roll, \Delta pitch, \Delta yaw$) : Orientation du poignet.
- Ouverture de la pince ($gripper$) : État d'actionnement de l'effecteur.
Pour convertir ces vecteurs réels en tokens discrets compatibles avec le Transformer, RT-2 a mis en œuvre la discrétisation uniforme :
- La plage de mouvement
[a_min, a_max](ex.[-30cm, +30cm]) est subdivisée en 256 intervalles réguliers (bins) :
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad \text{borné dans } [0, 255]
- 256 tokens sous-utilisés du dictionnaire VLM sont affectés à ces indices d'action.
- Un masque de contrainte d'émission (Output Constraint Mask) force le modèle, lors du pilotage, à échantillonner uniquement ces 256 tokens d'action.
Transfert du bon sens vers l'action physique
En conservant son pré-entraînement web, RT-2 a démontré une remarquable polyvalence :
- N'ayant jamais vu de marteau lors de son entraînement robotique, face à une pierre et une punaise avec la consigne « Prends un marteau improvisé », il a saisi directement la pierre.
- Il a accompli des tâches complexes impliquant des notions culturelles (« Jette la canette vide à la poubelle »), multipliant par trois le taux de réussite par rapport à son prédécesseur RT-1.
Co-Fine-Tuning : Préserver les capacités cognitives
Entraîner un modèle de 55B sur les seules trajectoires robotiques provoque un oubli catastrophique (Catastrophic Forgetting) de ses connaissances textuelles. RT-2 a remédié à cela par le co-fine-tuning, en mélangeant systématiquement dans chaque batch des données robotiques et des paires texte-image classiques du web.
3. L'essor de l'open source : OpenVLA (2024)
Malgré sa puissance, RT-2 exigeait des clusters de TPU cloud et demeurait un modèle fermé inaccessible aux laboratoires universitaires.
En 2024, des chercheurs de Stanford et Berkeley ont publié OpenVLA, un modèle VLA généraliste de 7B entièrement open source, entraîné sur le jeu Open X-Embodiment (970 000 trajectoires sur 22 robots distincts).
               +-------------------------------------------+
               |             Image Caméra RGB              |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   Encodeur SigLIP  |     |   Encodeur DINOv2  |
             | (Sémantique visuel |     | (Géométrie et      |
             |  de haut niveau)   |     |  profondeur 3D)    |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (Concaténation sur l'axe des canaux)
                                     v
                        +----------------------------+
                        |      Projecteur MLP 2-Layer|
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |   Dorsale Llama-2 7B       |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        | 256 Tokens par Quantiles   |
                        +----------------------------+
1. Fusion visuelle duale : SigLIP + DINOv2 (Prismatic VLM)
La manipulation fine requiert à la fois la compréhension sémantique (« Qu'est-ce que c'est ? ») et la géométrie au millimètre près (« Où se trouve l'anse de la tasse ? ») :
- SigLIP : Efficace pour associer concepts linguistiques et zones imagées.
- DINOv2 : Extrait avec acuité la profondeur et les détails géométriques 3D.
- La concaténation de ces deux flux a amélioré la précision de saisie de plus de 20% par rapport à l'usage de SigLIP seul.
2. Discrétisation par quantiles (Quantile Binning)
La répartition uniforme de RT-2 présentait une faiblesse : 90% des mouvements réels sont des micro-ajustements délicats, tandis que les grands déplacements rapides représentent moins de 1%.
- OpenVLA a découpé les 256 niveaux selon les quantiles empiriques des trajectoires :
\text{Limites des Bins : } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- Cela concentre la résolution là où le geste requiert la plus grande minutie, réduisant considérablement les échecs de prise.
3. Ajustement LoRA sur un simple GPU RTX 4090
- En gelant les encodeurs visuels et en appliquant LoRA sur seulement 1,4% des paramètres de Llama-2, OpenVLA s'adapte à un nouveau bras robotique en moins de 15 heures.
- La quantification 4-bit (NF4) réduit l'empreinte mémoire à 7 Go de VRAM, permettant un pilotage en temps réel à 6 Hz sur une carte grand public (NVIDIA RTX 4090).
- Sur 29 tâches réelles, OpenVLA a dépassé le géant RT-2-X de 55B avec un taux de réussite moyen supérieur de 16,5%.
4. Le contrôle continu : Physical Intelligence $\pi_0$ (2024)
Bien que performante, la tokenisation discrète rencontre des écueils physiques :
- L'erreur de discrétisation induit des micro-vibrations (jittering) indésirables à haute fréquence (>50 Hz).
- Manipuler des corps souples — plier du linge, monter des boîtes en carton — exige des profils de vitesse continus.
Le Dr Danny Driess et l'équipe de Physical Intelligence ont conçu $\pi_0$ (pi-zero) via le Flow Matching :
┌──────────────────────────────────────────────────────────────────────────┐
│                   Architecture Physical Intelligence π₀                  │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Planificateur VLM Global │                   │ Politique de Diffusion    │
├──────────────────────────┤                   │ Continue (Flow Matching)  │
│ • Analyse de scène       │                   ├───────────────────────────┤
│ • Planification longue   │ ── Vecteur but ──►│ • Inférence temps réel 50Hz│
│ • Suivi de sous-objectifs│                   │ • Champ vectoriel continu │
└──────────────────────────┘                   │ • Zéro vibration parasite │
                                               └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [Trajectoire Continue Fluide]
                                               (Plie le linge et les boîtes)
$\pi_0$ utilise le VLM pour désigner les intentions globales, tandis que la politique continue génère des trajectoires fluides par débruitage en temps réel, réalisant pour la première fois des manipulations complexes d'objets souples avec une politique unifiée.
5. Synthèse comparative des modèles robotiques
+-----------------------+----------------------------------+----------------------------------+
| Caractéristique       | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| Taille du Modèle      | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Dorsale Llama-2)             |
| Encodeur Visuel       | ViT unique                       | Fusion duale (SigLIP + DINOv2)   |
| Discrétisation Action | 256 Bins uniformes               | 256 Bins par quantiles           |
| Configuration Requise | Cluster de TPU cloud             | GPU grand public unique (RTX4090)|
| Efficacité Adaptation | Fine-tuning intégral             | 1,4% LoRA + Quantification 4-bit |
| Statut Open Source    | Propriétaire / Fermé             | 100% Poids et code ouverts       |
+-----------------------+----------------------------------+----------------------------------+
6. Sûreté incarnée : L'architecture réflexe à deux niveaux
Les robots déployés dans le monde réel exercent des forces physiques susceptibles d'endommager l'environnement ou de blesser des opérateurs. Une architecture réflexe à double niveau est donc indispensable :
[Sortie d'Action du Modèle VLA : Delta 7DoF]
                 │
                 ▼
[Niveau 1 : Écrêtage Logiciel de Vitesse et Enveloppe Spatiale]
  ├── Plafonnement vitesse max : ||Δpos|| <= 5 cm par pas
  └── Confinement strict dans le volume virtuel de travail (Bounding Box)
                 │
                 ▼
[Niveau 2 : Boucle Réflexe Matérielle Effort-Couple (1000 Hz)]
  ├── Si la force de contact mesurée F_contact > 20 Newtons :
  └── Débrayage immédiat de l'ordre VLA -> Arrêt d'urgence / Mode souple
- Écrêtage d'action logiciel : Si la consigne calculée excède les marges tolérables (ex. plus de 5 cm par pas), le contrôleur bride automatiquement le déplacement.
- Réflexe matériel effort-couple : À 1 000 Hz sur les moteurs, si un contact imprévu est ressenti (collision avec un humain), le système coupe instantanément l'alimentation pour éviter tout choc brutal.
7. Directives majeures pour l'ingénierie d'IA
- L'action physique est une modalité du langage : Traiter le mouvement comme des tokens de vocabulaire permet de transposer l'immense savoir du web vers les moteurs physiques.
- La double vision est cruciale : Allier la sémantique de SigLIP à la géométrie dense 3D de DINOv2 conditionne la précision des prises complexes.
- Le binning par quantiles élimine les imprécisions : Aligner les niveaux discrets sur les mouvements réels résout le manque de précision aux abords des objets.
- La diffusion continue préfigure l'avenir : Les approches Flow Matching comme $\pi_0$ effacent les à-coups et permettent enfin d'aborder la manipulation de matières souples.
Lors de notre ultime rendez-vous, Cours 17 (GRAND FINALE) : Perspectives de Recherche Futures, nous réunirons les fils conducteurs des 17 cours de Stanford CS329A pour dresser la feuille de route vers l'intelligence artificielle générale. Rendez-vous au grand final !