[Stanford CS329A #6] Montée en Échelle à l'Entraînement et RL : DeepSeekMath, GRPO et Optimisation Massive du Raisonnement

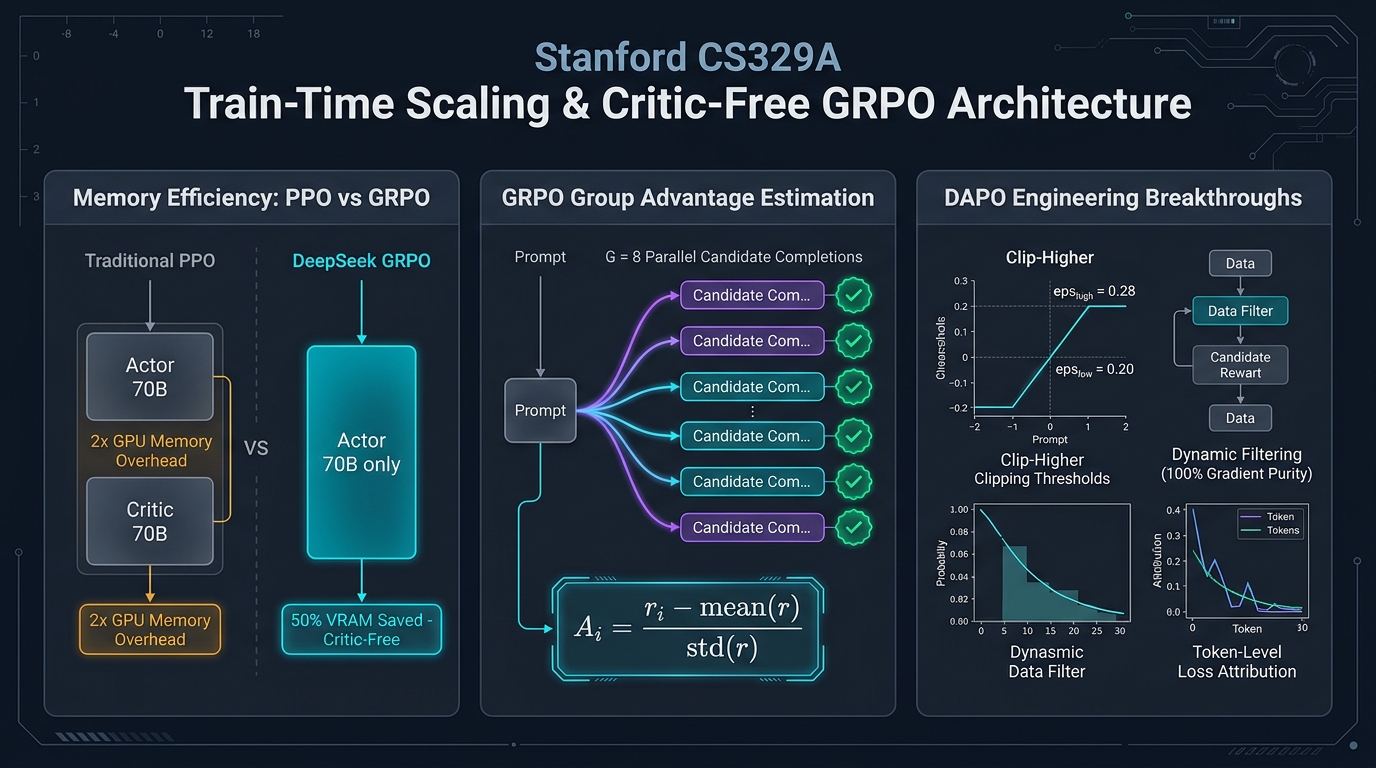
Bienvenue dans ce sixième volet de notre analyse technique consacrée au cours de master de l'Université Stanford, CS329A: Self-Improving AI Agents (Automne 2025).
Tout au long des cours 1 à 5 (Partie 1 : Fondations), nous avons appris à tirer le potentiel maximal de modèles pré-entraînés figés en leur allouant du calcul lors de l'inférence (Test-time Compute) : déploiement d'arbres de recherche MCTS, intégration des erreurs de compilateur et filtrage par comités de vérificateurs.
Cependant, une vérité mathématique s'impose : Accorder dix minutes supplémentaires à un élève de primaire lors d'un examen ne lui permettra pas d'établir une démonstration d'analyse infinitésimale. Si les connexions synaptiques figées d'un modèle (paramètres de poids, $\theta$) n'intègrent pas intrinsèquement les concepts mathématiques requis, générer 10 000 trajectoires ou recourir à des faisceaux de recherche ne relève pas de l'intelligence, mais de la pure chance stochastique.
Aujourd'hui débute la Partie 2 : Entraînement et Évolution (Cours 6 à 9), répondant à la question fondamentale suivante :
« Plutôt que de gaspiller des ressources considérables à chaque inférence, comment investir un calcul massif durant l'entraînement pour réécrire définitivement les poids neuronaux du modèle et en faire un raisonneur d'élite ? »
Dans ce cours 6, nous disséquons les trois piliers méthodologiques qui ont aboli les goulets d'étranglement de l'annotation humaine et révolutionné le raisonnement via l'Apprentissage par Renforcement Post-Entraînement (Post-Training RL) :
- L'auto-amorçage du raisonnement déductif : Self-Taught Reasoner (STaR, Zelikman et al., Stanford 2022).
- La fin du modèle critique : Group Relative Policy Optimization (GRPO, DeepSeekMath 2024).
- Le passage à l'échelle sur 1 000 GPUs : Élagage découplé et échantillonnage dynamique (DAPO, 2025).
flowchart TD
    subgraph ParadigmShift ["Changement de Paradigme : Inférence vs Entraînement"]
        direction TB
        TestTime["Partie 1 : Montée en Échelle à l'Inférence (Test-Time Scaling)<br/>• Poids neuronaux figés (θ = constant)<br/>• Recherche externe à l'exécution (MCTS, ReAct, RLEF)<br/>• Latence élevée et coût d'infrastructure récurrent"]
        --> TrainTime["Partie 2 : Montée en Échelle à l'Entraînement (Train-Time RL)<br/>• Optimisation active des gradients de poids (θ ← θ + Δθ)<br/>• Intériorisation synaptique de l'instinct stratégique<br/>• Inférence ultra-rapide en passe unique (Single-Pass)"]
    end

    subgraph RLEvolution ["L'Évolution du RL pour le Raisonnement"]
        direction TB
        M1["STaR (Stanford 2022)<br/>• Le modèle apprend de ses propres déductions exactes<br/>• Rationalisation : inférence inverse guidée par indices<br/>• Un modèle 6B égale GPT-3 175B sur CommonsenseQA"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• Élimination du modèle critique (50 % de VRAM économisée)<br/>• Calcul de l'avantage par Z-score sur un groupe de G sorties<br/>• Un modèle 7B open-source bat Google Minerva 540B sur MATH"]
        --> M3["DAPO (Ingénierie Industrielle Ouverte 2025)<br/>• Écrêtage asymétrique Clip-Higher empêchant l'effondrement d'entropie<br/>• Échantillonnage dynamique filtrant les lots à variance nulle<br/>• Qwen-32B bat le record d'AIME en deux fois moins d'étapes"]
    end

    ParadigmShift ==> RLEvolution