[Stanford CS329A #5] Planification Multi-Étapes et Recherche Arborescente : ADaPT, LATS, SPRINT et MCTS pour Agents

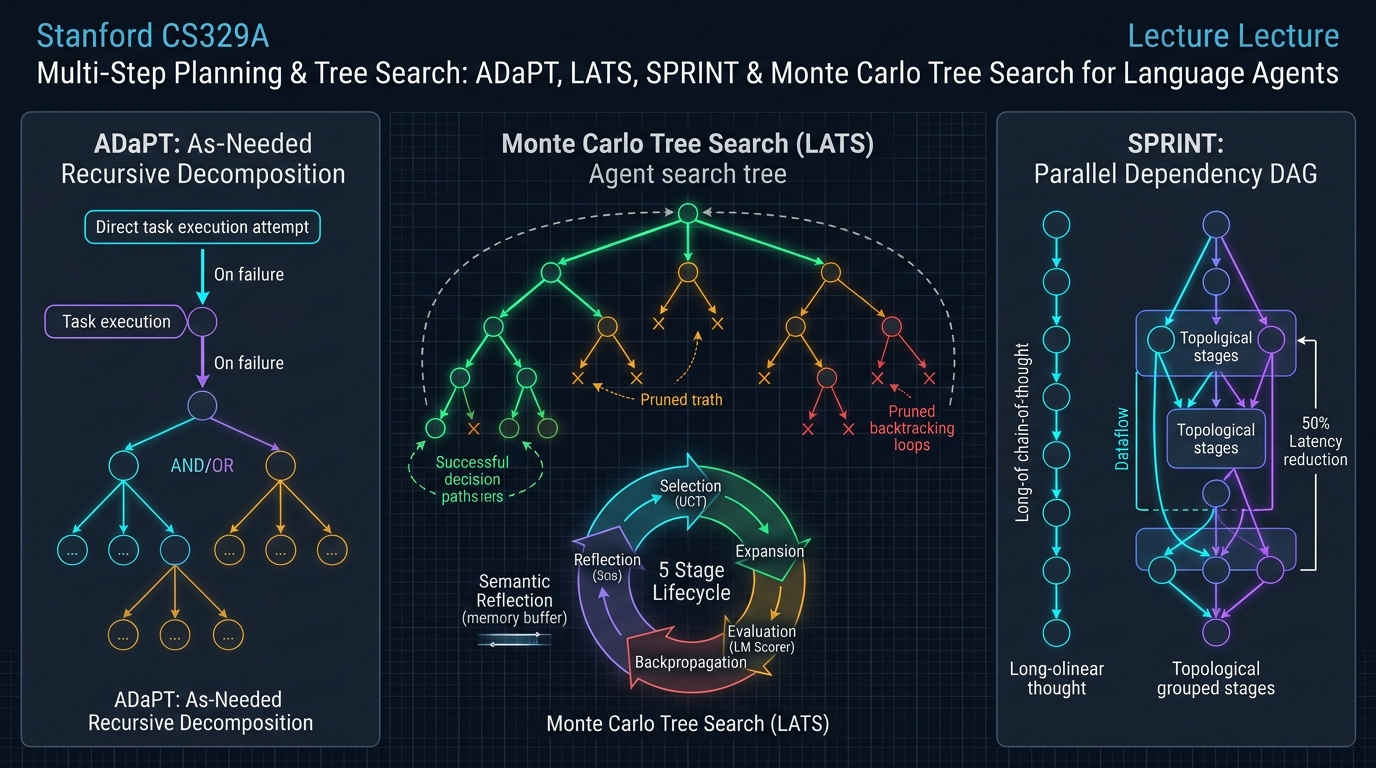
Bienvenue dans le cinquième volet de notre analyse technique approfondie du cours de master de l'Université Stanford, CS329A: Self-Improving AI Agents (Automne 2025).
Dans le cours 4, nous avons vu comment les agents brisent les limites de la mémoire statique en interagissant avec des outils externes et en corrigeant leur code via les boucles de rétroaction de compilateurs (ReAct, RLEF). Cependant, résoudre une erreur de syntaxe locale est sans commune mesure avec la conception architecturale d'un système logiciel complexe de 100 000 lignes ou la résolution de problèmes scientifiques à long horizon.
Les approches conventionnelles basées sur ReAct ou les chaînes de pensée (CoT) sont intrinsèquement des recherches gloutonnes à trajectoire unique (Greedy Single-Path) : elles évaluent l'étape immédiatement suivante et avancent de façon irréversible. À l'image d'un joueur d'échecs débutant qui ne calcule que le coup suivant et se retrouve échec et mat trois tours plus tard, un modèle linguistique autorégressif qui commet une déduction initiale erronée se retrouve irrémédiablement piégé dans une impasse.
Le cours 5 constitue le grand final de la Partie 1 (Fondations) du cursus de Stanford : la Planification Multi-Étapes (Multi-Step Planning) et la Recherche Arborescente (Tree Search).
En intégrant le moteur algorithmique d'AlphaGo — la Recherche Arborescente de Monte-Carlo (MCTS) — aux modèles de langage autorégressifs, nous transformons des prédicteurs textuels réactifs en grands maîtres stratèges. Nous décortiquons des architectures capables d'anticiper des dizaines de coups à l'avance, d'élaguer dynamiquement les impasses, de revenir en arrière dans l'arbre décisionnel (Backtracking) et de paralléliser les flux de raisonnement :
- Unification de la déduction, de l'action et de la planification : Language Agent Tree Search (LATS, Zhou et al., 2023).
- Décomposition récursive à la demande : Découpage modulaire déclenché uniquement en cas d'échec via ADaPT (Allen AI, 2023).
- Parallélisation par DAG de dépendances : Réduction de la latence d'inférence de 53,5 % via SPRINT (Stanford Future Data, 2025).
- Bifurcation adaptative par échantillonnage de Thompson : Résolution du dilemme largeur/profondeur avec AB-MCTS (Sakana AI, 2025).
- Intériorisation de la planification dans les poids neuronaux : SWiRL (Step-Wise RL, 2025).
flowchart TD
    subgraph MCTS_Loop ["Cycle de Vie MCTS de l'Agent LATS"]
        direction TB
        Root["État Racine : Objectif Utilisateur / Spécification"]
        --> Select["1. Sélection : Descente via la Métrique UCT"]
        --> Expand["2. Expansion : Échantillonnage de n Actions Candidates"]
        --> Eval["3. Évaluation : Score Qualitatif LM + Auto-Cohérence"]
        --> Backprop["4. Rétropropagation : Mise à Jour des Valeurs Scalaires"]
        --> Reflect["5. Réflexion Sémantique : Analyse Textuelle d'Erreur"]
    end

    subgraph PlanningParadigms ["Éventail des Méthodes de Planification"]
        direction TB
        P1["LATS (Recherche MCTS)<br/>• Exploitation de l'historique de prompt pour un retour arrière sans surcoût<br/>• HumanEval à 92,7 % ; HotpotQA bondit de 32 % à 71 %"]
        --> P2["ADaPT (Décomposition à la Demande)<br/>• Refus des plans rigides a priori ; exécution directe initiale<br/>• Scission récursive en sous-tâches AND/OR déclenchée sur échec"]
        --> P3["SPRINT (Parallélisation par DAG)<br/>• Identification automatique des sous-étapes indépendantes<br/>• Exécution concurrente sur grappe GPU ; latence réduite de 53,5 %"]
        --> P4["SWiRL (Apprentissage par Renforcement par Étapes)<br/>• Intériorisation de la vision stratégique MCTS dans les poids du modèle<br/>• Inférence en une seule passe avec capacité d'anticipation globale"]
    end

    MCTS_Loop ==> PlanningParadigms