Aller au contenu principal

2 articles tagués avec « test-time-compute »

Voir tous les tags

[Stanford CS329A #2] Mise à l'Échelle du Calcul à l'Inférence : Au-Delà du Pré-Entraînement vers l'Inférence Optimale

· 13 minutes de lecture
Jaybee
AI & Robotics Engineer

Stanford CS329A Test-Time Compute Scaling

Bienvenue dans le deuxième volet de notre analyse technique approfondie du cours d'élite de l'Université de Stanford, CS329A : Self-Improving AI Agents (Automne 2025).

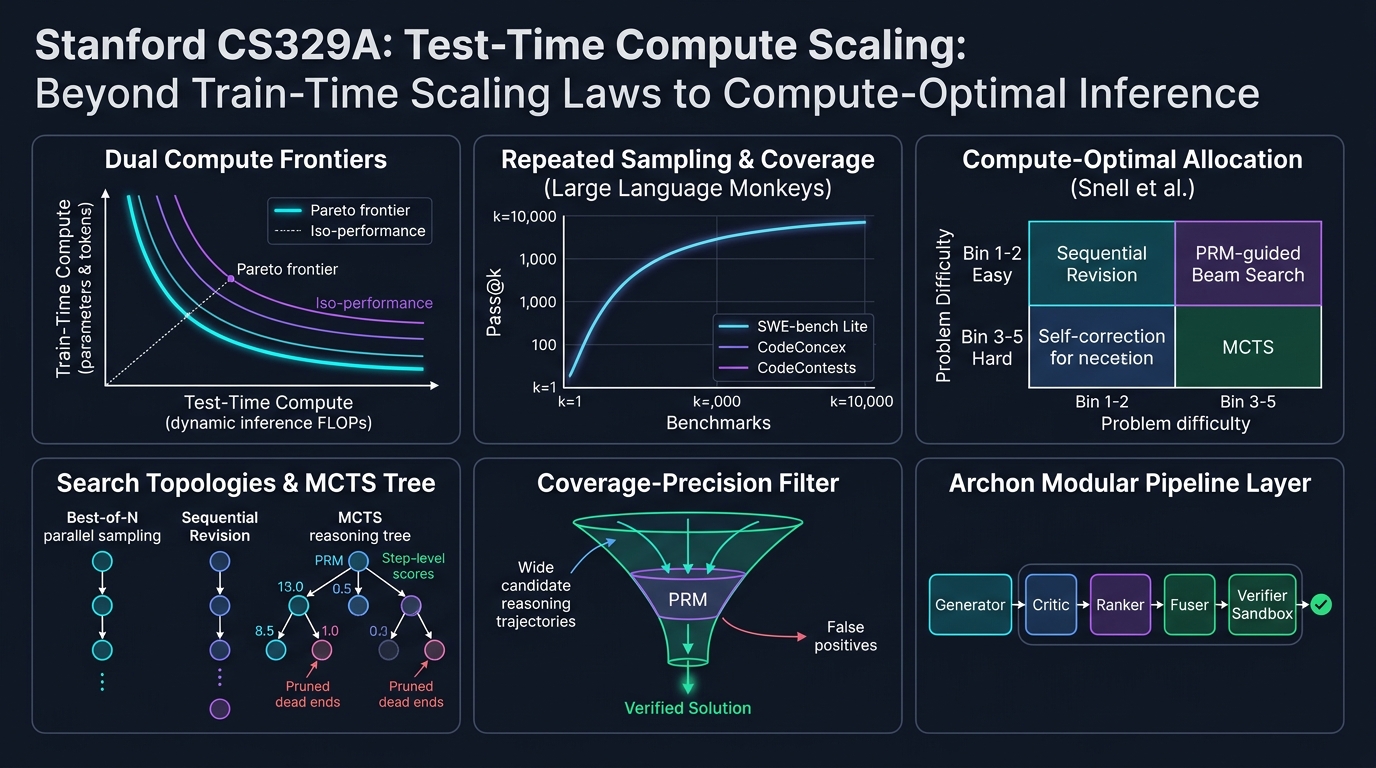
Lors du cours inaugural, nous avons exposé le changement de paradigme macroéconomique transformant les prédicteurs statiques de prochain jeton en boucles agentiques autonomes fermées sur leur environnement. Aujourd'hui, nous nous attaquons au pilier computationnel indispensable à cette autonomie : la mise à l'échelle du calcul au moment de l'inférence (Test-Time Compute Scaling / Inference-Time Scaling).

Pendant plus d'une demi-décennie, le dogme dominant de l'IA a été dicté par les lois d'échelle du pré-entraînement (Kaplan et al., Chinchilla) : construire des grappes de GPU gigantesques, élargir le volume de paramètres N et absorber des dizaines de milliers de milliards de jetons web. Cependant, une fois les poids θ du modèle gelés, que se passe-t-il si nous refusons une réponse gloutonne (greedy) précipitée en 50 millisecondes ? Que se passe-t-il si un agent consacre 10 secondes, 1 minute ou 10 minutes à explorer délibérément des arbres de raisonnement, à vérifier des étapes intermédiaires et à réviser ses hypothèses ?

À travers les découvertes empiriques de Large Language Monkeys (Brown et al., 2024), l'étude Compute-Optimal Scaling de Snell et al. (Stanford/UC Berkeley, 2024) et le framework d'architecture modulaire Archon, nous formalisons mathématiquement comment l'investissement de FLOPs d'inférence en substitution de la taille des paramètres redéfinit l'intelligence artificielle contemporaine.

flowchart TD
subgraph PreTrain ["Frontière Classique : Mise à l'Échelle à l'Entraînement"]
direction TB
P1["Milliards de Jetons Web (D)"] --> P2["Grappes de GPU Massives (C_train)"]
P2 --> P3["Modèle Dense Gelé (θ)"]
P3 --> P4["Passe Avant Gloutonne Unique (Calcul Fixe O(1))"]
end

subgraph TestTime ["Frontière CS329A : Mise à l'Échelle à l'Inférence"]
direction TB
T1["Poids de Base Gelés (θ)"] --> T2["Allocation Dynamique de FLOPs à l'Inférence"]
T2 --> T3{"Sélection Adaptative selon la Difficulté"}
T3 -- "Faible Difficulté (Bin 1-2)" --> T4["Révision Séquentielle (Autocorrection)"]
T3 -- "Forte Difficulté (Bin 3-5)" --> T5["Recherche Arborescente Guidée par PRM (MCTS / Beam Search)"]
T4 --> T6["Vérificateur de Modèle de Récompense de Processus (PRM)"]
T5 --> T6
T6 --> T7["Solution Finale Vérifiée Mathématiquement et Mécaniquement"]
end

PreTrain -.->|"Point d'Inflexion : Saturation des Paramètres"| TestTime
[Stanford CS329A #1] Vue d'ensemble du cours : Des grands modèles de langage aux agents IA auto-évolutifs

· 13 minutes de lecture
Jaybee
AI & Robotics Engineer

Stanford CS329A Agents IA Auto-Évolutifs

Bienvenue dans l'analyse technique approfondie du cours CS329A de l'Université Stanford : Self-Improving AI Agents (Agents d'IA Auto-Évolutifs, Automne 2025).

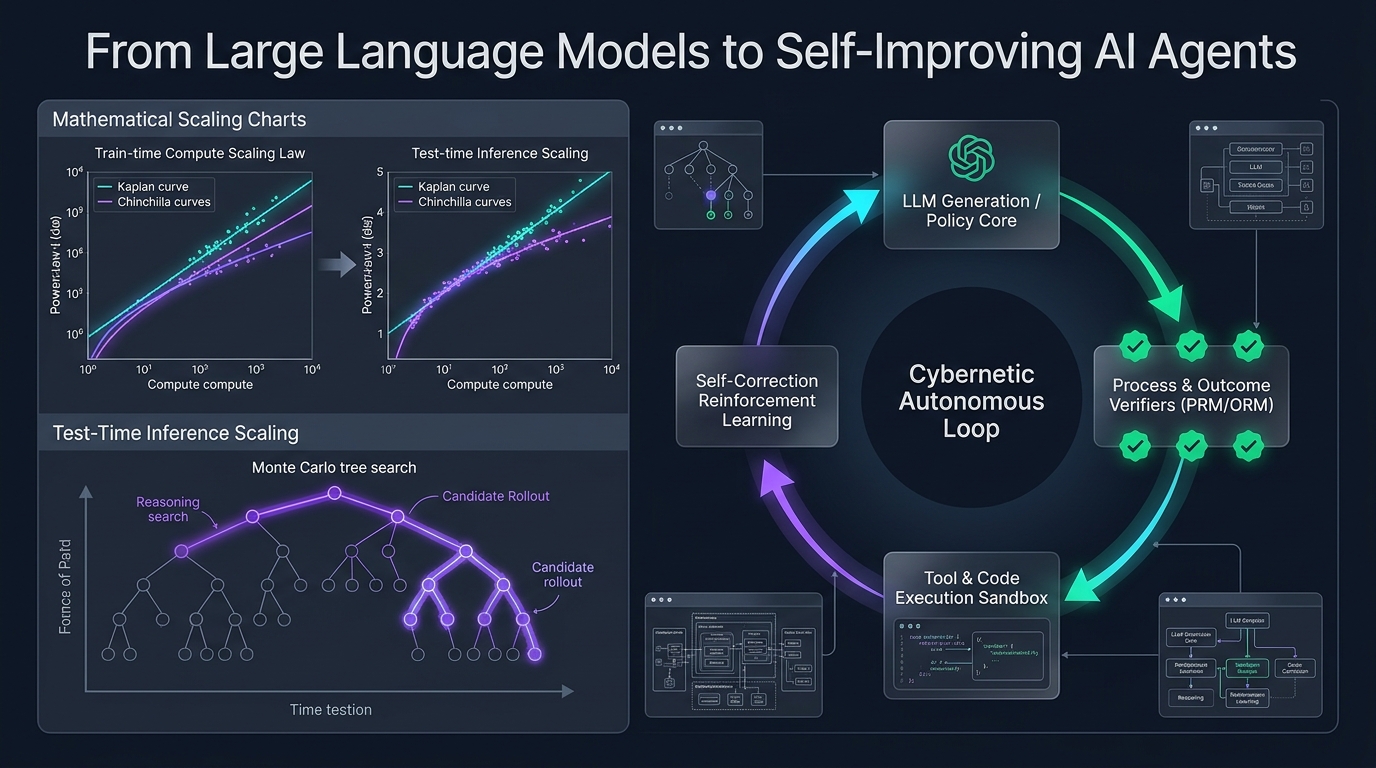
Au cours des quatre dernières années, l'écosystème de l'intelligence artificielle a été gouverné par un dogme unique et prédominant : le pré-entraînement de modèles toujours plus vastes sur des corpus textuels gigantesques engendre des capacités cognitives croissantes de manière prévisible. Si ce paradigme a déclenché la révolution de l'IA générative moderne — donnant naissance à GPT-4, Claude 3.5 et Gemini —, la frontière de la recherche en apprentissage automatique a désormais atteint un point d'inflexion critique.

Les modèles fondationnels statiques (Static Foundation Models), quel que soit leur nombre astronomique de paramètres, souffrent de limitations intrinsèques fondamentales : ce sont des prédicteurs passifs et autorégressifs du token suivant fonctionnant en boucle ouverte (open-loop). Une fois leurs poids gelés à l'issue de l'entraînement, ils sont incapables d'allouer dynamiquement du calcul supplémentaire aux problèmes complexes, de vérifier de façon autonome l'exactitude factuelle de leurs réponses, ou de corriger itérativement leurs erreurs à partir des retours de leur environnement.

flowchart LR
subgraph Paradigme_Statique ["Paradigme Statique Traditionnel (2020-2024)"]
direction TB
A1[Corpus Web Massif] --> B1[Cluster de Pré-entraînement]
B1 --> C1[Ajustement Supervisé SFT]
C1 --> D1[Modèle Statique Gelé]
D1 -->|Passe Avant Unique| E1[Réponse Textuelle Isolee]
end

subgraph Paradigme_Autonome ["Frontière Stanford CS329A : Agents Auto-Évolutifs"]
direction TB
A2[Objectif Complexe] ==> B2[Moteur de Raisonnement et Planification]
B2 -->|Actions / Ébauches de Code| C2[Environnement Sandbox et Outils]
C2 -->|Traces d'Exécution et État| D2[Vérificateurs de Processus PRM]
D2 -->|Signaux de Récompense et Erreurs| B2
D2 ==>|Mises à Jour en Inférence et Entraînement| E2[Auto-Évolution Continue]
end

Stanford CS329A pose la question centrale de la décennie d'IA à venir : Comment concevoir des agents logiciels capables non seulement de générer du texte, mais d'inspecter, de vérifier, de planifier et d'améliorer continuellement leur propre raisonnement et leur code source ?

Dans cette conférence inaugurale, nous décortiquons la trajectoire évolutive depuis les LLMs de base jusqu'aux architectures agentiques, formalisons les mathématiques des lois d'échelle et de l'allocation du calcul à l'inférence, analysons les quatre modèles fondamentaux de flux de travail agentiques et isolons le goulot d'étranglement majeur de l'intelligence autonome : l'Écart Générateur-Vérificateur (Generator-Verifier Gap).