[Stanford CS329A #4] Utilisation d'Outils et Rétroaction de Code : ReAct, RLEF et Autocorrection Constitutionnelle

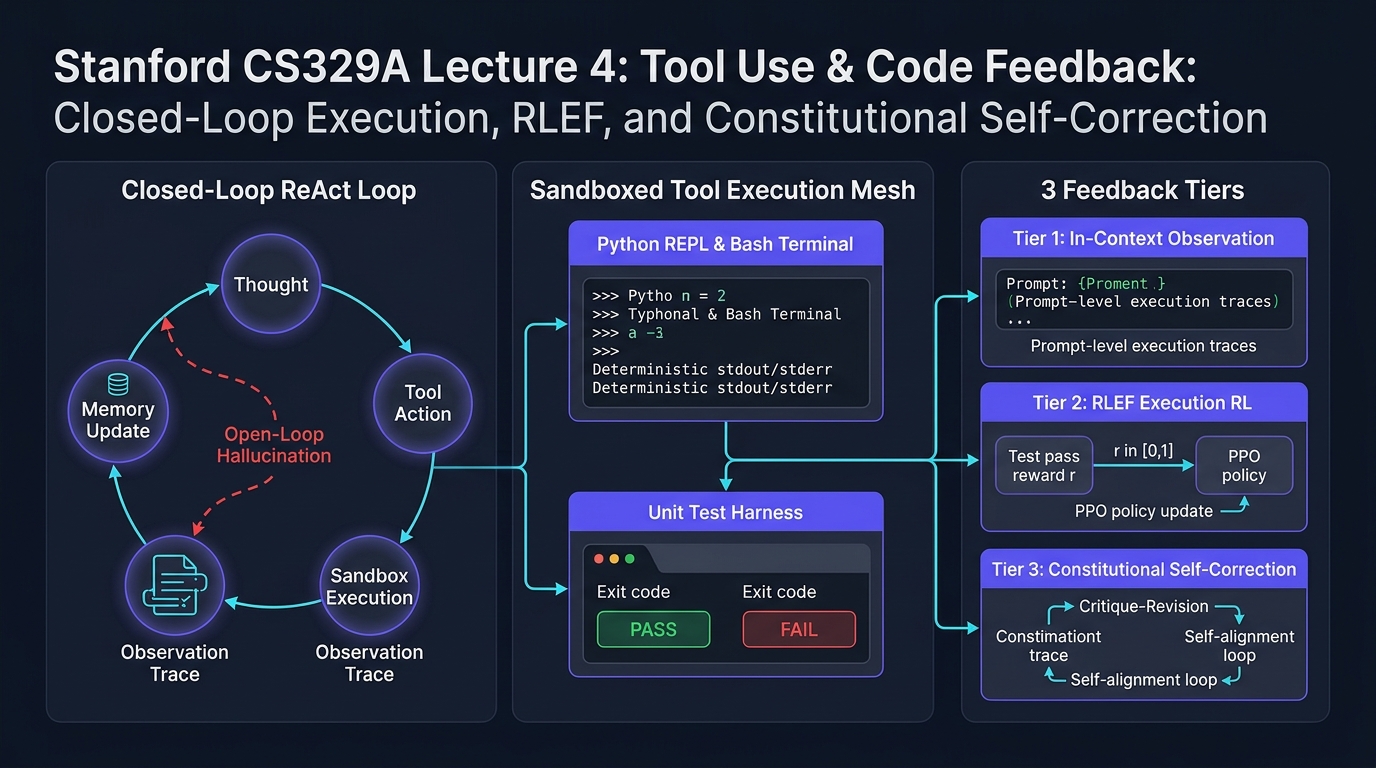
Bienvenue dans ce quatrième volet de notre série d'analyses techniques consacrée au cours de master de l'Université Stanford, CS329A: Self-Improving AI Agents (Automne 2025).
Dans les cours 2 et 3, nous avons démontré comment le passage à l'échelle du calcul lors de l'inférence (Test-time Compute Scaling) et les modèles de récompense de processus (PRM) permettent aux modèles de langage d'explorer des arbres de recherche et de vérifier étape par étape des déductions mathématiques complexes. Cependant, quelle que soit l'élégance de leurs chaînes de pensée (CoT), les modèles limités à la génération pure de texte demeurent des « étudiants isolés dans une salle d'examen fermée ». Ils dépendent exclusivement de la mémoire paramétrique statique et figée acquise durant le pré-entraînement. Face à des faits externes évolutifs, des APIs dynamiques ou des contraintes d'exécution logicielle strictes, un modèle non ancré dans l'environnement physique alucine inévitablement.
Le cours 4 marque la rupture architecturale majeure qui fait sortir le modèle de son confinement : l'utilisation d'outils (Tool Use) et les boucles de rétroaction d'exécution (Execution Feedback Loops).
Les agents autonomes modernes ne considèrent plus le code ou les appels d'API comme de simples cibles textuelles, mais comme des capteurs et des actionneurs interactifs. Dans cette leçon, nous disséquons les trois niveaux fondamentaux de rétroaction agentique :
- Rétroaction environnementale en contexte (Prompt-Level) : L'unification de la réflexion et de l'action via ReAct (Yao et al., 2022).
- Rétroaction d'exécution au niveau de la politique (Policy-Level) : L'ancrage direct des diagnostics de compilation et des tests dans les poids neuronaux via RLEF (Reinforcement Learning from Execution Feedback, 2024).
- Auto-alignement des valeurs sans supervision humaine : Le remplacement des annotateurs humains par des boucles de critique-révision guidées par des principes déclaratifs via Constitutional AI (Anthropic, 2022).
flowchart TD
    subgraph ClosedLoop ["Architecture d'Agent en Boucle Fermée (Closed-Loop)"]
        direction TB
        Agent["Cœur de l'Agent Autonome (Politique LLM)"]
        Thought["Raisonnement Interne (Espace de Pensée L)"]
        Action["Appel d'Outil Exécutable (Espace d'Action A)"]
        Sandbox["Bac à Sable Isolé (Python REPL / Shell / Search)"]
        Obs["Observation Déterministe de l'Environnement (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"Mise à jour du contexte (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["Les 3 Niveaux de Rétroaction Agentique"]
        direction TB
        T1["Niveau 1 : Rétroaction Environnementale en Contexte (ReAct)<br/>• Boucle entrelacée : Thought + Action + Observation<br/>• Taux d'hallucination factuelle ramené à 0 % en recherche"]
        --> T2["Niveau 2 : Rétroaction d'Exécution au Niveau de la Politique (RLEF)<br/>• Modélisation MDP : État, Action, Récompense Sandbox<br/>• Optimisation PPO avec séparation des tests publics et privés<br/>• Llama-3.1-70B bondit de 27,5 % à 40,1 % en 1@3 sur CodeContests"]
        --> T3["Niveau 3 : Autocorrection de Valeurs Autonome (Constitutional AI)<br/>• SFT issu de cycles de critique-révision selon des principes constitutionnels<br/>• Modèle de préférence RLAIF sans goulot d'étranglement humain<br/>• Passage à l'échelle massif de la supervision"]
    end

    ClosedLoop ==> FeedbackTiers