[マウムジギ 開発日誌 #4] ファインチューニングデータ前処理の本格稼働
· 約3分

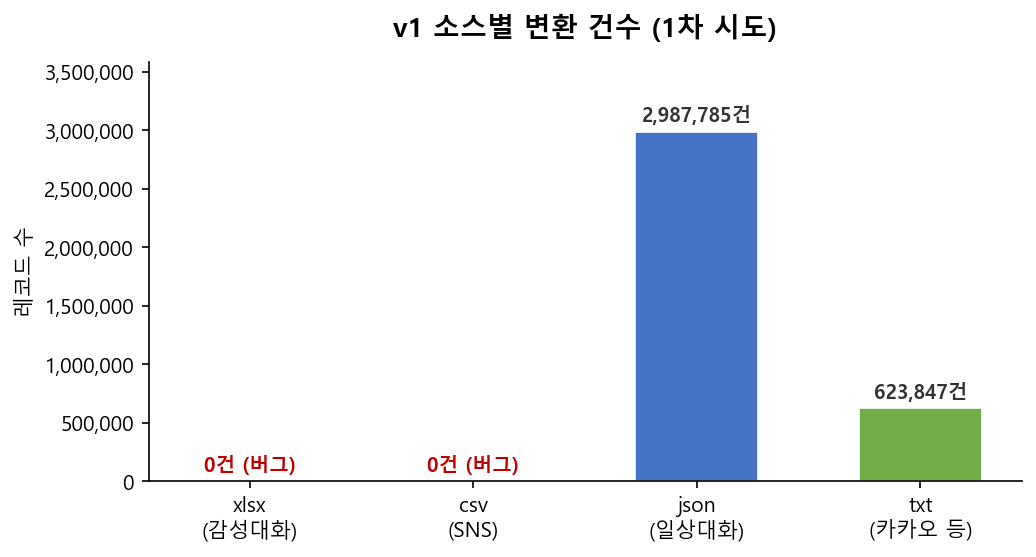
マウムジギプロジェクトの中核エンジンとなるLlama 3.1モデルを訓練するため、膨大な量の対話データをモデルが学習できる形式に加工し始めた4月1日の記録です。
データ前処理計画に基づく自動化の実行
- 問題: モデルをファインチューニングするためには、ユーザーの発話とチャットボットの応答が含まれた生データを、Llama 3.1が理解できる特殊なJSONL形式に完璧に変換する必要がありました。
- 過程:
Claude Codeへ: 「llama31_finetuning_data_preprocessing_plan_short.mdに従って作業を進行」
- 結果: 昨日作成した前処理計画書に基づき、AIエージェントが自らデータクレンジングおよび加工パイプラインを構築し、実行し始めました。人が数万件のデータをいちいち手作業で変換する代わりに、ルールが記されたMarkdown文書を1つ渡し、「この通りに処理して」と指示する方式です。
カテゴリデータの統合とJSONL変換
- 問題: 前処理過程は複数の段階(Step)に分かれており、最終的にすべてのデータを1つに統合して訓練用データセットを完成させる必要がありました。
- 過程:
Claude Codeへ: 「Step 4を実行して。2つのカテゴリデータを統合してLlama 3.1 JSONL形式に変換して。」
- 結果: AIが即座にStep 4を実行し、散らばっていた各カテゴリの対話データを1つにマージしました。そして、Llama 3.1が要求する正確なプロンプトテンプレート(System、User、Assistantの役割区分)に合わせてJSONLファイルに変換するスクリプトを作成し、実行しました。
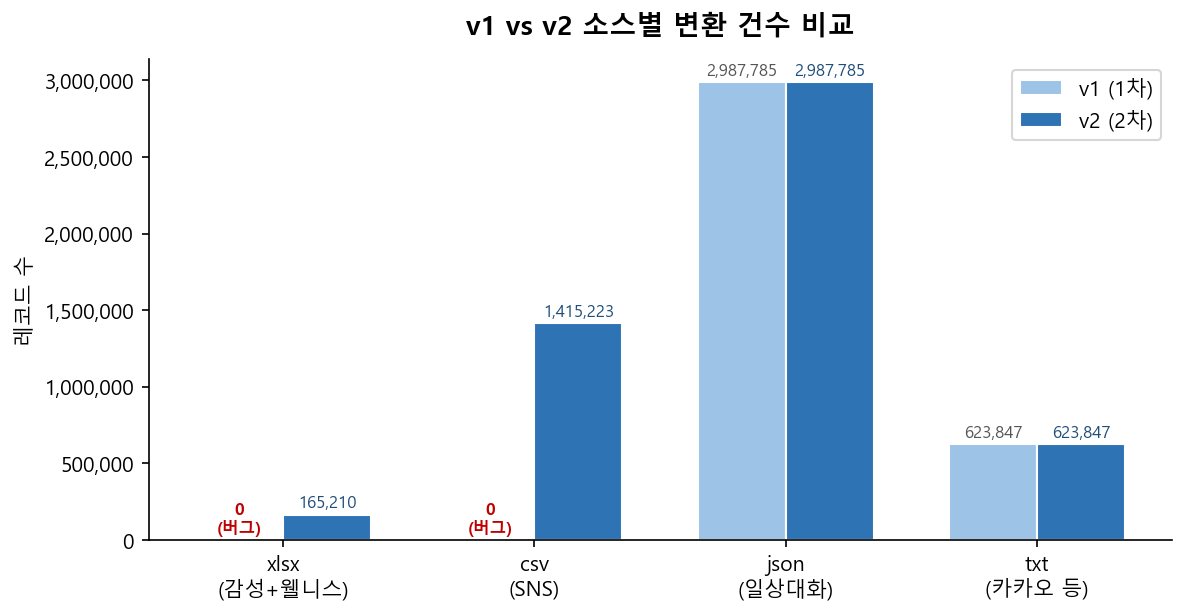
今日はファインチューニングの華とも言える「データ前処理」の過程が、AIを通じて完全自動化で回り始めた日です。「文書に書いてある通りにやって」という一言で、無数のデータが訓練可能な状態へと変貌する魔法のような体験でした。 次回の連載では、この前処理されたデータを活用して、実際にモデルをどのように訓練し検証するのか、エキサイティングな開発日誌が続きます!