[マウムジギ 開発日誌 #13] 70B学習の限界と中小型モデル(HCX, Qwen)への迂回戦略

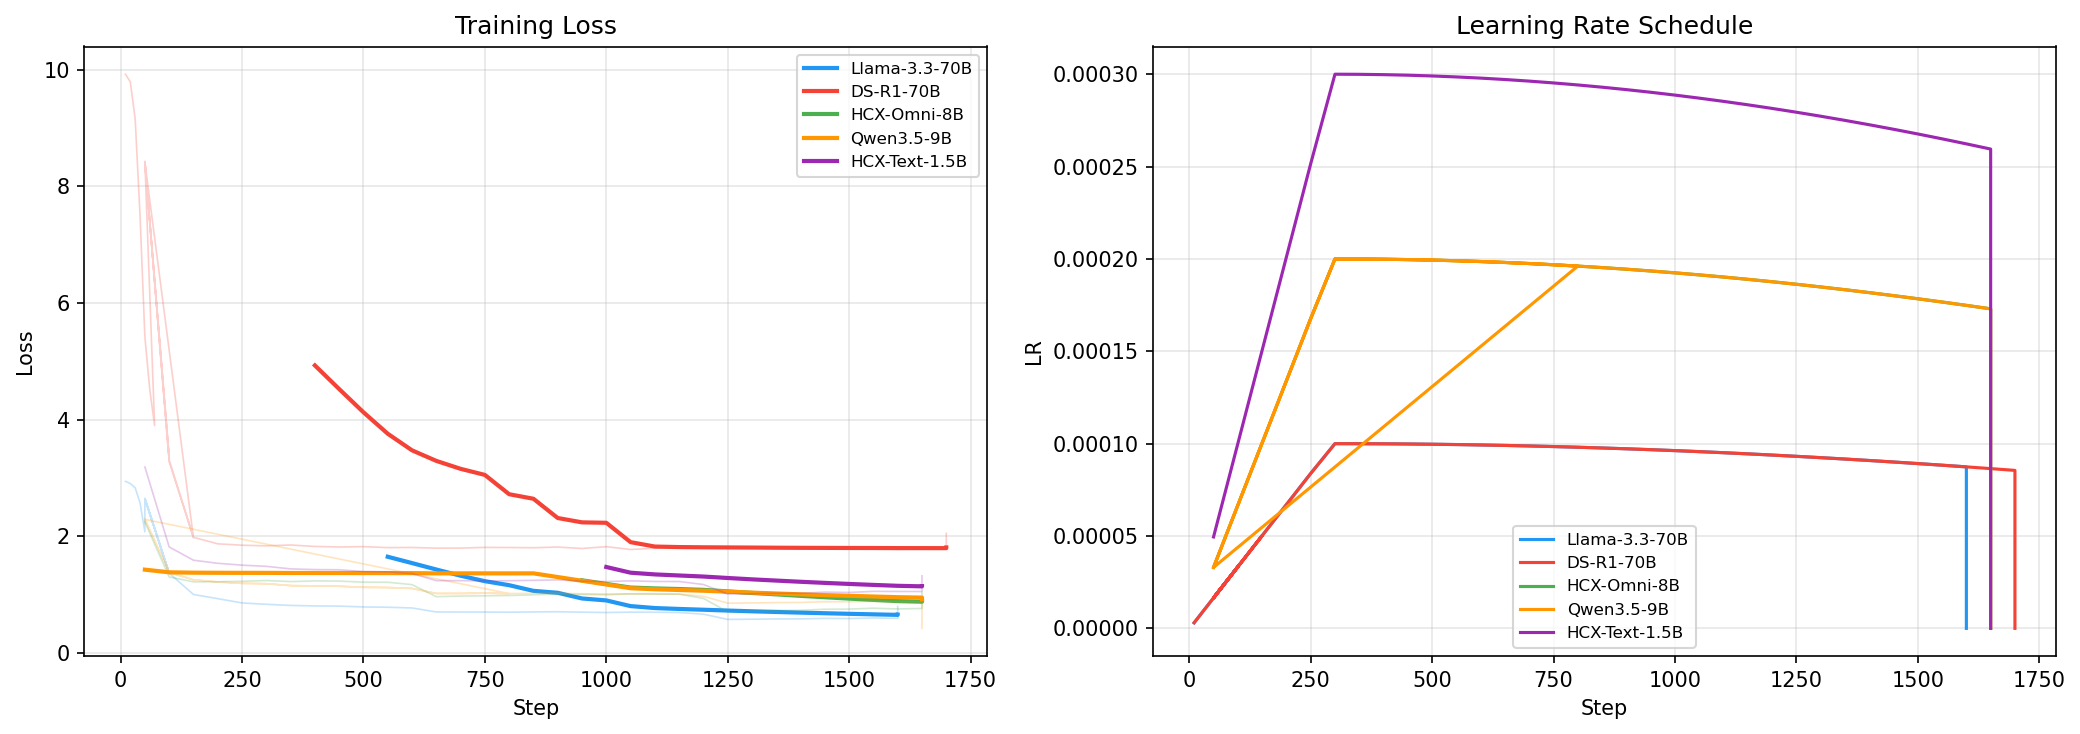
70Bという巨大なモデルのファインチューニング過程で発生したOOM(メモリ不足)の地獄を経験した5月4日、私たちは思い切った戦略変更を試みました。70Bモデル(Llama3.3, DeepSeek-R1)はバッチサイズを極端に減らして辛うじてcheckpoint-1200, 1300まで進めましたが、学習時間がかかりすぎて効率が最悪でした。
中小型モデル(1.5B〜9B)に目を向ける
物理的なサーバーリソースとキャップストーンプロジェクトの期限を考慮すると、70Bだけに固執するのは危険だと判断しました。そこで、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5Bのような比較的軽量な中小型モデルにファインチューニングの対象を変更して実験を始めました。
「現在指定したハイパーパラメータでHCX-Omni-8Bなどを学習させるのに時間がかかっているが、一般的にモデルごとにこのようなパラメータが使われるのか?」 「このバッチサイズの引き上げは学習にどのような影響を与えるのか?」
小さなモデルだからといって、すべてが順調というわけではありませんでした。高速な学習のためにバッチサイズを引き上げ、モデルサイズに合ったハイパーパラメータの最適値を探してAIと終わりのない議論を続けました。まずは最も小さなモデルであるHCX-Text-1.5Bの学習結果を抽出して性能評価を行い、チューニングの方向性を定めていきました。
チェックポイント保存エラーとカーネルバージョンの問題
HCX-Omni-8Bの学習を順調に進めていたところ、50ステップでチェックポイントを保存しようとして別の暗礁に乗り上げました。
[RANK 0] Detected kernel version 5.4.0, which is below the recommended minimum of 5.5.0...

JSONDecodeError Traceback (most recent call last)
---> 60 trainer.train(resume_from_checkpoint=...)
OSのカーネルバージョンが低いためプロセスが停止する可能性があるという警告とともに、保存されたチェックポイントのJSONファイルが破損して(JSONDecodeError)学習を再開できないという恐ろしいエラーでした。モデルサイズを小さくしたにもかかわらず、依然としてインフラストラクチャレベルで発生する数多くのエラーと格闘しながら一日を過ごしました。果たして安定した学習軌道に乗ることができるのでしょうか?