[マウムジギ 開発日誌 #16] 致命的なミスと2次ファインチューニング、そしてReact Nativeアプリ初起動

5月8日は、これまで抽出したファインチューニングの結果を基にキャップストーンデザインの中間発表資料(PPT)を作成していた日でした。しかし、気分良くスライドを埋めていたところ、背筋が凍るようなとんでもないミスを発見してしまいました。
LoRAハイパーパラメータの致命的なミスを発見
PPTに入れるモデル構造図とハイパーパラメータ情報を人工知能(AI)と一緒に手直ししていました。
「ファインチューニング結果の例を見ると、base modelよりも回答が短くなっています。これはLoRAのrを8にし、alphaを16にして中間特徴量を減らしすぎたためだと思いますが...」 「え、a/rだったの?私はr/aだと思ってたんだけど...??? 私は本当にLoRAを欲張って反映してしまったんだな...」
LoRAファインチューニング時、alpha値は通常rank値と同じか2倍にするのが定石です。ところが、計算式の適用比率を完全に逆だと勘違いし、重みの更新が極端に抑え込まれたり、過剰に跳ね返ったりするように設定してしまっていたのです。どうりでファインチューニングされたモデルの回答の長さが途切れ途切れで短くなるわけだ、原因は私の手元にありました。
2次ファインチューニング(fine_tuning_2)の決断
すでに1次結果は出ていましたが、完璧な「マウムジギ」のためにこのまま進むわけにはいきませんでした。すぐにfine_tuning_2フォルダを作成し、2次ファインチューニングを決断しました。
「今回使用するモデルはHCX-Text-1p5B, Llama33-70B, Qwen35-9Bです。MIG-0ではrankは16、alphaは16に、MIG-1ではrank=16、a=8に設定して学習を進めて。」 「Daily_train_dataset.jsonlから最も長いデータ上位2000個を抽出して、Daily_train_dataset_long.jsonlというタイトルのファイルを作成して。」
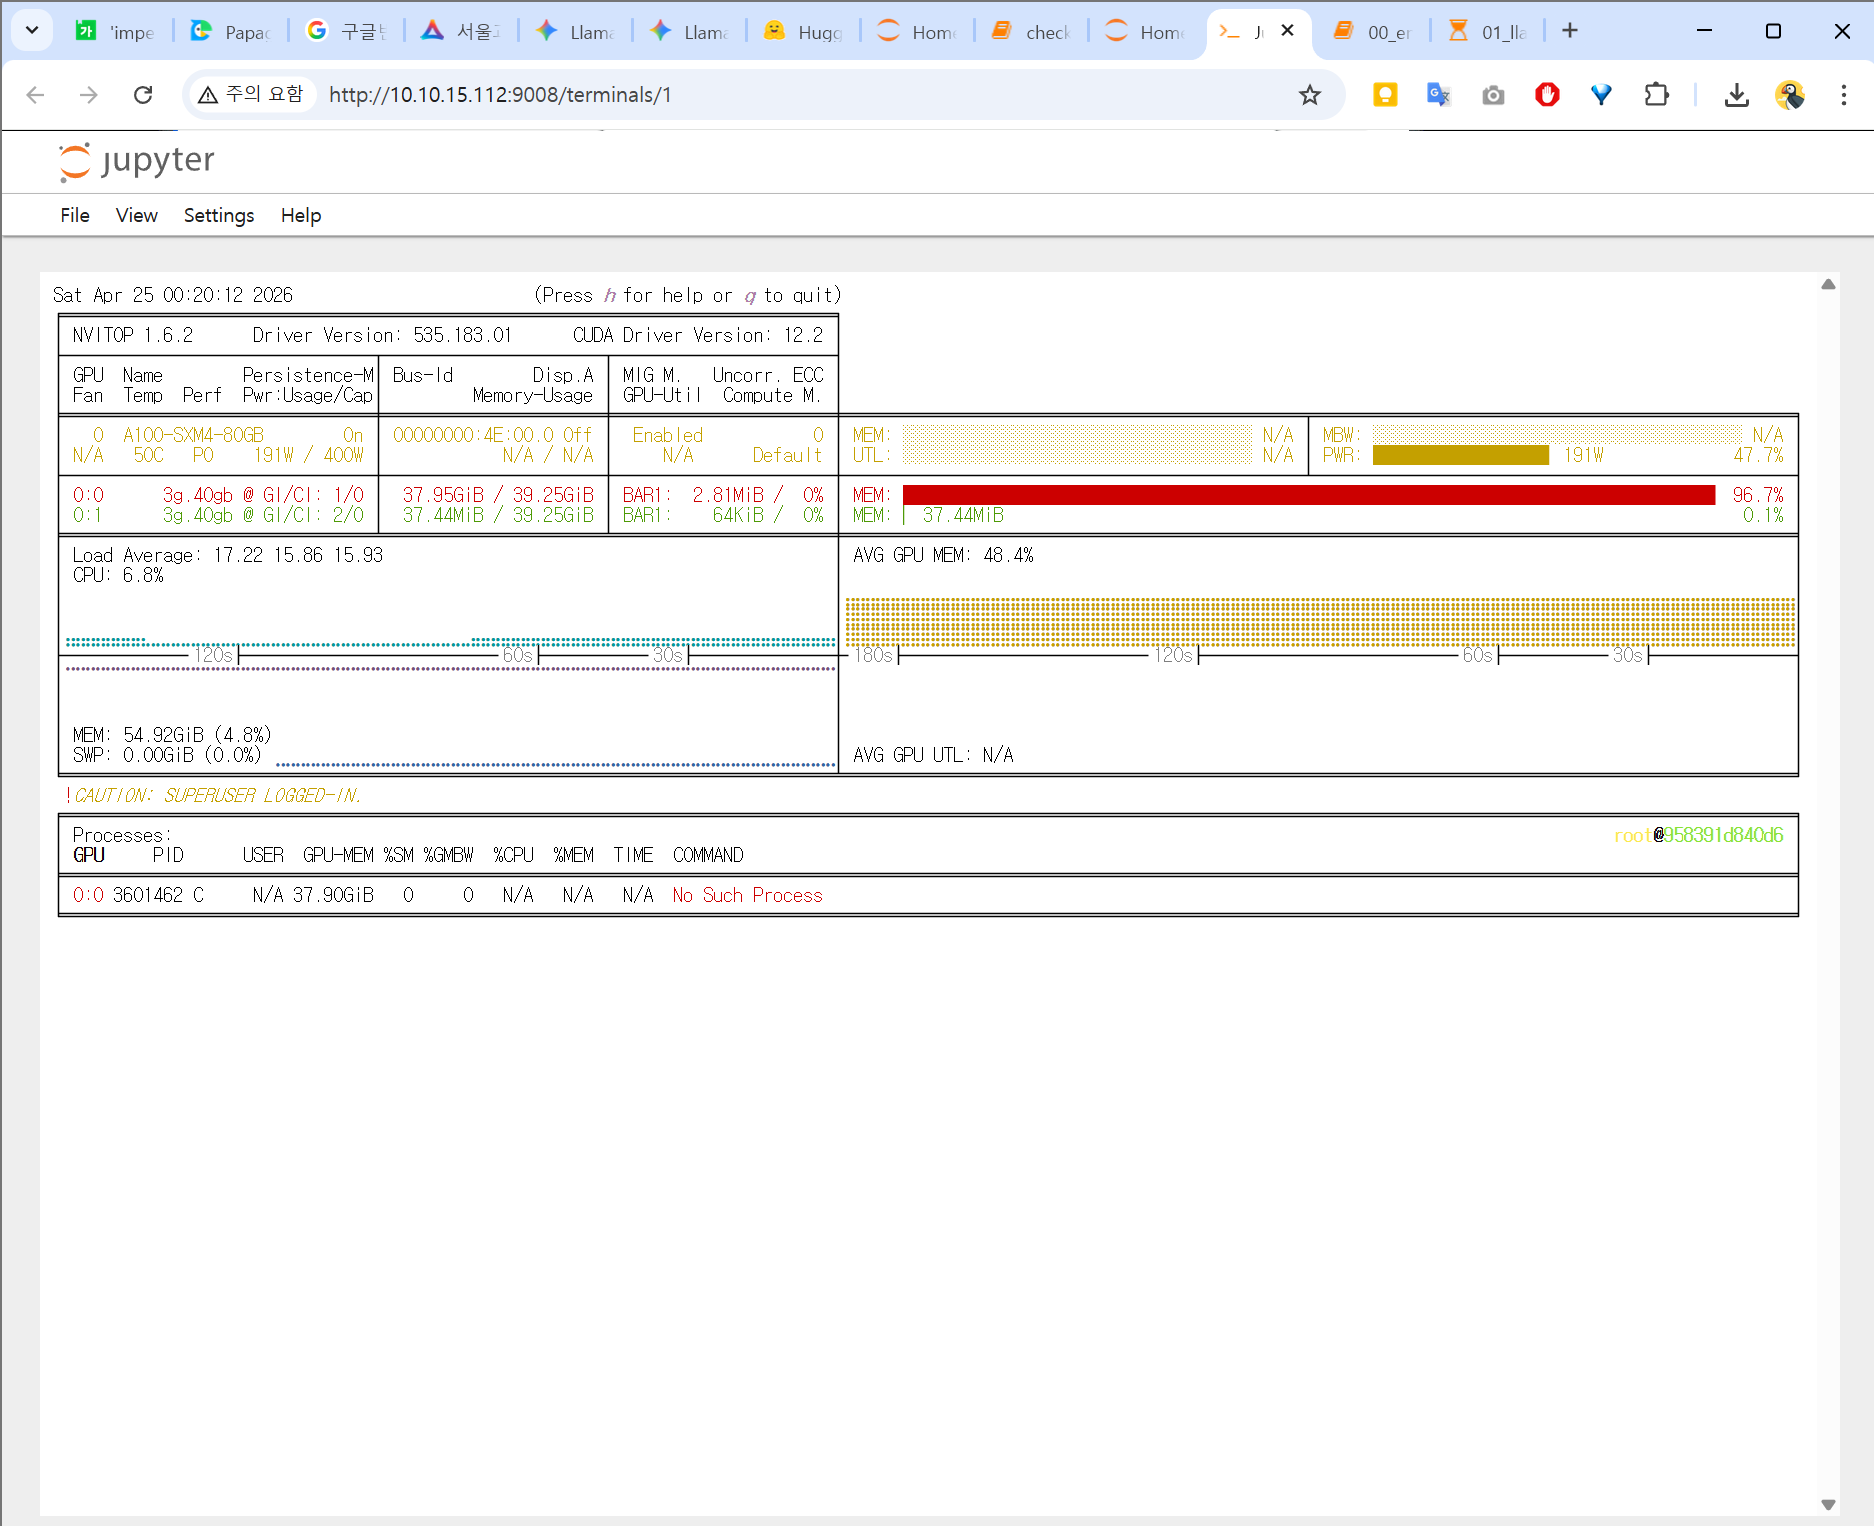
回答が短くなる現象を防ぐために、テキストの長さが最も長い上位2000個のデータセットのみを別途抽出し、MIG(Multi-Instance GPU)リソースを分割してrankとalphaの比率による性能差を直接比較する並列学習を新たに回し始めました。
バックエンドモデルが回っている間、フロントエンド(アプリ)開発に着手
モデルが再び学習のサイクルに入っている間、私はただ手をこまねいていたわけではありません。ついに実際のユーザーが「マウムジギ」に出会うことになるフロントエンドアプリの開発に着手しました!
「maeum-appを起動するためにQRコードを表示しなければならないんだけど... npx go startと入力してもエラーメッセージしか表示されない。どうやって、そしてどこにQRコードが表示されるのかな?」
React Native(Expo)を使ってmaeum-appプロジェクトを作成し、ローカルサーバーを立ち上げてスマートフォンと接続しようと奮闘しました。見当違いにnpx go startと打ち込んで迷ったりもしましたが、ついにExpoのQRコードを表示し、アプリアイコン(assets/logo.png)を設定することに成功しました。バックエンドの頭脳(AI)とフロントエンドの顔(App)が同時に作られていく、胸が熱くなる一日でした。