[マウムジギ 開発日誌 #17] 2次ファインチューニング完了と評価自動化パイプラインの罠

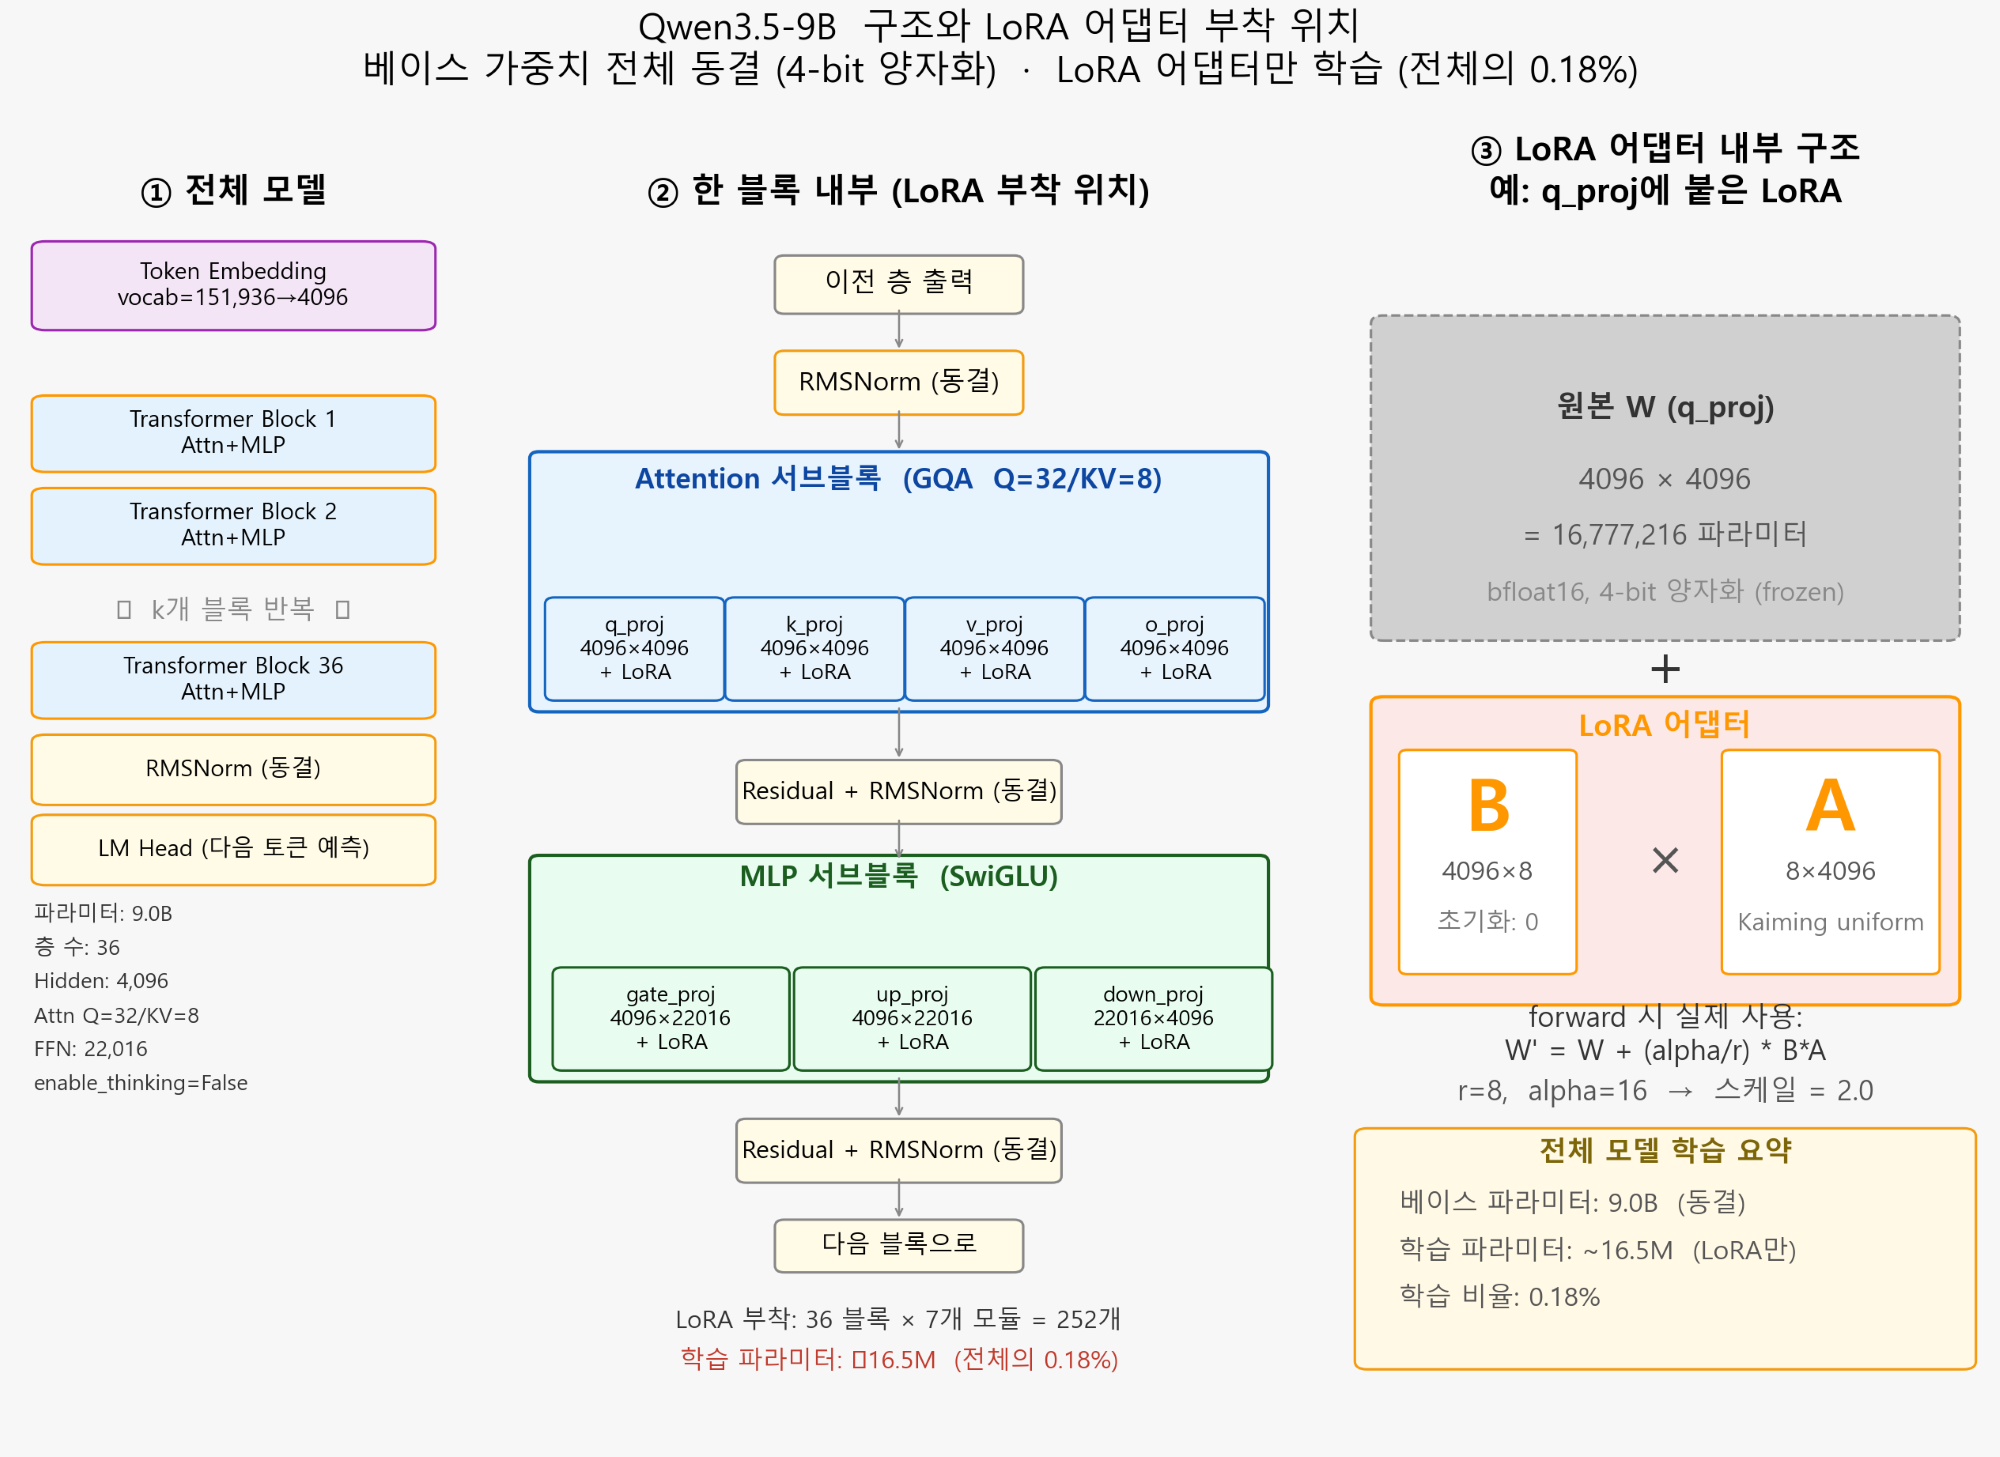
LoRAハイパーパラメータのミス(alpha/rank設定エラー)を正すために野心的に始めた2次ファインチューニング(fine_tuning_2)並列学習が、5月12日ついに終わりました!
Bestチェックポイント抽出と推論パイプラインの構築
3つのモデルに対して6つのハイパーパラメータの組み合わせで回したファインチューニングがすべて完了しました。すぐにeval_lossを比較して最も性能が良い最高(Best)のチェックポイントを抽出し、モデルごとのadapterフォルダに移す作業を進めました。
「現在HCX-Text-1p5Bモデルが15分間で12個生成しました。GPU Utilは各グラフィックカードにつき1.6GB...」
しかし、推論速度は依然として絶望的でした。最も軽い1.5Bモデルでさえ、1分間に1つの回答も作成できていませんでした。VRAM使用量は1.6GBしかないのに、バッチサイズが1に設定されているためボトルネックが発生したのです。さらにサーバーの容量不足問題まで重なり、プロジェクトの基本パスを急いで移行する騒動もありました。
ハードコーディングの罠に陥る
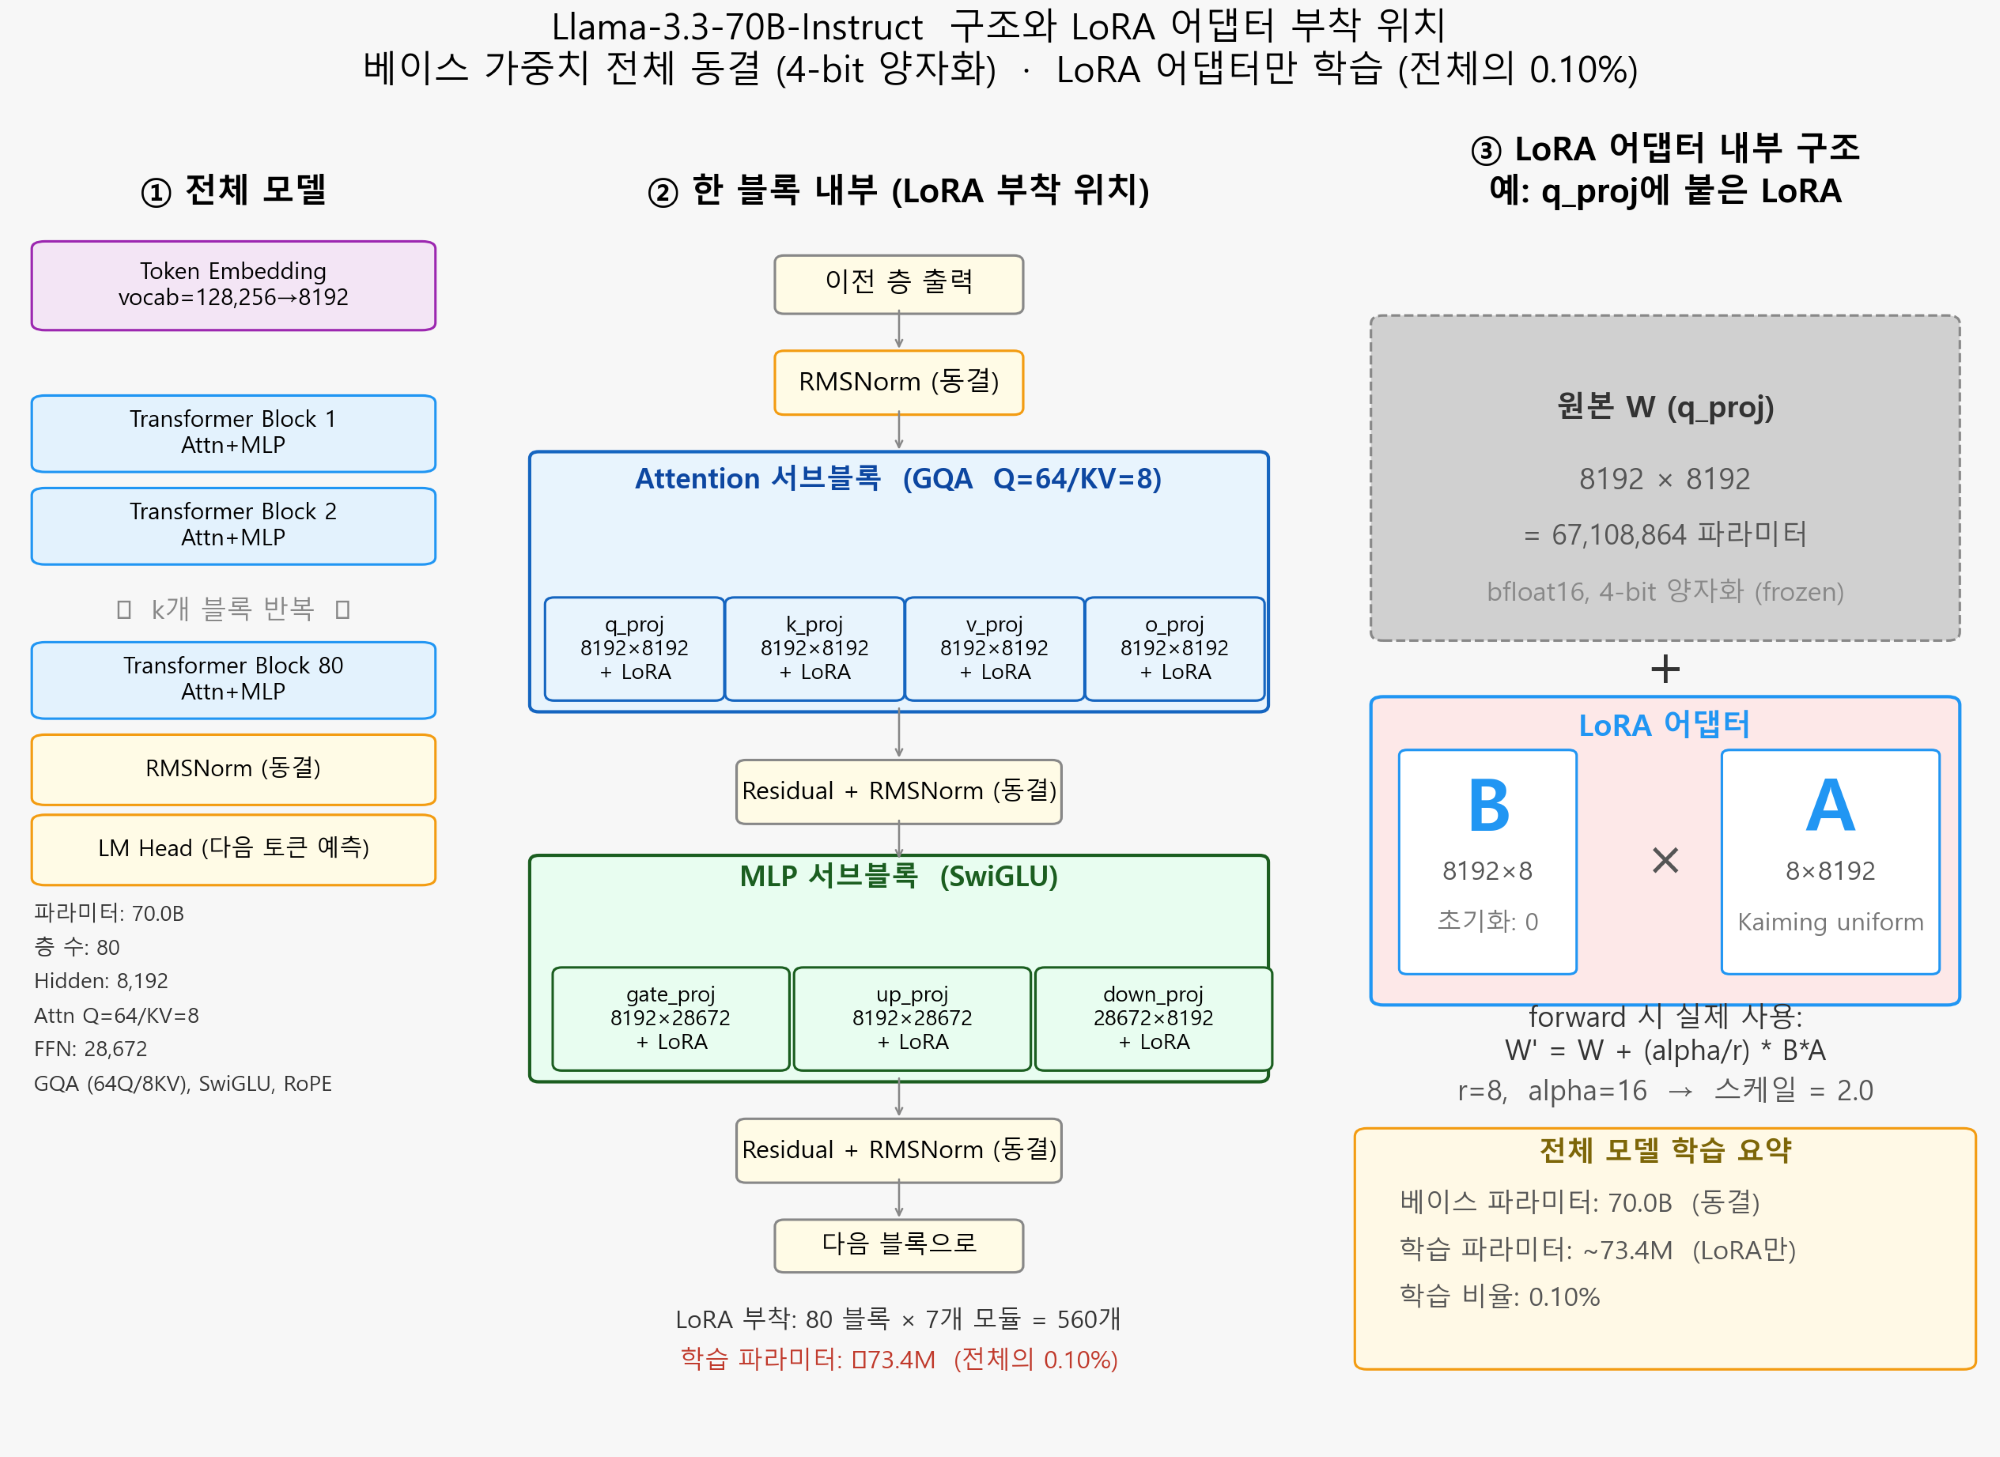
そうやって苦労して評価コードをすべて回した後、鳥肌が立つような事実を発見しました。
「なぜ20_eval_ft_models.ipynbのMODEL_ALIAS = 'Qwen35-9B_a16'のように1つのモデルにハードコーディングされているのか?」 「ファイル名とモデル名が違うのが正常だということ?」
そうです。評価自動化スクリプトを作成する際に、誤ってMODEL_ALIASをハードコーディングしてしまったのです。HCXモデルをテストすると言ってファイルを一生懸命コピーして回していましたが、実際のコード内ではずっとQwen35-9B_a16モデルばかりを呼び出して、同じ推論を繰り返していたのです!明日このバグを修正して推論をやり直さなければなりません。